תובנות AI לגבי מגמות בשוק המניות: פיצוח הקוד עם Lazy Prices
בפרויקט שלנו חקרנו את הפוטנציאל של AI בניתוח שוק המניות, תוך התמקדות ספציפית בחיזוי שינויים במחירי מניות בהתבסס על ניתוח טקסט של דוחות כספיים של חברות. השתמשנו בטכניקות כגון איסוף נתונים (data scraping), ניקוי טקסט וחישוב דמיון כדי להעריך את המתאם בין דמיון דוחות לביצועי מניות.

טכנולוגיות
צורך עסקי
בינה מלאכותית עברה מלהיות חידוש טכנולוגי לתת-תחום טכנולוגי המתפתח באופן דינמי. רוב החברות, בתכנון הצמיחה שלהן, מחליטות על הטרנספורמציה לעסק מה שנקרא "data driven". משמעות הדבר היא מעבר מקבלת החלטות מבוססת מומחיות בלבד בעיקרה ל קבלת החלטות מבוססת נתונים.
לאור ההצלחה הגוברת של מודלי AI, רבים ניסו את כוחם בשימוש בו לחיזוי מחירי מניות. היכולת ליצור אלגוריתם המנבא את מחירה של מניה נתונה ומאפשר למשתמש להתעשר במהירות הציתה את דמיונם של מדעני נתונים במשך שנים רבות.
לאורך הזמן, חרף השימוש בשיטות רבות ושונות, לא נוצר אלגוריתם המספק אסטרטגיה מנצחת לטווח ארוך בשוק המניות. רוב השיטות התבססו על ניסיון להתאים אלגוריתמים נבחרים למשתנים היסטוריים כגון מחירי מניות, שערי חליפין או מחירי סחורות כמו זהב או בשר.
כחלק מ'הוכחת ההיתכנות' שנבנתה לצורכי החברה, ניסינו גם לבחון את האפשרות לחזות אילו מניות יעלו או ירדו בערכן. הניתוח שלנו, עם זאת, התבסס על ניתוח הטקסט.
כל החברות הנסחרות בארה"ב מחויבות לפרסם דוחות רבעוניים ושנתיים המתארים את מצבן הפיננסי. לדוחות יש מבנה מחייב המגדיר אילו פרקים יש לכלול בהם.
במהלך שנה מפרסמות החברות שלושה דוחות רבעוניים (המכונים 10-Q) ודוח שנתי אחד (המכונה 10-K). דוחות שוק ההון אינם קריאה קלה או נעימה. הם ארוכים באופן מפחיד. הדוח השנתי האחרון של מיקרוסופט היה באורך 130 עמודים.
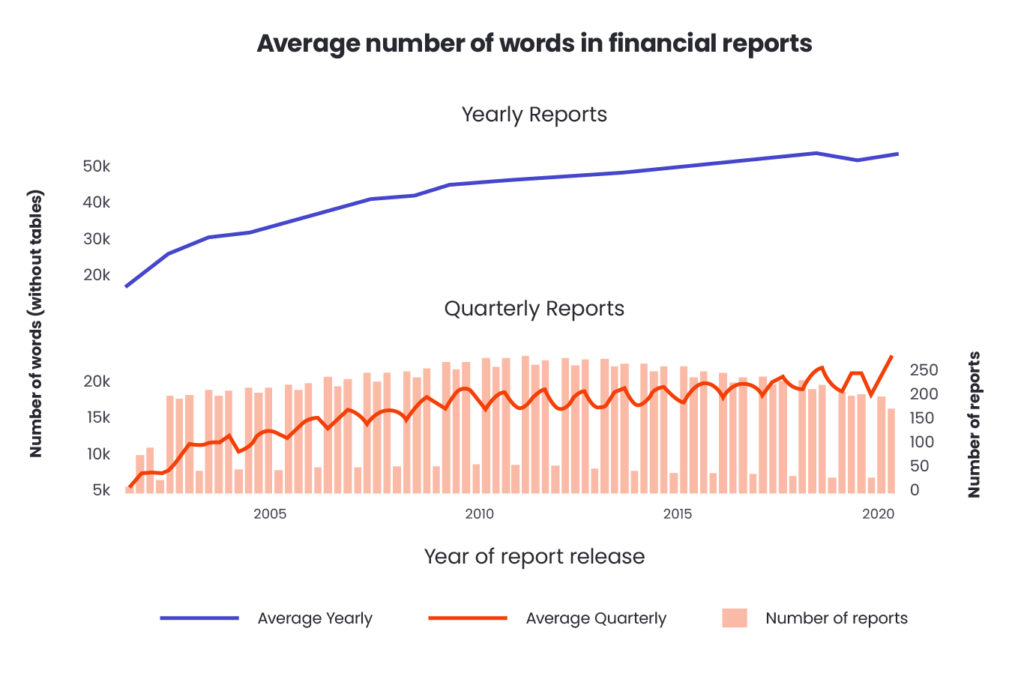
השפה שבה הם כתובים היא רשמית, משפטית וחזרתית מאוד. בנוסף, האורך הממוצע של דוחות, במונחים של מספר המילים המשמשות, עולה כמעט בכל שנה, כפי שמוצג בתרשים שלהלן.
עבור אנליסטים בשוק ההון, נתונים פיננסיים הם בעלי חשיבות מכרעת שכן הם מספקים מידע על רווח או הפסד ומוצגים בטבלאות ברורות.
ייתכן שאלו העובדות היחידות שיבחין בהן אנליסט בשוק ההון שיש לו כמה עשרות דוחות בני 100 עמודים לקרוא בסוף השנה.
שלושה כלכלנים: לורן כהן, כריסטופר מלוי מבית הספר לעסקים של הרווארד, וקווק נגוין מאוניברסיטת דה-פול, מציינים בעבודתם בשם 'Lazy Prices‘ שבאמצעות השוואת דוחות שוק המניות, אנו יכולים לחזות ירידה או עלייה במחירי המניות של חברה נתונה.
החוקרים השתמשו בטכניקות של ניתוח טקסט כדי לחשב את קווי הדמיון בין דוחות SEC. הם הוכיחו את ההשערה שלפיה חברות שהדוחות שלהן דומים במידה רבה לגרסאות מהשנה הקודמת ירשמו עליות בשוק המניות.
בקצה השני של הסקאלה, חברות שהדוחות שלהן מכילים פערים רבים חשופות לירידות מחירים עתידיות או אפילו לפשיטת רגל. ניתן לפרש זאת גם כהשערה שחברות יציבות יצליחו יותר בשוק המניות.
על מנת להשוות דוחות, חוקרים משתמשים במדדים המחשבים דמיון טקסטואלי, כגון דמיון קוסינוס ודמיון ג'קארד.
השירותים שלנו
רצינו לאמת את ההשערה שהציגו החוקרים. לכן החלטנו להוריד אלפי דוחות של שוק המניות. באמצעות שיטות NLP, ערכנו ניתוח משלנו כדי לאשר את הנחת היסוד של ההשערה.
איסוף וניקוי נתונים
בשלב הראשוני נכתב סקרייפר אוטומטי, שהוריד דוחות מלמעלה מ-200 חברות שנבחרו באקראי מהבורסה האמריקאית מ-20 השנים האחרונות.
בשלב הראשוני של ניתוח טקסט, מבוצעים לעתים קרובות שלבים לניקוי הטקסט ולהפחתת הופעות של מילים נדירות. כמה מהשיטות הבסיסיות המאפשרות לקבל תוצאות טובות יותר בניתוח הבא הן:
א) פעולת stemming משאירה רק את שורש המילה; מטרתה להמיר מילה המופיעה בווריאציות שונות לאותה צורה. דוגמה לכך עשויה להיות צמצום כל אחת מהמילים "fly", "flying", "flies" למילה אחת "fly",
ב) הסרת מילות עצירה – זהו נוהג נפוץ להסיר מילים המופיעות לעתים קרובות מאוד ואינן מוסיפות מידע נוסף לטקסט. במיוחד בעת ניתוח טקסט באנגלית, חשוב להסיר מילים כמו "the", "a", "an",
ג) הסרת סימני פיסוק,
ד) המרת אותיות רישיות לאותיות קטנות.
חישוב מדדי דמיון
לאחר ניקוי הטקסט בכל הדוחות, נעבור לחישוב מדדי הדמיון.
חישוב הדמיון בין שני מסמכי טקסט הוא משימה נפוצה ב-NLP ויש לו שימושים מעשיים רבים. שיטה זו משמשת, למשל, למיקום התוצאות במנוע חיפוש או להמלצה על תוכן דומה לקוראים.
השגת ערך מספרי בודד המעיד על מידת הדמיון בין שני המסמכים מקלה משמעותית ומאיצה תהליכים רבים הקשורים לניתוח נתונים. קיימים אלגוריתמים רבים שמטרתם לחשב את הדמיון בין מסמכים. חלקם פועלים על בסיס מספר המילים הזהות במסמכים, בעוד שאלגוריתמים אחרים, מתקדמים יותר, בונים הבנה של תוכן המסמכים וממקמים טקסטים דומים זה לזה במרחב וקטורי שאומן מראש.
בפרויקט שלנו השתמשנו בשני מדדים ששימשו גם בפרסום 'Lazy Prices'. אלו היו מדד הקוסינוס ומדד Jaccard.
דמיון קוסינוס הוא מדד לדמיון בין שני וקטורים במרחב יחידה נתון. הוא מתבטא בערך הקוסינוס של זווית המוגדרת על ידי שני וקטורים וקובע באיזו מידה הם מכוונים לכיוון דומה.
מקדם Jaccard מודד את הדמיון בין קבוצות על ידי חישוב המנה של מספר האלמנטים המשותפים לסכום שתי הקבוצות.
על מנת להשתמש במדד הקוסינוס ובמדד Jaccard לחישוב הדמיון בין מסמכים, יש למפות אותם למרחב וקטורי.
לשם כך, נאספים כל המילים המופיעות בלפחות דוח מניות אחד. לאחר מכן, כל דוח מומר לוקטור המייצג מספרים המתאימים למספר הפעמים שמילה נתונה מופיעה בדוח הנבחן.
הווקטורים שנוצרו בדרך זו משמשים לחישוב שני מדדי הדמיון.
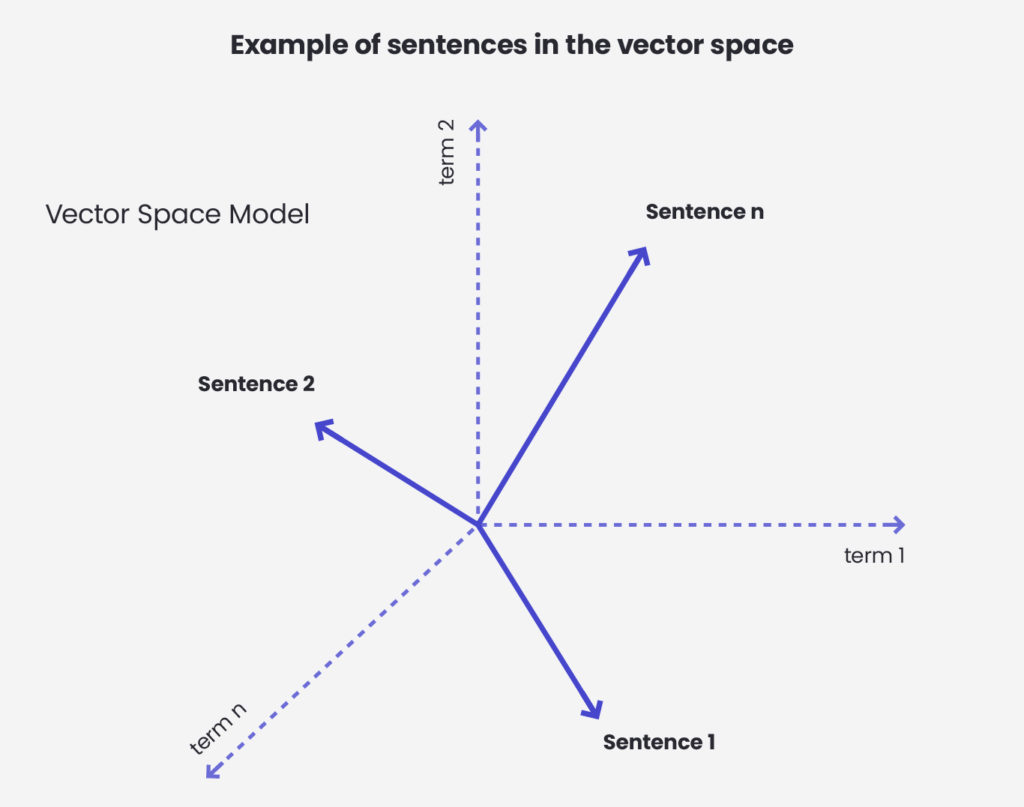
בתמונה למעלה ניתן לראות דוגמה שבה משפטים מוקרנים על מרחב וקטורי. כדי לחשב את דמיון הקוסינוס של שני משפטים, נחשב קוסינוס בין הווקטורים המתאימים להם.
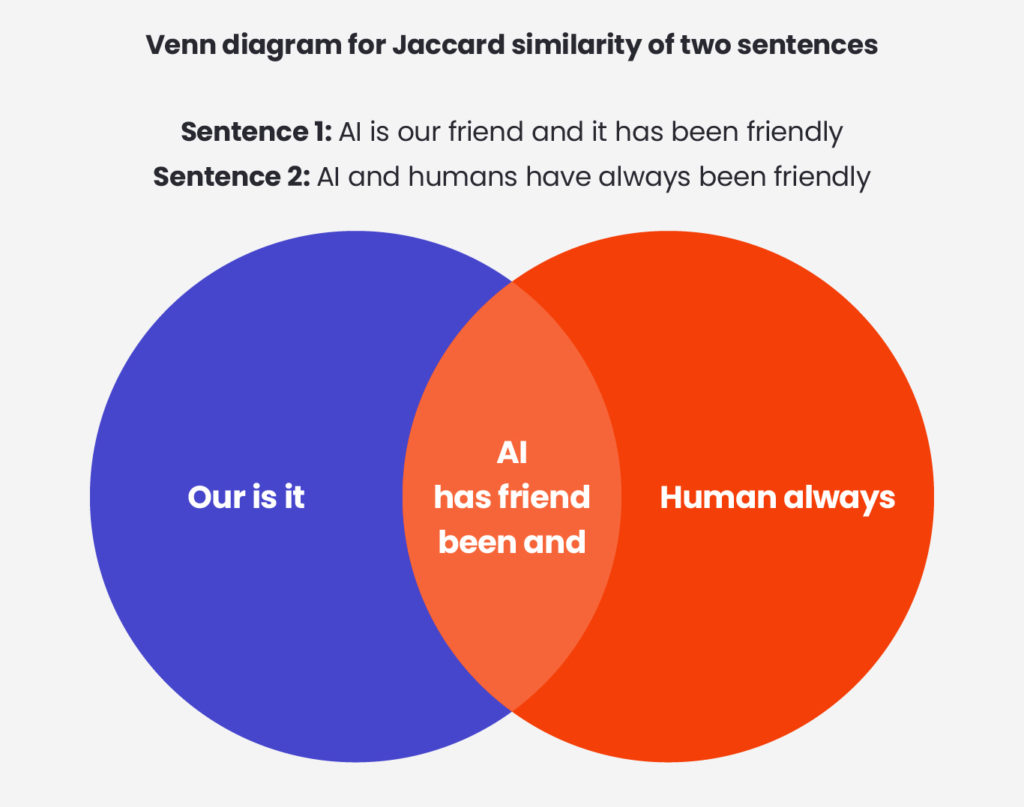
להלן נציג כיצד מחושבת Jaccard Similarity. עבור שני משפטים אנו מחשבים את המנה של מספר המילים המשותפות חלקי מספר כל המילים הייחודיות בשני המשפטים.
ניתוח שינויי מחירים
על מנת לבדוק את המתאם בין הדמיון של דוחות משנים עוקבות לבין מצבה הפיננסי של החברה, נאספו המחירים ההיסטוריים של כל החברות שנבחנו, החל מתאריך הפרסום של הדיווח הוותיק ביותר ל-SEC.
כל הדוחות קובצו לכאלה עם דמיון קטן (מתחת לאחוזון ה-10), בינוני (בין האחוזון ה-10 ל-80) וגדול (מעל האחוזון ה-80). בכל תקופת דיווח, ערכי האחוזונים הרלוונטיים חושבו על ידי נרמול בהתאם לדמיון של כל הדוחות מאותה תקופה.
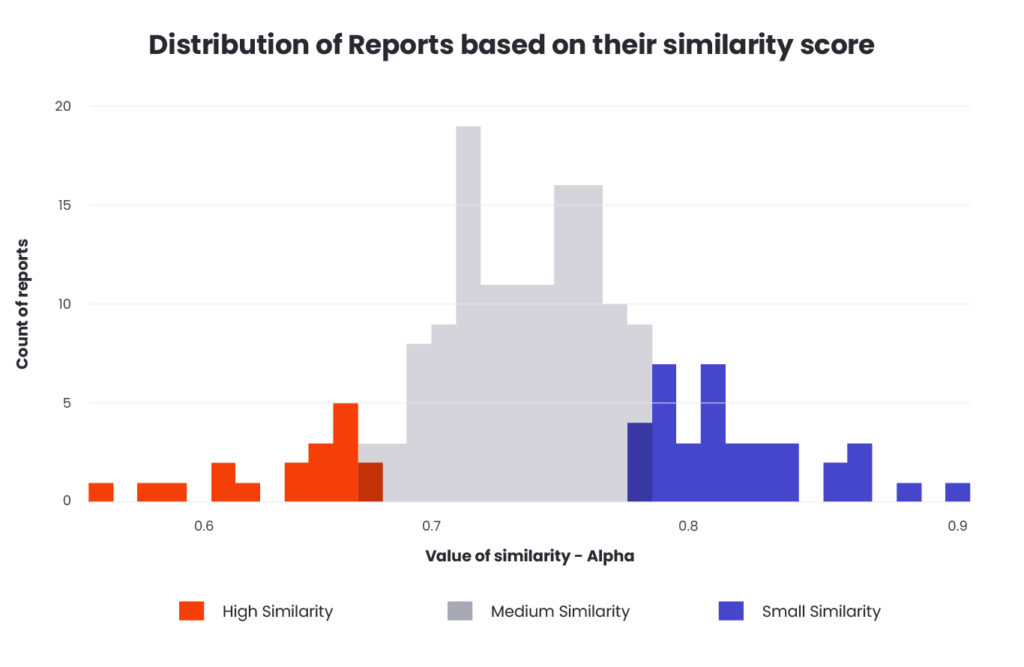
על פי 'Lazy Prices', כדי להבחין בשינויים במצב החברה, יש להמתין שלושה חודשים לאחר רכישת מניה נתונה, שאנו עושים חודש לאחר פרסום דוח. על בסיס זה, נבחן את ההשערה על ידי חישוב התשואה הפוטנציאלית על רכישת מניה נתונה ביום פרסום הדוח ומכירתה לאחר שלושה חודשים.
בשלב הבא, נחשב את התשואות הממוצעות עבור כל אחת מקבוצות המניות (דמיון נמוך, בינוני וגבוה). בהנחה שההשערה נכונה, אנו מצפים לעליות בקבוצת הדמיון הגבוה ולירידות בקבוצת הדמיון הנמוך.
התוצאות
הצגנו את הניתוח כאפליקציה אינטראקטיבית שנכתבה באמצעות ספריית Streamlit. הגרפים מציגים את התשואות הממוצעות 1, 2, 3, 4, 5 ו-6 חודשים לאחר רכישת המניה. בהתאם לאסטרטגיה שנקבעה, אנו מתמקדים בתשואה לאחר החודש השלישי. צבע הקווים מציין את קבוצת הדמיון.
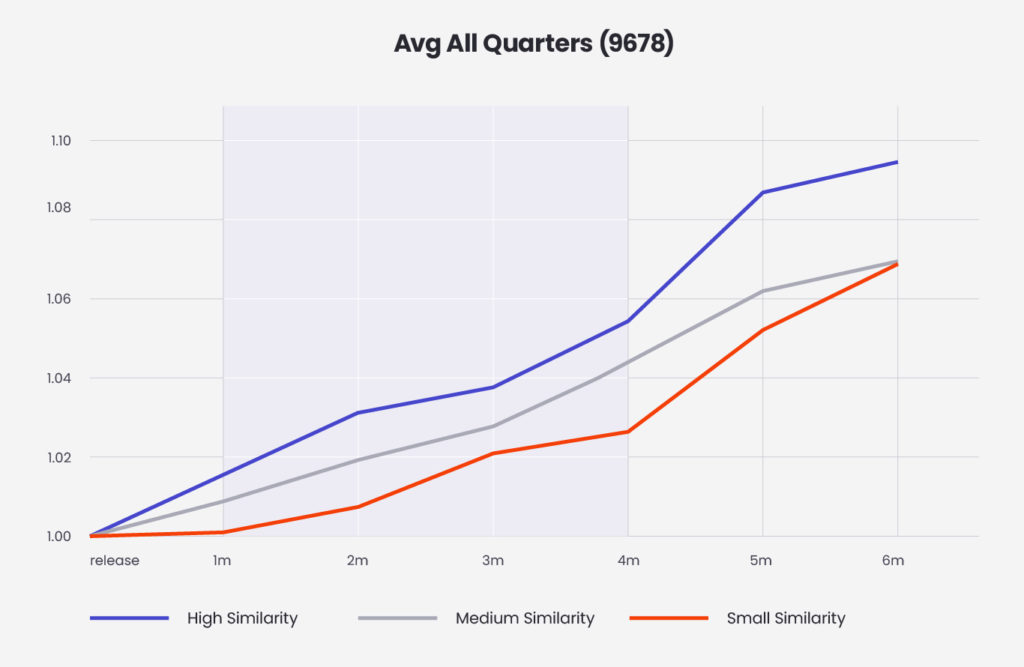
בגרף אנו רואים תשואה חיובית ללא תלות בקבוצת הדמיון של הדוחות. אנו קונים מניה ב-"1m" – חודש לאחר פרסום הדוח. אנו מוכרים את המניה ב-"4m" – שלושה חודשים לאחר הרכישה. הסיבה לכך היא שהניתוח בוצע על נתוני שוק הון היסטוריים מ-20 השנים האחרונות. בתקופה זו, בממוצע, כל המניות רשמו עלייה במחירים. לפיכך, קשה למצוא תת-קבוצה של מניות שהייתה יורדת אם הייתה ממוצעת.
מה שמעניין, לעומת זאת, הוא ההבדל הברור בין הקבוצות. מניות של חברות, שהדוחות שלהן היו דומים מאוד, השיגו רווח גבוה ביותר מ-3 נקודות אחוז לאחר 3 חודשים, מה שמרמז שההשערה שהועלתה ב'Lazy Prices' עשויה להיות נכונה.
מפתיע גם שהצלחנו להשיג תוצאות כאלה תוך שימוש בטכניקות בסיסיות מאוד למדידת הדמיון של הטקסט. הצעדים הבאים שיכולים לשפר את איכות החיזוי שלנו של חברות בצמיחה עשויים להיות הצגת מדדים מתקדמים המבוססים על אלגוריתמים כגון word2vec או transformers. בנוסף, במקום לחשב תשואות היסטוריות, אנו עשויים לנסות לבנות מודל ML אשר, תוך שימוש בערכים של מדדי דמיון שונים, ינסה לפתור את בעיית הרגרסיה ולחזות את הערך המדויק של שינוי מחיר המניה לאחר שלושה חודשים.
מעניין אותך ללמוד עוד או שיש לך פרויקט AI שנוכל לסייע בו? צרו קשר עם הצוות שלנו באמצעות הטופס שלמטה.
arrow_circle_right מקרי בוחן
קראו את סיפורי ההצלחה של הלקוחות שלנו


arrow_circle_rightבינה מלאכותית ולמידת מכונה
מעוניינים לשתף איתנו פעולה?
צרו קשר.
Tomasz Smolarczyk
מנהלת בינה מלאכותית