رؤى الذكاء الاصطناعي حول اتجاهات سوق الأسهم: فك الشفرة باستخدام Lazy Prices
في مشروعنا، بحثنا في إمكانات الذكاء الاصطناعي في تحليل سوق الأسهم، مع التركيز تحديدًا على التنبؤ بتغيرات أسعار الأسهم بناءً على التحليل النصي للتقارير المالية للشركات. واستخدمنا تقنيات مثل استخلاص البيانات وتنظيف النصوص وحساب التشابه لتقييم العلاقة بين تشابه التقارير وأداء الأسهم.

التقنيات
الاحتياج التجاري
تحول الذكاء الاصطناعي من كونه مجرد تطور تقني جديد إلى قسم تقني ديناميكي التطور. معظم الشركات، عند تخطيطها لنموها، تقرر التحول إلى ما يسمى "الأعمال القائمة على البيانات". وهذا يعني التحول من اتخاذ القرارات الخبيرة البحتة إلى اتخاذ القرارات المعتمدة بشكل رئيسي على اتخاذ القرارات القائمة على البيانات.
نظراً للنجاح المتزايد لنماذج الذكاء الاصطناعي، حاول العديد من الأشخاص استخدامها للتنبؤ بأسعار الأسهم. إن القدرة على إنشاء خوارزمية تتنبأ بسعر سهم معين وتتيح للمستخدم الثراء السريع قد أثارت مخيلة علماء البيانات لسنوات عديدة.
مع مرور الوقت، وعلى الرغم من استخدام العديد من الأساليب المختلفة، لم يتم إنشاء أي خوارزمية توفر استراتيجية رابحة طويلة الأجل في سوق الأسهم. استندت معظم الأساليب إلى محاولة مطابقة خوارزميات مختارة مع متغيرات تاريخية مثل أسعار الأسهم أو أسعار الصرف أو أسعار السلع مثل الذهب أو اللحوم.
كجزء من "إثبات المفهوم" المبني لاحتياجات الشركة، حاولنا أيضًا فحص إمكانية التنبؤ بالأسهم التي ستكسب أو تفقد قيمة. غير أن تحليلنا كان مبنيًا على تحليل النص.
يُطلب من جميع الشركات المدرجة في الولايات المتحدة نشر تقارير ربع سنوية وسنوية تصف حالتها المالية. وللتقارير هيكل مفروض يحدد الفصول التي ينبغي تضمينها فيها.
على مدار العام، تنشر الشركات ثلاثة تقارير ربع سنوية (تُسمى 10-Q) وتقريرًا سنويًا واحدًا (يُسمى 10-K). وليست تقارير سوق الأسهم قراءة سهلة أو ممتعة. فهي طويلة بشكل مخيف. كان آخر تقرير سنوي لشركة Microsoft بطول 130 صفحة.
اللغة التي كُتبت بها رسمية وقانونية وتكرارية للغاية. بالإضافة إلى ذلك، يزداد متوسط طول التقارير، من حيث عدد الكلمات المستخدمة، عمليًا كل عام، كما هو موضح في الرسم البياني أدناه.
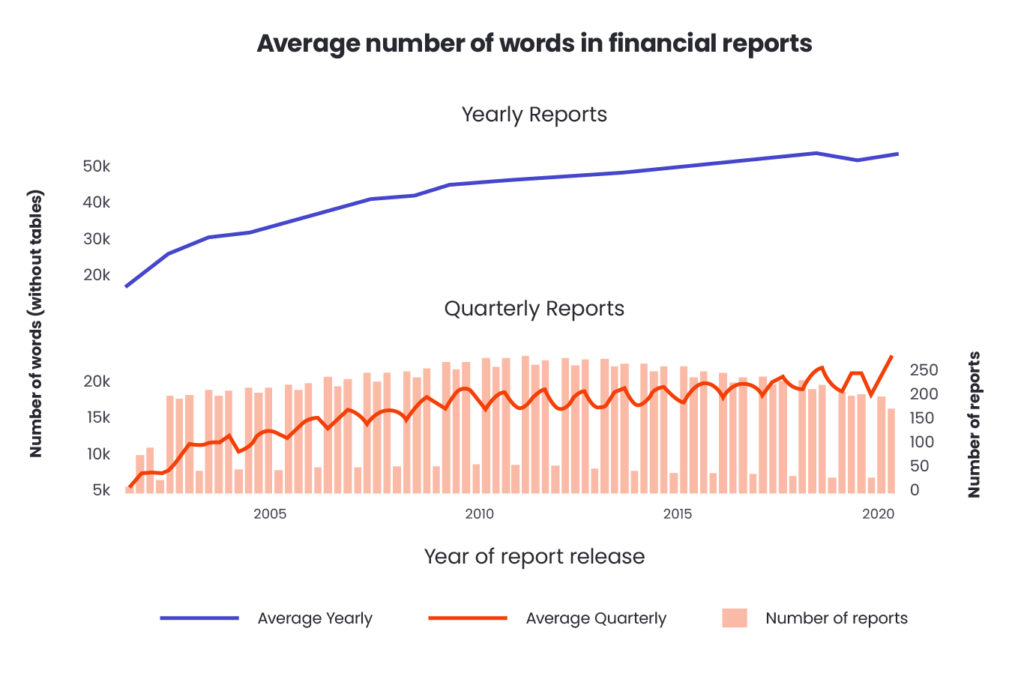
بالنسبة لمحللي سوق الأوراق المالية، تُعد البيانات المالية ذات أهمية بالغة لأنها تُعلم عن الربح أو الخسارة وتُعرض في جداول واضحة.
من المحتمل أن تكون هذه الحقائق الوحيدة التي سيلاحظها محلل سوق الأسهم الذي لديه عشرات التقارير المكونة من 100 صفحة ليقرأها في نهاية العام.
ثلاثة اقتصاديون: لورين كوهين، وكريستوفر مالوي من كلية هارفارد للأعمال، وكوك نجوين من جامعة ديبول، يذكرون في عملهم بعنوان 'Lazy Prices‘ أنه من خلال مقارنة تقارير سوق الأسهم، يمكننا التنبؤ بانخفاض أو ارتفاع أسهم شركة معينة.
استخدم الباحثون تقنيات تحليل النصوص لحساب أوجه التشابه بين إفصاحات هيئة الأوراق المالية والبورصات (SEC) (التقارير). وقد أثبتوا الفرضية القائلة بأن الشركات التي تكون تقاريرها مشابهة إلى حد كبير لنسخها من العام السابق، ستحقق مكاسب في سوق الأسهم.
وعلى الطرف الآخر من المقياس، تتعرض الشركات التي تحتوي تقاريرها على اختلافات كثيرة لانخفاضات مستقبلية في الأسعار أو حتى الإفلاس. ويمكن أيضًا تفسير ذلك بفرضية أن الشركات المستقرة ستحقق أداءً أفضل في سوق الأوراق المالية.
لمقارنة التقارير، يستخدم الباحثون مقاييس تحسب تشابه النصوص، مثل تشابه جيب التمام وتشابه جاكار.
خدماتنا
أردنا التحقق من الفرضية التي طرحها الباحثون. لهذا السبب قررنا تنزيل آلاف تقارير سوق الأسهم. باستخدام أساليب معالجة اللغة الطبيعية (NLP)، أجرينا تحليلنا الخاص لتأكيد premise الفرضية.
استخراج البيانات وتنظيفها
في المرحلة الأولية، تمت كتابة أداة استخراج بيانات تلقائية، قامت بتنزيل تقارير من أكثر من 200 شركة مختارة عشوائياً من بورصة الأسهم الأمريكية على مدى العشرين عاماً الماضية.
في المرحلة الأولية من تحليل النصوص، غالبًا ما تُنفَّذ خطوات لتنظيف النص وتقليل تكرار الكلمات النادرة. فيما يلي بعض الطرق الأساسية التي تتيح لك الحصول على نتائج أفضل في التحليل اللاحق:
أ) عملية تجريد اللواحق (stemming) تترك فقط جذر الكلمة؛ وهدفها تحويل كلمة تظهر بأشكال مختلفة إلى الصيغة نفسها. ومن الأمثلة على ذلك تقليص كل من الكلمات "fly" و"flying" و"flies" إلى كلمة واحدة هي "fly"،
ب) إزالة كلمات التوقف (stopwords) – من الممارسات الشائعة إزالة الكلمات التي تتكرر كثيراً ولا تضيف معلومات إضافية إلى النص. خصوصاً عند تحليل النص الإنجليزي، من المهم إزالة كلمات مثل "the" و"a" و"an"،
ج) إزالة علامات الترقيم،
د) تحويل الأحرف الكبيرة إلى أحرف صغيرة.
حساب مقاييس التشابه
بعد تنظيف النص في جميع التقارير، ننتقل إلى حساب مقاييس التشابه.
يُعد حساب التشابه بين مستندين نصيين مهمة شائعة في معالجة اللغة الطبيعية وله استخدامات عملية عديدة. تُستخدم هذه الطريقة، على سبيل المثال، لترتيب النتائج في محرك البحث أو للتوصية بمحتوى مشابه للقراء.
الحصول على قيمة رقمية واحدة تشير إلى مدى تشابه المستندين يسهّل بشكل كبير العديد من العمليات المتعلقة بتحليل البيانات ويؤتمتها. هناك العديد من الخوارزميات التي تهدف إلى حساب تشابه المستندات. يعمل بعضها بناءً على عدد الكلمات المتطابقة في المستندات، بينما تبني خوارزميات أخرى أكثر تقدمًا فهمًا لمحتوى المستندات وتضع النصوص المتشابهة قريبة من بعضها البعض في فضاء متجهي مدرَّب مسبقًا.
في مشروعنا، استخدمنا مقياسين استُخدما أيضًا في منشور ‘Lazy Prices’. وهما مقياسا جيب التمام (cosine) وجاكار (Jaccard).
تشابه جيب التمام هو مقياس للتشابه بين متجهين ضمن فضاء وحدوي معين. ويُعبَّر عنه بقيمة جيب تمام الزاوية المحددة بواسطة متجهين، ويحدد مدى توجيههما في اتجاه مماثل.
يقيس معامل Jaccard تشابه المجموعات من خلال حساب حاصل قسمة عدد العناصر المشتركة على مجموع كلتا المجموعتين.
من أجل استخدام مقياس جيب التمام ومقياس جاكار لحساب تشابه المستندات، من الضروري تعيينها إلى فضاء متجهي.
لهذا الغرض، يتم جمع جميع الكلمات التي تظهر في تقرير واحد على الأقل. ثم يتم تحويل كل تقرير إلى متجه يمثل أرقامًا تتوافق مع عدد المرات التي تظهر فيها كلمة معينة في التقرير الذي تم تحليله.
تُستخدم المتجهات المُنشأة بهذه الطريقة لحساب كلا مقياسي التشابه.
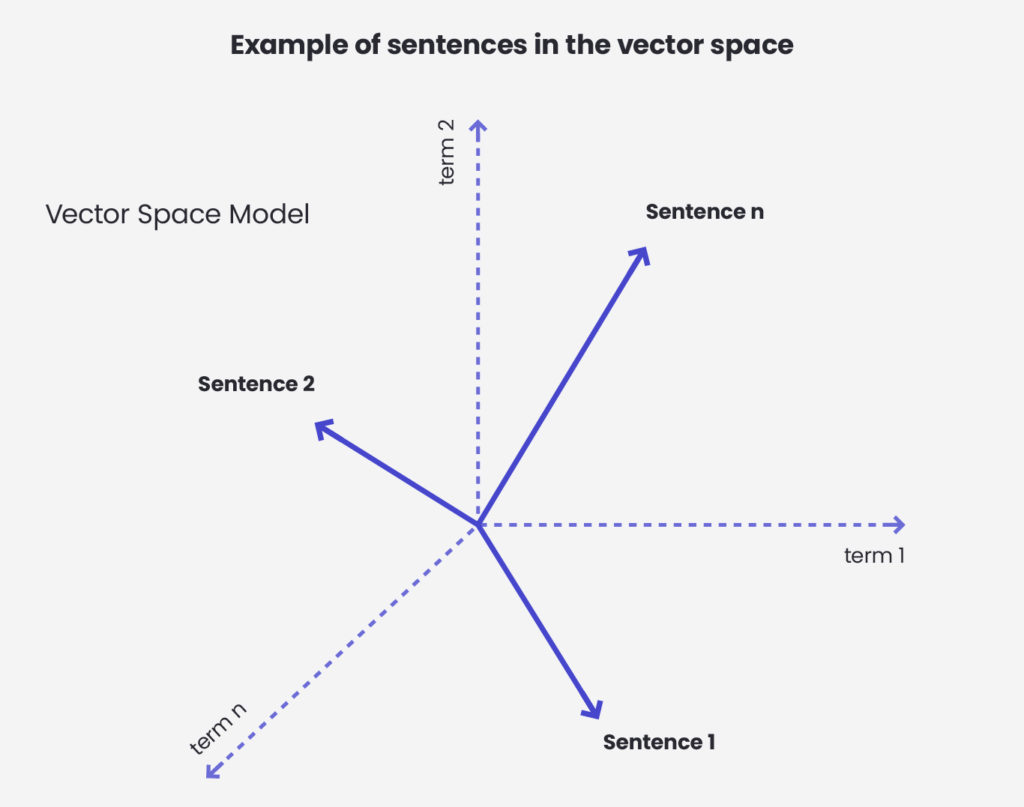
في الصورة أعلاه يمكننا رؤية مثال تُسقَط فيه الجمل على فضاء متجهي. ولحساب التشابه الجيبي بين جملتين، نحسب جيب الزاوية بين المتجهين المقابلين لهما.
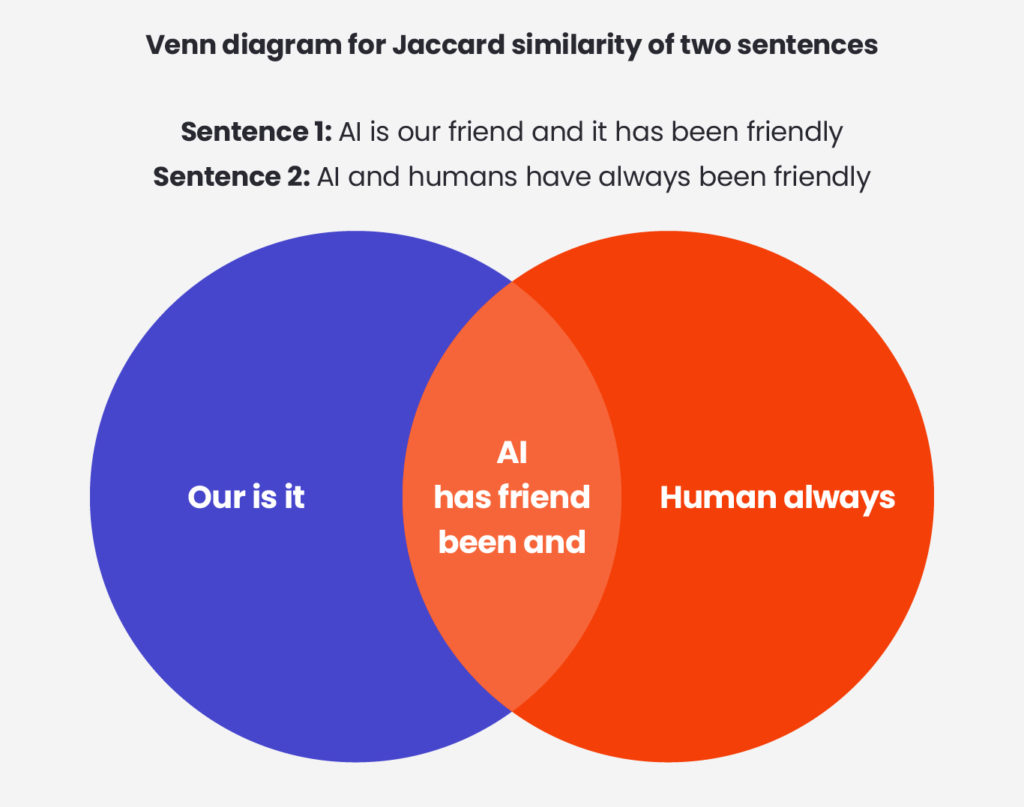
نعرض أدناه كيفية حساب تشابه Jaccard. بالنسبة لجملتين، نحسب حاصل قسمة عدد الكلمات المشتركة على عدد جميع الكلمات الفريدة في كلتا الجملتين.
تحليل تغيّر الأسعار
من أجل التحقق من الارتباط بين تشابه التقارير من السنوات اللاحقة والحالة المالية للشركة، تم جمع الأسعار التاريخية لجميع الشركات التي جرى تحليلها، بدءًا من تاريخ نشر أقدم إيداع لدى SEC.
تم تصنيف جميع التقارير إلى تلك ذات التشابه المنخفض (أقل من المئين العاشر)، والمتوسط (بين المئين العاشر والثمانين)، والمرتفع (أعلى من المئين الثمانين). وفي كل فترة تقرير، تم حساب قيم المئينات المعنية من خلال التطبيع وفقًا لأوجه التشابه لجميع التقارير من تلك الفترة.
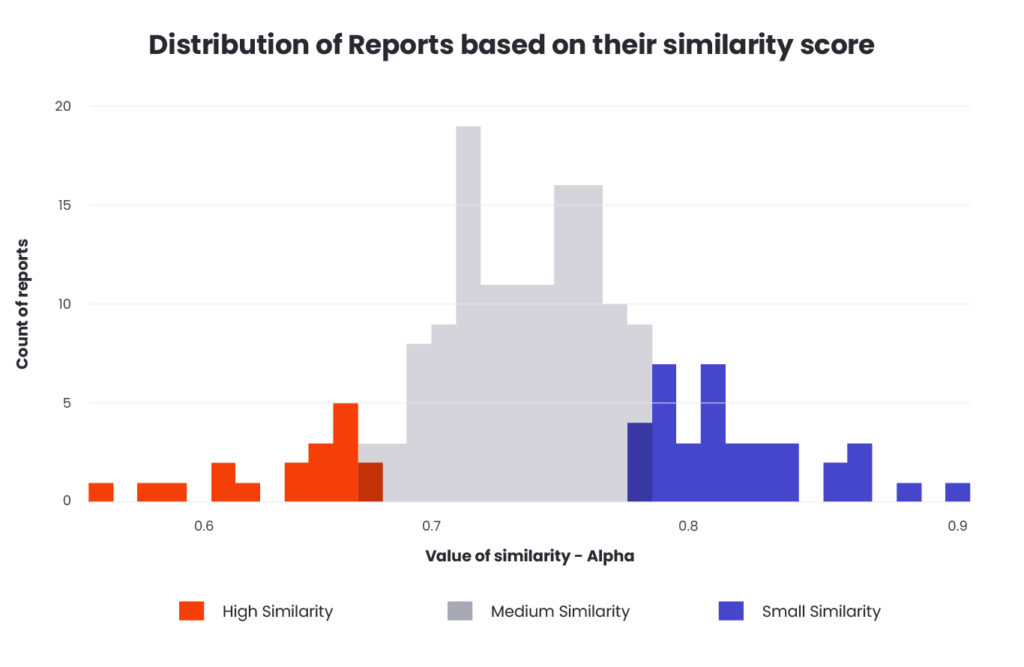
وفقاً لـ 'Lazy Prices'، لملاحظة التغيرات في وضع الشركة، من الضروري الانتظار ثلاثة أشهر بعد شراء سهم معين، وهو ما نقوم به بعد شهر واحد من إصدار التقرير. على هذا الأساس، سنختبر الفرضية من خلال حساب العائد المحتمل على شراء سهم معين في يوم نشر التقرير وبيعه بعد ثلاثة أشهر.
في الخطوة التالية، سنحسب متوسط العوائد لكل مجموعة من مجموعات الأسهم (التشابه المنخفض والمتوسط والمرتفع). بافتراض صحة الفرضية، نتوقع زيادات في مجموعة التشابه المرتفع وانخفاضات في مجموعة التشابه المنخفض.
النتائج
قدمنا التحليل كتطبيق تفاعلي مكتوب باستخدام مكتبة Streamlit. تُظهر الرسوم البيانية متوسط العوائد بعد 1 و2 و3 و4 و5 و6 أشهر من شراء السهم. وفقًا للاستراتيجية المفترضة، نركز على العائد بعد الشهر الثالث. يشير لون الخطوط إلى مجموعة التشابه.
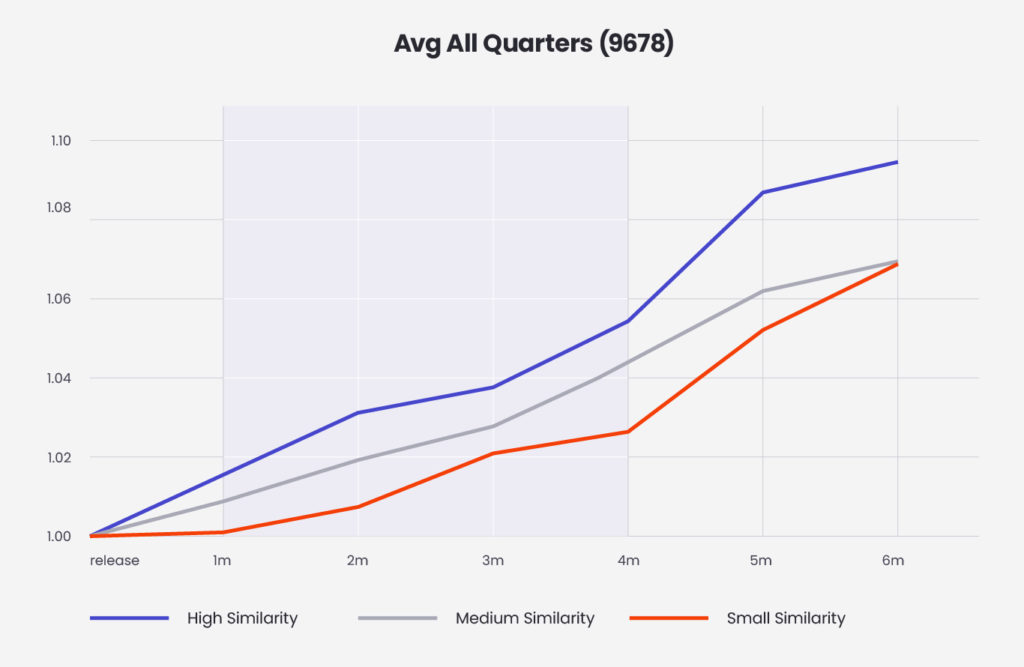
على الرسم البياني، نلاحظ عائدًا إيجابيًا بغض النظر عن مجموعة تشابه التقارير. نشتري السهم عند "1m" – بعد شهر واحد من إصدار التقرير. نبيع السهم عند "4m" – بعد ثلاثة أشهر من الشراء. وذلك لأن التحليل أُجري على بيانات تاريخية لسوق الأسهم من آخر 20 عامًا. خلال هذه الفترة، سجلت جميع الأسهم في المتوسط ارتفاعًا في الأسعار. وبالتالي، يصعب العثور على مجموعة فرعية من الأسهم التي ستنخفض إذا تم حساب متوسطها.
لكن ما يثير الاهتمام هو الفرق الواضح بين المجموعتين. فقد حققت أسهم الشركات التي كانت تقاريرها متشابهة جدًا ربحًا أعلى بأكثر من 3 نقاط مئوية بعد 3 أشهر، مما يشير إلى أن الفرضية المطروحة في ’Lazy Prices‘ قد تكون صحيحة.
ومن المفاجئ أيضاً أننا تمكنا من الحصول على مثل هذه النتائج باستخدام تقنيات أساسية جداً لقياس تشابه النص. وقد تكون الخطوات التالية التي يمكن أن تحسن جودة تنبؤنا بالشركات النامية هي إدخال مقاييس متقدمة تستند إلى خوارزميات مثل word2vec أو المحولات. وبالإضافة إلى ذلك، بدلاً من حساب العوائد التاريخية، قد نحاول بناء نموذج تعلم آلي يستخدم، بالاستعانة بقيم مقاييس التشابه المختلفة، محاولة حل مشكلة الانحدار والتنبؤ بالقيمة الدقيقة لتغير سعر السهم بعد ثلاثة أشهر.
هل أنت مهتم بمعرفة المزيد أو لديك مشروع AI يمكننا مساعدتك فيه؟ تواصل مع فريقنا باستخدام النموذج أدناه.
arrow_circle_right دراسات الحالة
اقرأ قصص نجاح عملائنا


arrow_circle_rightالذكاء الاصطناعي وتعلم الآلة
هل أنت مهتم بالتعاون معنا؟
تواصل معنا.
Tomasz Smolarczyk
مدير الذكاء الاصطناعي