Analyses par IA des tendances du marché boursier : décrypter le code avec Lazy Prices
Dans notre projet, nous avons étudié le potentiel de l'IA dans l'analyse du marché boursier, en nous concentrant spécifiquement sur la prédiction des variations des cours boursiers à partir de l'analyse textuelle des rapports financiers des entreprises. Nous avons utilisé des techniques telles que le scraping de données, le nettoyage de texte et le calcul de similarité pour évaluer la corrélation entre la similarité des rapports et la performance boursière.

Technologies
Besoin métier
L'intelligence artificielle est passée d'une nouveauté technologique à un sous-domaine technologique en plein développement. La plupart des entreprises, lorsqu'elles planifient leur croissance, optent pour la transformation en ce que l'on appelle une « entreprise pilotée par les données ». Cela implique un passage d'une prise de décision purement experte à une prise de décision principalement prise de décision basée sur les données.
Compte tenu du succès croissant des modèles d'IA, nombreuses sont les personnes qui ont tenté de les utiliser pour prédire les cours boursiers. La capacité de créer un algorithme qui prédit le prix d'une action donnée et permet à l'utilisateur de s'enrichir rapidement a enflammé l'imagination des data scientists pendant de nombreuses années.
Au fil du temps, malgré l'utilisation de nombreuses méthodes différentes, aucun algorithme n'a été créé pour fournir une stratégie gagnante à long terme sur le marché boursier. La plupart des méthodes reposaient sur une tentative d'adapter des algorithmes sélectionnés à des variables historiques telles que les cours des actions, les taux de change ou les prix de matières premières comme l'or ou la viande.
Dans le cadre du « proof of concept » élaboré pour les besoins de l'entreprise, nous avons également tenté d'examiner la possibilité de prédire quelles actions gagneraient ou perdraient de la valeur. Notre analyse reposait toutefois sur l'analyse du texte.
Toutes les sociétés cotées aux États-Unis sont tenues de publier des rapports trimestriels et annuels décrivant leur situation financière. Les rapports ont une structure imposée qui définit les chapitres à y inclure.
Au cours d'une année, les entreprises publient trois rapports trimestriels (appelés 10-Q) et un rapport annuel (appelé 10-K). Les rapports boursiers ne sont ni une lecture facile ni agréable. Ils sont d'une longueur effrayante. Le dernier rapport annuel de Microsoft comptait 130 pages.
Le langage utilisé est très officiel, juridique et répétitif. De plus, la longueur moyenne des rapports, en termes de nombre de mots utilisés, augmente pratiquement chaque année, comme le montre le graphique ci-dessous.
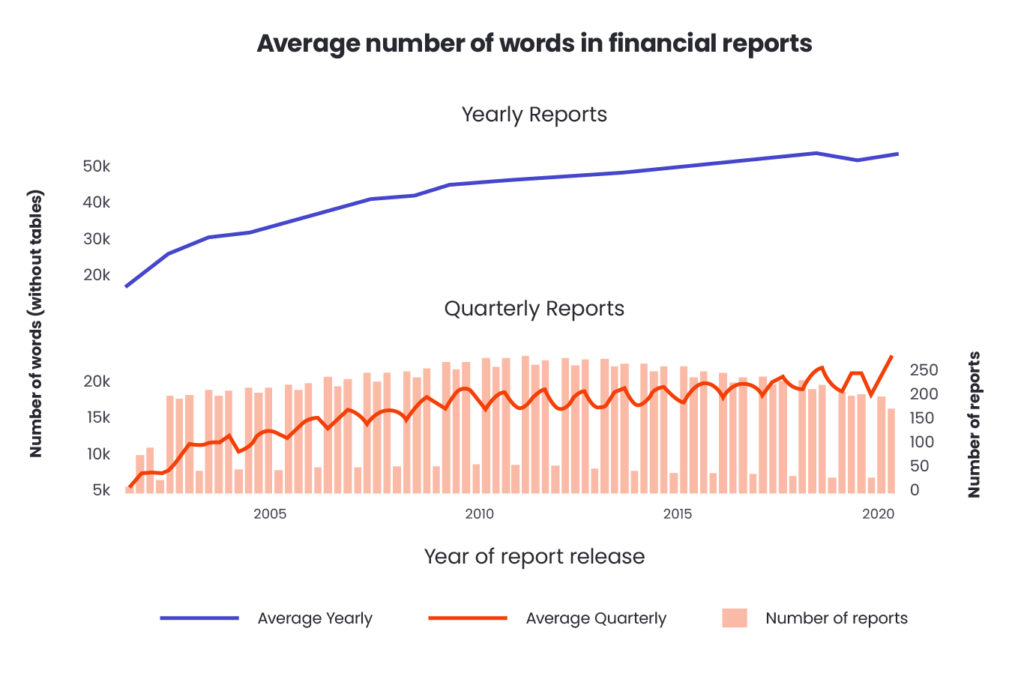
Pour les analystes de marché, les données financières sont d'une importance cruciale car elles informent sur les profits ou les pertes et sont présentées dans des tableaux clairs.
Il est possible que ce soient les seuls faits qui seront remarqués par un analyste boursier ayant plusieurs dizaines de rapports de 100 pages à lire en fin d'année.
Trois économistes : Lauren Cohen, Christopher Malloy de la Harvard Business School et Quoc Nguyen de l'Université DePaul affirment dans leur travail intitulé ‘Lazy Prices« qu'en comparant les rapports boursiers, nous pouvons prédire une baisse ou une hausse des actions d'une entreprise donnée.
Les chercheurs ont utilisé des techniques d'analyse textuelle pour calculer les similitudes entre les dépôts SEC (rapports). Ils ont prouvé l'hypothèse selon laquelle les entreprises dont les rapports sont largement similaires à leurs versions de l'année précédente gagneront en bourse.
À l'autre extrémité de l'échelle, les entreprises dont les rapports contiennent de nombreux écarts sont exposées à de futures baisses de prix, voire à la faillite. Cela peut également être interprété comme l'hypothèse selon laquelle les entreprises stables obtiendront de meilleurs résultats sur le marché boursier.
Afin de comparer les rapports, les chercheurs utilisent des mesures qui calculent la similarité textuelle, telles que la similarité cosinus et la similarité de Jaccard.
Nos services
Nous voulions vérifier l'hypothèse présentée par les chercheurs. C'est pourquoi nous avons décidé de télécharger des milliers de rapports boursiers. À l'aide de méthodes de NLP, nous avons mené notre propre analyse pour confirmer le postulat de l'hypothèse.
Extraction et nettoyage des données
Lors de la phase initiale, un scraper automatique a été développé, lequel téléchargeait les rapports de plus de 200 entreprises sélectionnées aléatoirement à la bourse américaine sur les 20 dernières années.
Lors de la phase initiale de l'analyse de texte, des étapes sont souvent réalisées pour nettoyer le texte et réduire les occurrences de mots rares. Voici quelques-unes des méthodes de base qui vous permettront d'obtenir de meilleurs résultats dans l'analyse suivante :
a) l'opération de racinisation ne laisse que le sujet du mot ; son objectif est de transformer un mot apparaissant sous différentes variantes en une même forme. Un exemple peut être de réduire chacun des mots « fly », « flying », « flies » à un seul mot « fly »,
b) la suppression des mots vides – il est courant de supprimer les mots qui apparaissent très souvent et n'ajoutent pas d'information supplémentaire au texte. En particulier lors de l'analyse d'un texte en anglais, il est important de supprimer des mots comme « the », « a », « an »,
c) suppression de la ponctuation,
d) conversion des lettres majuscules en minuscules.
Calcul des mesures de similarité
Après avoir nettoyé le texte dans tous les rapports, nous passons au calcul des métriques de similarité.
Le calcul de la similarité entre deux documents textuels est une tâche courante en NLP et a de nombreuses applications pratiques. Cette méthode est utilisée, par exemple, pour positionner les résultats dans un moteur de recherche ou pour recommander un contenu similaire aux lecteurs.
L'obtention d'une valeur numérique unique indiquant l'ampleur de la similitude entre les deux documents facilite et automatise considérablement de nombreux processus liés à l'analyse des données. Il existe de nombreux algorithmes visant à calculer la similitude des documents. Certains fonctionnent sur la base du nombre de mots identiques dans les documents, d'autres, plus avancés, construisent une compréhension du contenu des documents et placent les textes similaires à proximité les uns des autres dans un espace vectoriel préalablement entraîné.
Dans notre projet, nous avons utilisé deux mesures également employées dans la publication « Lazy Prices ». Il s'agissait des mesures de similarité cosinus et de Jaccard.
La similarité cosinus est une mesure de la similitude entre deux vecteurs dans un espace unitaire donné. Elle est exprimée par la valeur du cosinus d'un angle défini par deux vecteurs et détermine dans quelle mesure ils sont orientés dans une direction similaire.
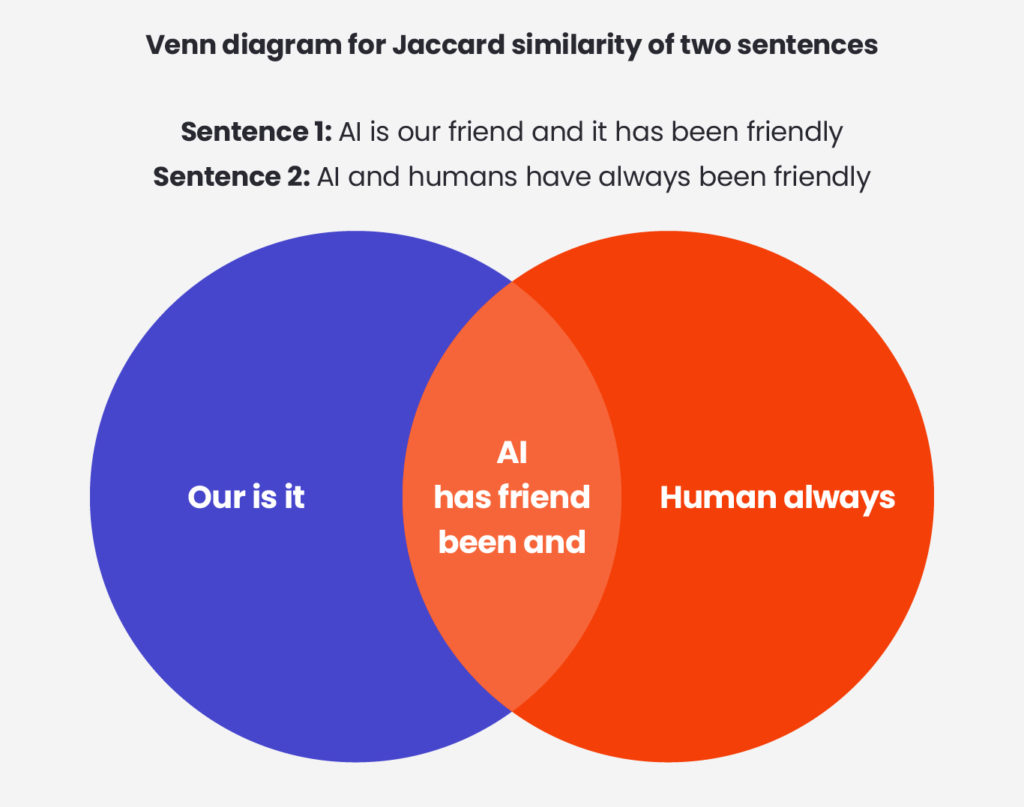
Le coefficient de Jaccard mesure la similarité des ensembles en calculant le quotient du nombre d'éléments communs par la somme des deux ensembles.
Afin d'utiliser la mesure cosinus et la mesure de Jaccard pour calculer la similarité des documents, il est nécessaire de les projeter dans un espace vectoriel.
À cette fin, tous les mots apparaissant dans au moins un rapport boursier sont collectés. Ensuite, chaque rapport est converti en un vecteur représentant des nombres qui correspondent au nombre de fois qu'un mot donné apparaît dans le rapport analysé.
Les vecteurs ainsi créés sont utilisés pour calculer les deux mesures de similarité.
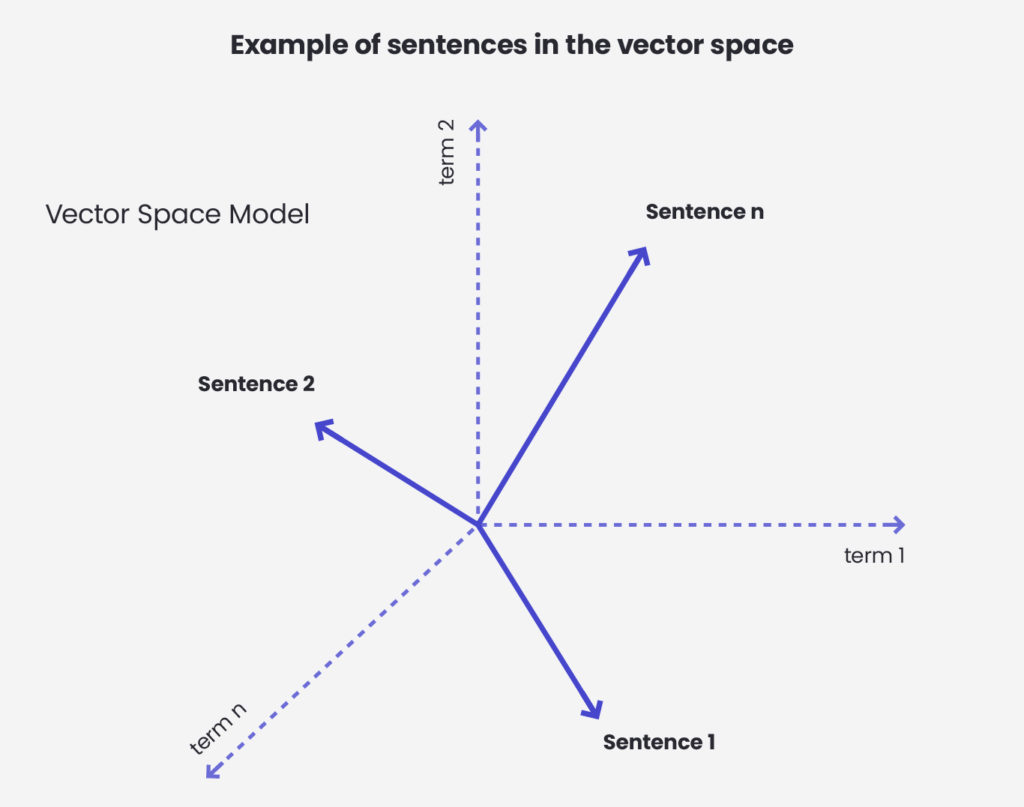
Dans l'image ci-dessus, nous pouvons voir un exemple dans lequel des phrases sont projetées dans un espace vectoriel. Pour calculer la similarité cosinus de deux phrases, nous calculerions un cosinus entre leurs vecteurs correspondants.
Ci-dessous, nous présentons comment la similarité de Jaccard est calculée. Pour deux phrases, nous calculons le quotient du nombre de mots communs par le nombre total de mots uniques dans les deux phrases.
Analyse des changements de prix
Afin de vérifier la corrélation entre la similarité des rapports des années suivantes et la situation financière de l'entreprise, les prix historiques de toutes les entreprises analysées ont été collectés, à partir de la date de publication du plus ancien dépôt auprès de la SEC.
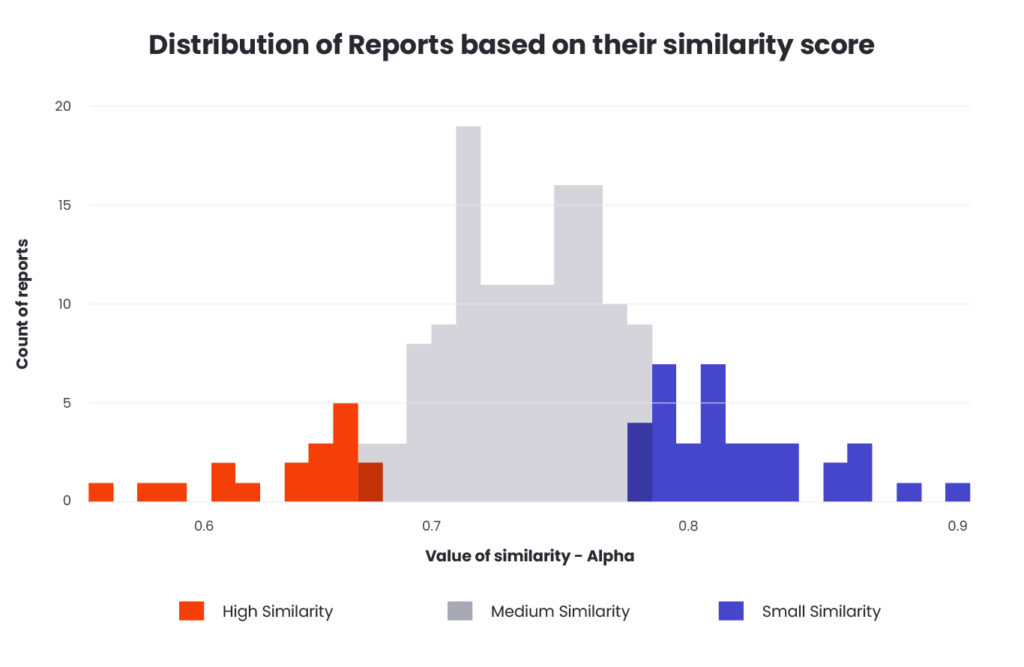
Tous les rapports ont été regroupés en ceux présentant une similarité faible (inférieure au 10e percentile), moyenne (entre le 10e et le 80e percentile) et élevée (supérieure au 80e percentile). Pour chaque période de référence, les valeurs des percentiles respectifs ont été calculées en normalisant selon les similarités de tous les rapports de cette période.
Selon « Lazy Prices », pour observer les changements dans la situation de l'entreprise, il est nécessaire d'attendre trois mois après l'achat d'une action donnée, que nous effectuons un mois après la publication d'un rapport. Sur cette base, nous testerons l'hypothèse en calculant le rendement potentiel de l'achat d'une action donnée le jour de la publication du rapport et de sa vente trois mois plus tard.
Dans l'étape suivante, nous calculerons les rendements moyens pour chacun des groupes d'actions (similarité faible, moyenne et élevée). En supposant que l'hypothèse soit vraie, nous nous attendons à des augmentations dans le groupe à similarité élevée et à des diminutions dans le groupe à similarité faible.
Les résultats
Nous avons présenté l'analyse sous la forme d'une application interactive écrite à l'aide de la bibliothèque Streamlit. Les graphiques montrent les rendements moyens 1, 2, 3, 4, 5 et 6 mois après l'achat de l'action. Conformément à la stratégie adoptée, nous nous concentrons sur le rendement après le troisième mois. La couleur des lignes indique le groupe de similarité.
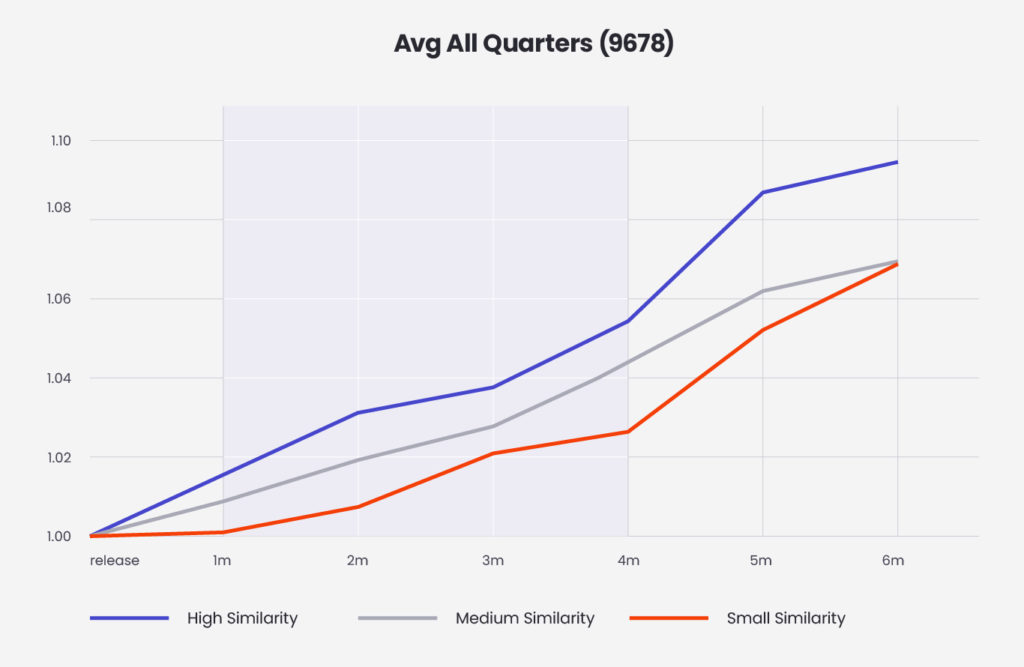
Sur le graphique, nous observons un rendement positif quel que soit le groupe de similarité des rapports. Nous achetons l'action à « 1m » – un mois après la publication du rapport. Nous vendons l'action à « 4m » – trois mois après l'achat. Cela s'explique par le fait que l'analyse a été réalisée sur des données boursières historiques des 20 dernières années. Durant cette période, en moyenne, toutes les actions ont enregistré une hausse de leurs prix. Il est donc difficile de trouver un sous-ensemble d'actions qui baisserait en moyenne.
Ce qui est intéressant, cependant, c'est la différence claire entre les groupes. Les actions des entreprises dont les rapports étaient très similaires ont réalisé un profit supérieur de plus de 3 points de pourcentage après 3 mois, ce qui suggère que l'hypothèse avancée dans « Lazy Prices » pourrait être vraie.
Il est également surprenant que nous ayons réussi à obtenir de tels résultats en utilisant des techniques très basiques pour mesurer la similarité du texte. Les prochaines étapes susceptibles d'améliorer la qualité de notre prédiction des entreprises en croissance pourraient être l'introduction de mesures avancées basées sur des algorithmes tels que word2vec ou les transformers. De plus, au lieu de calculer les rendements historiques, nous pourrions essayer de construire un modèle ML qui, en utilisant les valeurs de diverses mesures de similarité, tentera de résoudre le problème de régression et de prédire la valeur exacte de la variation du cours de l'action après trois mois.
Souhaitez-vous en savoir plus ou avez-vous un projet d'IA que nous pourrions vous aider à réaliser ? Contactez notre équipe à l'aide du formulaire ci-dessous.
arrow_circle_right Études de cas
Découvrez les réussites de nos clients


arrow_circle_rightINTELLIGENCE ARTIFICIELLE ET APPRENTISSAGE AUTOMATIQUE
Vous souhaitez collaborer avec nous ?
Contactez-nous.
Tomasz Smolarczyk
Directrice de l'Intelligence Artificielle