Détection d'objets dans les images panoramiques de grande taille


Les photos panoramiques sont de plus en plus populaires dans le monde d'aujourd'hui, en particulier lorsqu'il s'agit d'explorer des villes à l'aide d'outils comme Google Street View. Grâce au développement rapide des techniques de vision par ordinateur, il est désormais possible de construire des modèles de détection d'objets de pointe pour les photos panoramiques afin d'aider à identifier et localiser différents objets.
Dans cet article, nous explorerons comment construire des modèles de vision par ordinateur pour la détection d'objets sur des photos panoramiques à l'aide d'un framework SAHI (Slicing Aided Hyper Inference) et discuterons d'exemples d'utilisation de tels modèles. Nous nous concentrerons sur l'identification et la détection des panneaux de signalisation et d'autres éléments d'infrastructure du réseau routier.
Les défis du travail avec des images panoramiques
Les images panoramiques de villes, comme dans Google Street View, présentent des défis uniques lors de la construction de modèles de reconnaissance et de détection d'objets. L'un des défis les plus importants est la grande taille des images. Ces images peuvent faire des milliers de pixels de large, ce qui rend difficile leur traitement efficace.
Un autre défi lié à la création de modèles de vision par ordinateur pour la détection d'objets sur des photos panoramiques est la petite taille des objets par rapport à la résolution globale de l'image. Dans certains cas, les objets présents dans les images panoramiques peuvent représenter moins de 0,1 % de la surface totale de l'image, ce qui les rend très difficiles à détecter, à identifier et à analyser.
Lorsque les objets sont petits, la résolution des images peut ne pas être suffisamment élevée pour fournir le niveau de détail requis pour une détection d'objet ou une classification d'image précise. De plus, la petite taille des objets peut rendre difficile leur distinction par rapport à l'arrière-plan de l'image, ce qui peut compliquer davantage la procédure de détection. L'analyse de régions spécifiques de l'image peut aider à isoler et à identifier de petits objets dans des arrière-plans complexes, améliorant ainsi la précision de la détection.
Modélisation par vision par ordinateur pour la détection d'objets
La création de modèles de détection d'objets pour les photos panoramiques nécessite plusieurs étapes clés. Tout d'abord, nous avons dû obtenir un ensemble de données de photos panoramiques que nous avons ensuite utilisé pour entraîner notre modèle.
Préparation des données et classification des images
La préparation des données est une étape cruciale dans la construction d'un modèle de détection d'objets précis et efficace pour les photos panoramiques. Cela implique de collecter et d'annoter un large ensemble d'images panoramiques qui seront utilisées pour entraîner le modèle de détection d'objets. Dans ce cas particulier, quelques centaines d'images panoramiques ont été annotées manuellement avec des panneaux de signalisation, des feux de circulation, des bornes d'incendie, des éléments d'infrastructure routière et d'autres étiquettes pertinentes.
L'étiquetage manuel des images est une technique chronophage, mais elle est essentielle pour entraîner un modèle de détection d'objets précis. Étiqueter chaque objet dans l'image permet au modèle d'identifier et de classer avec précision chaque objet lorsqu'il est confronté à de nouvelles images. De plus, les données étiquetées permettent au modèle de classer les images en les attribuant à des catégories prédéfinies en fonction des objets présents.
Quelques statistiques sur les images et les bounding boxes de notre jeu de données :
- Ensemble d'entraînement :
- 500 images panoramiques
- 1998 annotations de boîtes englobantes
- Ensemble de test :
- 250 images panoramiques
- 1045 annotations de boîtes englobantes
Les ensembles de données étaient fortement déséquilibrés, comme le montrent les figures ci-dessous. Seulement 29 instances de panneaux de limitation de vitesse sont visibles dans l'ensemble de données d'entraînement. De plus, plus de 80 % des boîtes englobantes étaient inférieures à 50×50 pixels. Il s'agit d'un cadre très difficile pour tous les détecteurs d'objets.
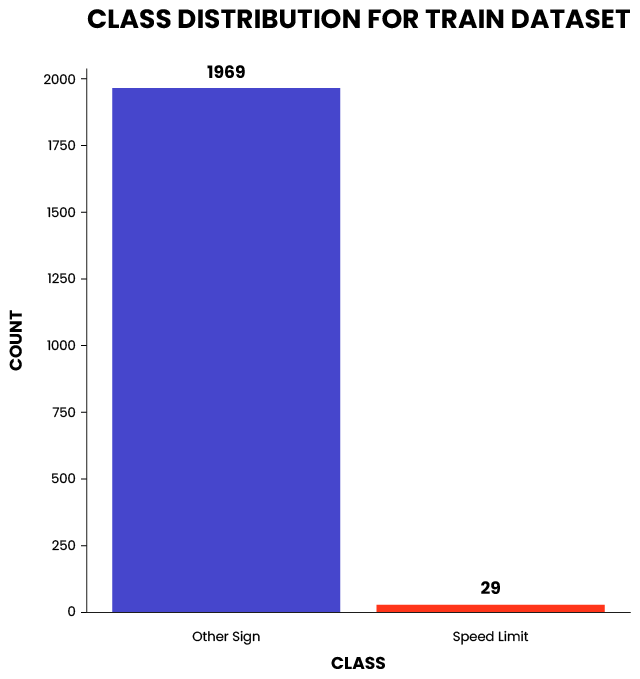
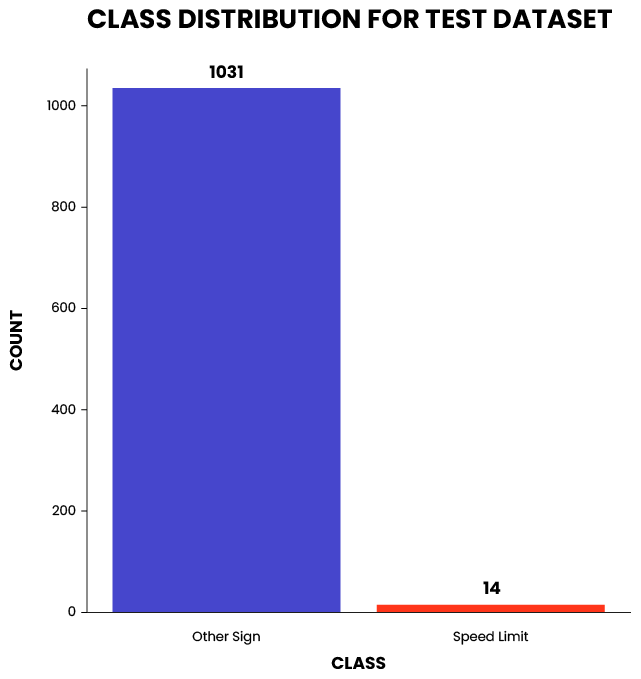
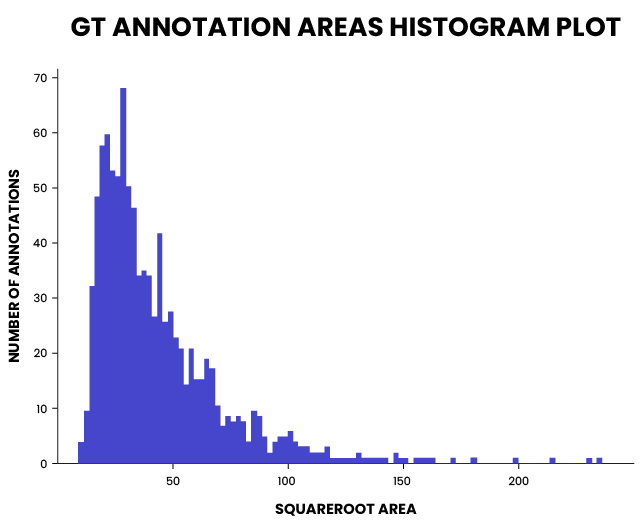
Les ensembles de données étaient fortement déséquilibrés, comme le montrent les figures ci-dessous. Seulement 29 instances de panneaux de limitation de vitesse sont visibles dans l'ensemble de données d'entraînement. De plus, plus de 80 % des boîtes englobantes étaient inférieures à 50×50 pixels. Il s'agit d'un cadre très difficile pour tous les détecteurs d'objets.
Comme vous pouvez le constater, il s'agissait d'un très petit échantillon de données – généralement, nous traitons des milliers, voire des centaines de milliers d'images. Cependant, compte tenu de la grande taille des panoramas et de la très petite taille des objets que nous étiquetions, il a fallu plus de 3 jours-homme pour étiqueter ces 750 images.
Pour les modèles de production à grande échelle, lorsqu'il est nécessaire d'annoter des milliers ou des millions d'images, nous recommandons d'automatiser ce processus avec l'apprentissage par transfert et des itérations rapides.
Le modèle de la famille YOLO
Dans notre cas, nous avons opté pour l'utilisation de la famille de modèles YOLO. YOLO est une famille de modèles de détection d'objets qui a récemment gagné en popularité. En tant que modèles d'apprentissage profond et réseaux d'apprentissage profond, YOLO et ses variantes sont largement utilisés pour les tâches de détection d'objets. YOLO signifie « You Only Look Once ». Nous avons utilisé YOLOX, qui est une amélioration du modèle YOLO original. YOLOX est basé sur une architecture de réseau neuronal convolutif et constitue un type de réseau neuronal optimisé pour la détection d'objets. YOLOX est connu pour ses performances rapides et précises, ce qui le rend particulièrement adapté à la détection d'objets dans les photos panoramiques.
L'un des principaux avantages de YOLOX est sa capacité à atteindre une grande précision tout en conservant des temps d'inférence rapides (plus rapide qu'EfficientDet). Cela est rendu possible grâce à un certain nombre d'optimisations, telles que la détection d'objets sans ancrage, une extraction de caractéristiques améliorée et une utilisation plus efficace de la mémoire. YOLOX traite les cartes de caractéristiques à plusieurs échelles pour permettre une détection multi-échelle.
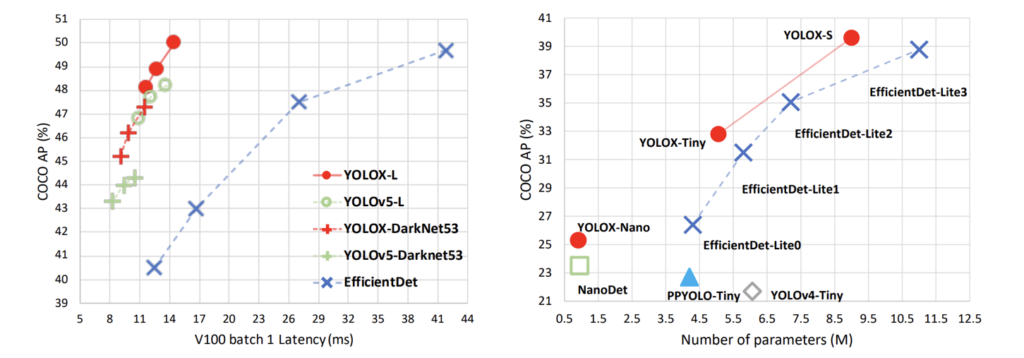
Globalement, le détecteur d'objets YOLOX est bien adapté à une utilisation sur des photos panoramiques et s'est avéré atteindre des performances de pointe dans diverses tâches de vision par ordinateur liées à la détection d'objets. YOLOX est l'un des nombreux modèles de détection d'objets, et il existe diverses méthodes de détection d'objets dans ce domaine. Sa rapidité et sa précision en font un choix populaire pour diverses applications concrètes, des véhicules autonomes aux systèmes de surveillance. YOLOX effectue à la fois la classification et la localisation d'objets en une seule passe. Il peut gérer plusieurs classes et discrétise l'espace de sortie pour une détection efficace.
Le framework SAHI pour l'entraînement en vision par ordinateur
Une approche pour entraîner les modèles de détection d'objets pour les photos panoramiques qui a donné d'excellents résultats pour nous est la Framework Sliced Aided Hyper Inference (SAHI). Dans notre cas, SAHI impliquait de diviser les images en patchs se chevauchant et d'entraîner les modèles de détection d'objets sur ces patchs. Une fois entraîné, le modèle est utilisé pour effectuer des prédictions sur des images entières à l'aide d'une inférence par tranches.
Le concept d'inférence par tranches est central dans le framework SAHI. Essentiellement, l'inférence par tranches consiste à effectuer une inférence de détection d'objets sur des tranches plus petites de l'image panoramique originale, puis à fusionner les prédictions par tranches pour générer une sortie complète de détection d'objets pour l'image originale. Le processus est illustré ci-dessous :
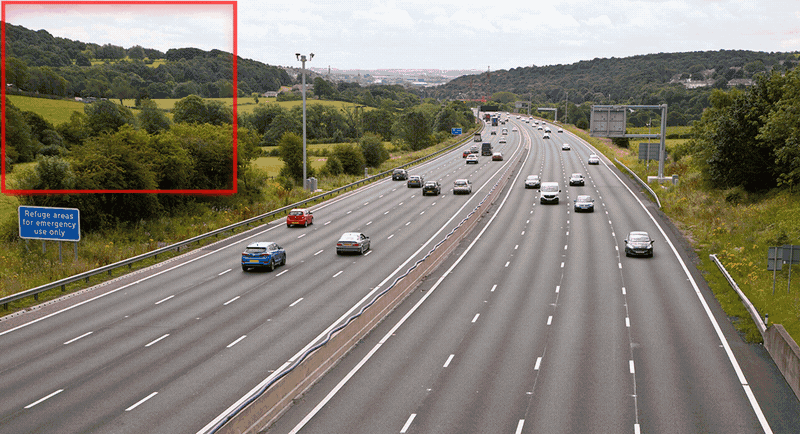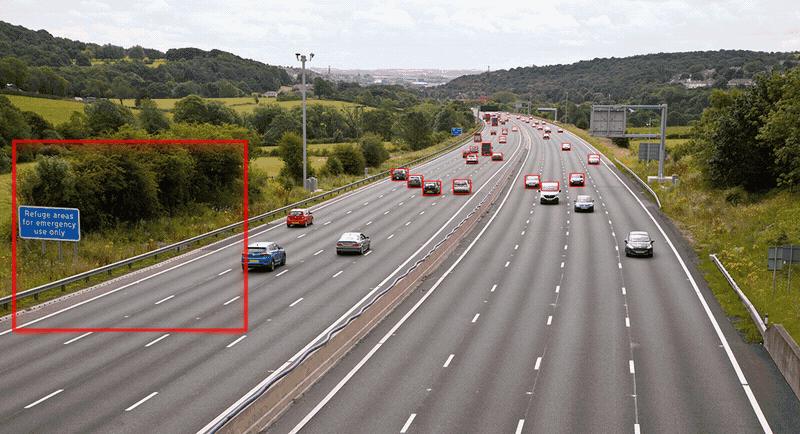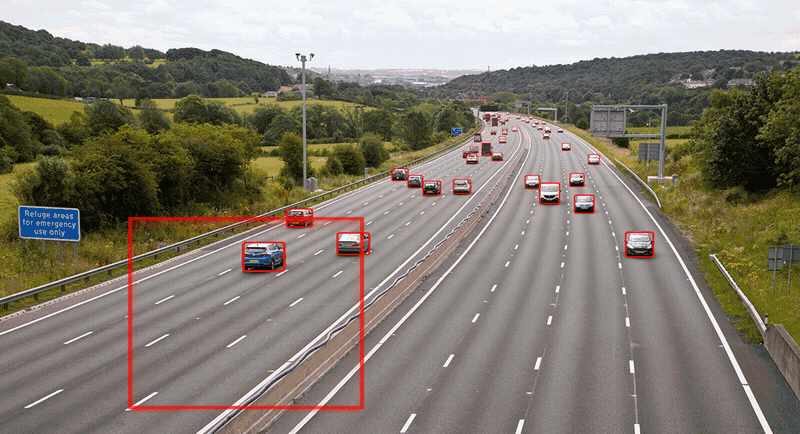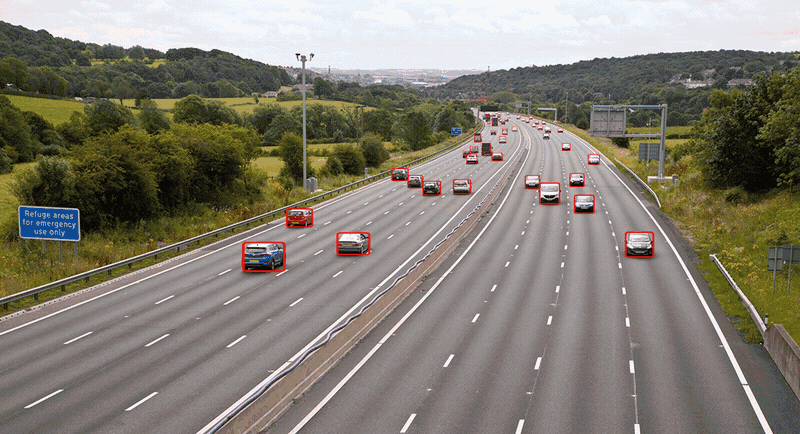
En divisant l'image panoramique en tranches plus petites et en s'entraînant sur celles-ci, le modèle de détection d'objets peut plus facilement relever les défis liés à la grande taille de l'image et à la petite taille des objets, qui sont courants lorsqu'on travaille avec des photos panoramiques. De plus, le framework SAHI fournit un mécanisme permettant d'unifier les prédictions générées par le modèle sur les différentes tranches, ce qui aboutit à une sortie de détection d'objets plus précise et plus complète pour l'ensemble de l'image panoramique.
L'utilisation de SAHI est aussi simple que de l'importer et d'appeler une seule fonction en lui fournissant la spécification de notre modèle entraîné et le chemin vers les données. Le framework SAHI gère le reste, et les résultats sont enregistrés dans un répertoire de notre choix. Un exemple d'extrait de code est présenté ci-dessous.
from sahi.predict import predict predict( model_type="mmdet", model_path="path/to/model/file.pth", model_config_path="path/to/model/config.py", model_device="cuda:0", model_confidence_threshold=0.25, slice_height=512, slice_width=512, overlap_height_ratio=0.2, overlap_width_ratio=0.2, source="test-images", project="test-images-predictions" )Un exemple de prédiction peut être consulté ci-dessous. Notez que même les panneaux de signalisation très petits en arrière-plan sont détectés avec un haut niveau de confiance.


Dans l'ensemble, le framework SAHI s'est avéré être une approche efficace pour entraîner des modèles de détection d'objets sur des photos panoramiques, permettant une précision améliorée par rapport aux techniques traditionnelles de détection d'objets.
Alternatives à SAHI
Parmi les approches alternatives de détection d'objets dans les images à grande échelle, on peut citer :
- Redimensionnement d'image : dans cette approche, l'image d'entrée est redimensionnée à une taille plus petite avant d'être traitée par l'algorithme de détection d'objets. Cela peut réduire la complexité computationnelle de l'algorithme, mais peut également entraîner une précision moindre, en particulier pour les petits objets.
- Approches par régions : dans cette approche, l'image est d'abord segmentée en régions d'intérêt, puis l'algorithme de détection d'objets est appliqué à chaque région individuellement. Cela peut être un moyen efficace de réduire la complexité computationnelle de l'algorithme, mais cela peut aussi entraîner des détections manquées si les régions d'intérêt ne sont pas correctement définies.
- Architectures spécialisées de détection d'objets : Détecteurs à tir unique à fusion de caractéristiques (FFSSD), Multi-scale Deconvolutional Single Shot Detector (MDSSD) or QueryDet peuvent être utilisées, cependant, ces approches ne sont pas courantes et nécessitent généralement des investissements élevés, tant pour la recherche des résultats publiés que pour la recréation et le réentraînement du réseau.
Dans notre cas, nous ne voulions pas faire de compromis entre la précision du modèle et la difficulté de mise en œuvre, nous avons donc opté pour l'utilisation de SAHI.
Limites de SAHI pour les modèles de détection d'objets
Bien que le framework SAHI se soit révélé être une approche efficace pour entraîner des modèles de détection d'objets sur des photos panoramiques, il présente certaines limites. L'un des principaux défis liés à l'utilisation de SAHI est l'augmentation du temps d'inférence et de la puissance de calcul requise, en raison de la nécessité de traiter de multiples fragments d'image et de fusionner les prédictions résultantes.
Plusieurs stratégies possibles peuvent être employées pour atténuer les exigences accrues de vitesse d'inférence et de puissance de calcul de SAHI. Une approche consiste à limiter la portion de l'image traitée par le modèle de détection d'objets.
Par exemple, supprimer les 25 % inférieurs et supérieurs de l'image réduit le nombre de patchs nécessaires pour générer de bonnes prédictions. Supprimer ces portions de l'image est justifié dans notre cas, puisque le haut et le bas de l'image panoramique contiennent généralement le ciel et la surface de la route, respectivement. Les distorsions les plus importantes, dues à l'effet fisheye, se produisent également dans ces régions. En incluant des patchs issus de ces régions, nous ne faisons que gaspiller de la puissance de calcul, car le modèle ne peut pas détecter efficacement le mobilier routier, ce qui entraîne un plus grand nombre de faux positifs.
Une autre stratégie consiste à optimiser le framework SAHI afin d'améliorer son efficacité. Cela peut impliquer d'optimiser le modèle de détection d'objets lui-même, ainsi que les étapes de post-traitement utilisées pour assembler les prédictions générées par le modèle sur les différentes portions de l'image (l'implémentation actuelle de SAHI utilise un traitement séquentiel des portions au lieu du traitement par lots).
De plus, les avancées matérielles, telles que l'utilisation d'unités de traitement spécialisées comme les GPU ou les TPU, peuvent également contribuer à accélérer la vitesse d'inférence et à réduire les besoins en puissance de calcul des modèles de détection d'objets basés sur SAHI.
Globalement, bien que SAHI puisse être une approche puissante pour entraîner des modèles de détection d'objets sur des photos panoramiques, il est important de prendre en compte les limitations potentielles de ce framework et d'explorer des stratégies pour atténuer ces limitations afin d'atteindre des performances optimales.

Exemples d'utilisation de détecteurs de très petits objets et d'images de grande taille
Malgré les défis liés au travail avec des photos panoramiques ou à la détection de très petits objets, il existe plusieurs exemples de la manière dont les modèles de détection d'objets peuvent être utilisés pour apporter des bénéfices concrets.
Véhicules autonomes
Les modèles de détection d'objets peuvent être utilisés dans les véhicules autonomes pour identifier des objets dans l'environnement, tels que les piétons, les voitures, les panneaux de signalisation et d'autres éléments d'infrastructure. Dans les environnements urbains, les photos panoramiques fournissent une multitude d'informations sur les environs, ce qui en fait une excellente source de données pour les systèmes qui détectent différents objets sur la route.
Systèmes de sécurité
Les systèmes de sécurité peuvent utiliser des modèles de détection d'objets pour identifier les menaces potentielles au sein d'une ville. Par exemple, les caméras de vidéosurveillance placées dans les espaces publics peuvent utiliser de telles méthodes pour la détection de personnes et l'identification de comportements suspects, tels qu'une personne portant une arme ou agissant de manière erratique.
Géospatial
Les applications géospatiales, telles que la détection d'objets à partir d'images satellitaires, peuvent également bénéficier de l'utilisation de détecteurs de très petits objets. En fait, la détection et la classification de petits objets dans les images satellitaires sont essentielles pour de nombreuses applications dans des domaines tels que la surveillance environnementale, l'agriculture et la sécurité nationale.
Les modèles de détection d'objets peuvent être utilisés dans la surveillance environnementale pour identifier les changements dans l'environnement, tels que la déforestation ou la pollution. Les images à grande échelle peuvent fournir une vue d'ensemble de l'environnement, ce qui en fait une excellente source de données pour un système de détection de pointe.
Imagerie médicale et microscopie
En imagerie médicale, la détection de petits objets est essentielle pour reconnaître et diagnostiquer des maladies comme le cancer. Par exemple, la détection de minuscules tumeurs ou lésions dans des IRM ou des scanners peut être critique pour un diagnostic et un traitement précoces. En microscopie, la détection de petits objets est utilisée pour détecter et analyser la structure et le comportement d'organismes et de cellules microscopiques. Cela peut inclure la détection de protéines spécifiques, de structures cellulaires ou d'agents pathogènes.
Détection d'objets dans les grandes images panoramiques : conclusion
La création de modèles de vision par ordinateur pour la détection d'objets sur des photos panoramiques de villes à l'aide du framework SAHI constitue un domaine de recherche passionnant aux applications potentielles nombreuses. Le framework SAHI permet une détection d'objets précise et efficace dans les images, ce qui en fait un choix idéal pour le développement de modèles de vision par ordinateur destinés aux photos panoramiques. Avec la disponibilité croissante de photos panoramiques provenant de plateformes telles que Google Maps, les applications potentielles des modèles de détection d'objets pour les photos panoramiques de villes sont infinies.
Si vous souhaitez utiliser des modèles de détection d'objets de pointe dans votre produit, consultez notre page dédiée à l'Intelligence Artificielle et au Machine Learning et contactez-nous pour plus d'informations.
Ressources supplémentaires : Framework SAHI
La détection d'objets dans les grandes images panoramiques consiste à identifier et localiser des objets au sein de photographies à très haute résolution offrant un large champ de vision. Comme ces images sont bien plus grandes que les photos standard, des techniques de traitement spécifiques sont nécessaires pour les analyser efficacement.
Les principaux défis résident dans leur taille considérable, qui exige une puissance de calcul importante, et dans la difficulté à maintenir la précision lors de la détection de petits objets au sein de scènes vastes et détaillées.
Le tuilage d'images consiste à diviser un grand panorama en sections plus petites et plus faciles à gérer. Chaque section est traitée individuellement pour la détection d'objets, ce qui facilite la gestion des hautes résolutions et améliore les performances de détection.
Les outils courants incluent des frameworks d'apprentissage profond tels que TensorFlow et PyTorch, ainsi que des modèles de détection d'objets tels que YOLO et Faster R-CNN. Ceux-ci sont souvent combinés avec des pipelines de prétraitement personnalisés pour le traitement de grandes images.
Des secteurs tels que la surveillance de sécurité, la surveillance du trafic, la recherche environnementale et l'inspection industrielle peuvent tous grandement bénéficier des images panoramiques, qui permettent de surveiller de vastes zones et d'analyser les objets en détail.

Tirez parti de l'IA pour obtenir un avantage concurrentiel. Contactez notre expert pour discuter de vos besoins.
Tomasz Smolarczyk
Directrice de l'Intelligence Artificielle
arrow_circle_right Notre blog


