Automatiser l'étiquetage des données avec l'apprentissage par transfert
Pour soutenir l'analyse de la conduite autonome, nous avons construit des modèles de vision par ordinateur qui automatisent l'étiquetage des enregistrements routiers. La solution détecte et classe les panneaux de signalisation, réduisant le travail manuel de plusieurs jours à quelques minutes et permettant aux équipes de traiter beaucoup plus de données.

Services
Besoin métier
L'un de nos clients développait un outil d'analyse lié à la conduite autonome. Avec un nouveau projet en préparation, il était confronté à la tâche d'analyser le contenu d'enregistrements routiers. Cette tâche nécessitait le travail manuel de nombreuses personnes qui analysaient le parcours et marquaient de nombreux objets différents visibles sur celui-ci.
Un tel problème est très courant de nos jours. Le développement des méthodes de vision par ordinateur permet de résoudre plusieurs problèmes métier à la fois. Cependant, pour entraîner les modèles appropriés, nous devons disposer de données correctement étiquetées. Habituellement, nous avons besoin de grandes quantités de données pour entraîner un modèle de Deep Learning, ce qui implique une charge de travail élevée pour les annotateurs manuels.
La tâche de notre équipe consistait à créer des modèles ML permettant une automatisation partielle du processus d'étiquetage. Nous avons décidé de commencer par l'étiquetage des panneaux routiers.
Vision par ordinateur
Si nous comprenons aisément la capacité des machines à analyser un grand volume de données structurées, telles que des tableaux issus du scoring de crédit, le fait qu'une machine puisse reconnaître et comprendre une image ou une vidéo est en revanche bien plus contre-intuitif et impressionnant.
Avec les récents développements en matière de puissance de calcul et les méthodes d'apprentissage automatique toujours plus performantes, nous sommes déjà bien installés dans le territoire souvent associé aux livres et films de science-fiction. Voitures autonomes, reconnaissance faciale disponible dans un appareil que nous portons tous dans notre poche, machines décidant si une tache est visible sur les radiographies de nos poumons, ou si l'affection cutanée que nous venons de photographier est potentiellement dangereuse. Ce sont toutes des applications de la vision par ordinateur bien étudiées et opérationnelles.
La plupart d'entre eux peuvent être divisés en quelques catégories principales :
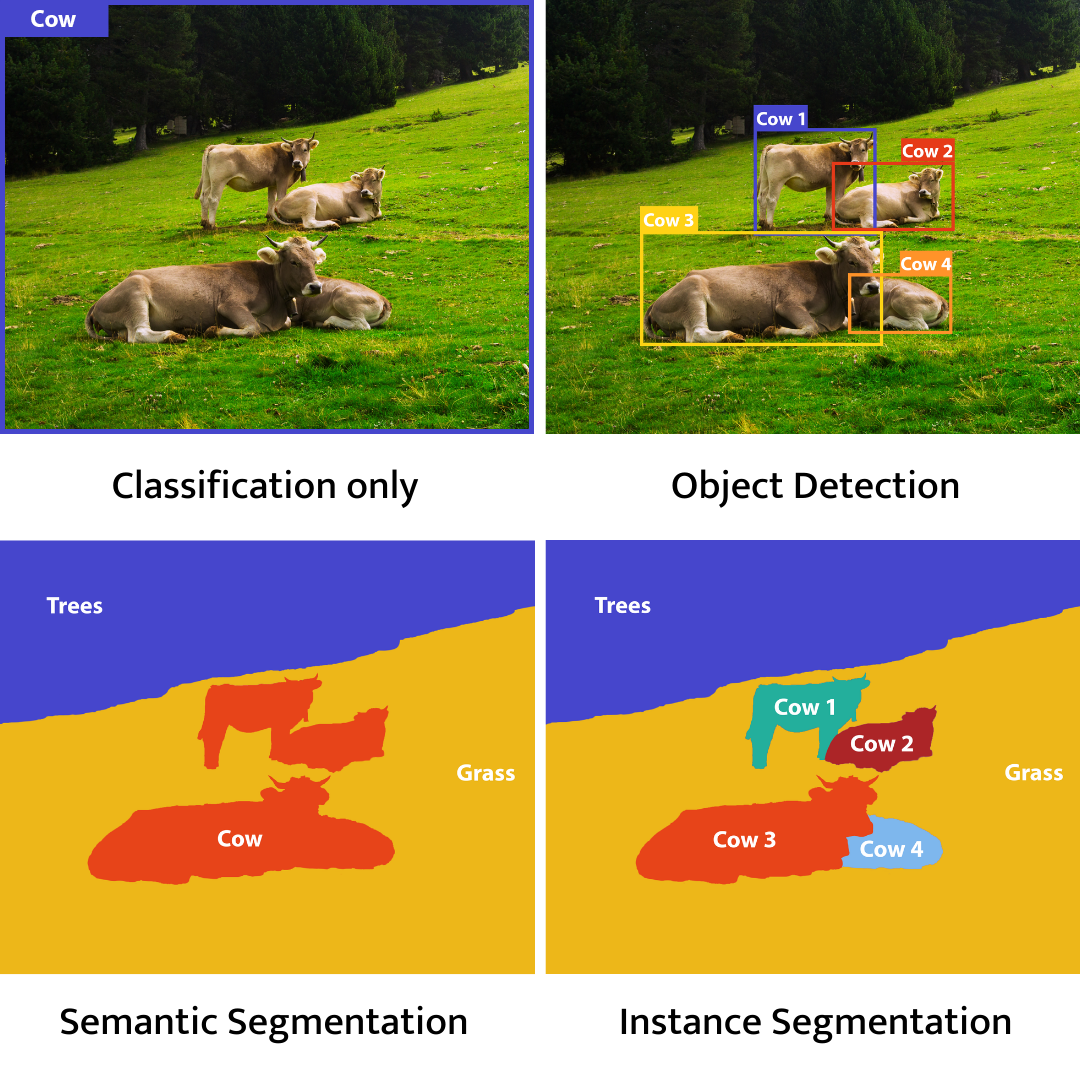
Classification d'images– La tâche des algorithmes de Deep Learning consiste à classer une image ou une vidéo dans une (ou plusieurs) classes. Avec ce type de modèle, nous pouvons, par exemple, déterminer si une lésion cutanée est maligne ou non (dans ce cas, une image est attribuée à l'une des deux classes – maligne, non maligne).
Détection d'objets– utilisé pour détecter les objets visibles sur l'image. Avec cette technique, nous pouvons, par exemple, détecter des personnes dans un enregistrement vidéo ou compter les cellules sanguines sur des images de microscope.
Segmentation– axée sur la partition d'une image en segments. Chaque pixel est classifié et regroupé en conséquence. Nous utilisons principalement ces méthodes pour localiser les contours dans les images.
- Segmentation sémantique– Nous attribuons une classe à chaque pixel et nous ne reconnaissons pas les instances distinctes des objets. Par exemple, si nous voyons plusieurs bâtiments, ils seront tous étiquetés comme « bâtiment » et aucune information n'indiquera de quel bâtiment il s'agit.
- Segmentation d'instances– Contrairement à la segmentation sémantique, nous considérons des instances d'objets. Nous classifions également chaque pixel, mais dans ce cas, nous tenons aussi compte des objets distincts. Dans cet exemple, nous numéroterons les bâtiments visibles sur l'image comme bâtiment n°1, bâtiment n°2, etc.
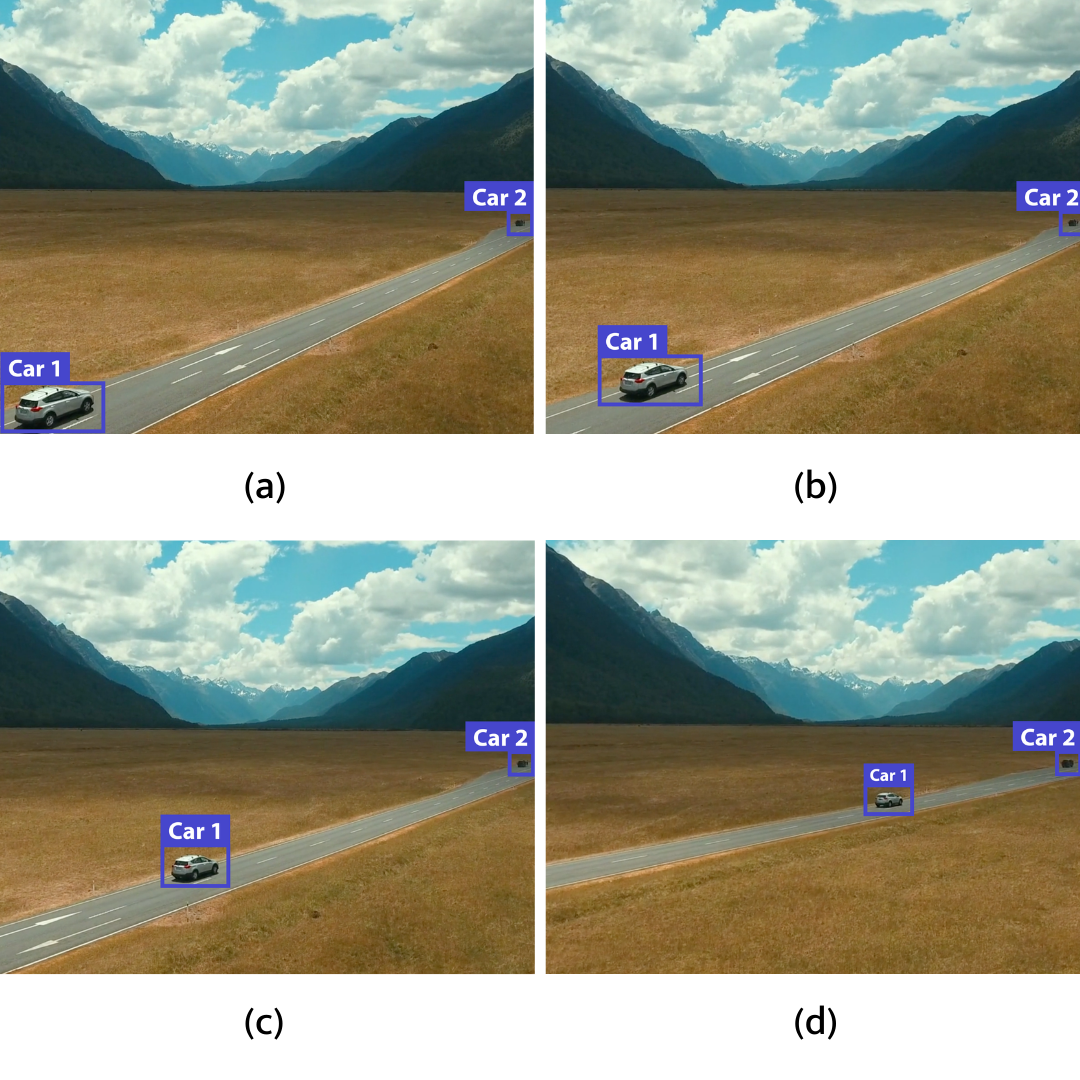
Suivi d'objets– En utilisant à la fois la détection et la classification, nous sommes également en mesure de suivre un objet donné. Si dans la vidéo nous voyons une voiture circuler dans la rue, nous pouvons suivre le mouvement avec l'information qu'il s'agit de la même voiture, et non d'une autre instance d'un nouvel objet.
Description de la solution
Nous avons examiné diverses approches durant la phase expérimentale du projet.
En fin de compte, nous avons décidé de créer deux modèles spécialisés distincts et d'exploiter le principe d'apprentissage par transfert.
Dans le cas des tâches de vision par ordinateur, l'apprentissage par transfert consiste généralement à utiliser des réseaux neuronaux préalablement entraînés comme base. Le réseau de base a été entraîné sur des ensembles de données massifs et a pu apprendre à reconnaître des formes et des motifs génériques. En utilisant un tel réseau, nous pouvons ensuite le réentraîner davantage pour répondre à notre besoin spécifique.
Présentons cette idée de manière plus illustrative à travers notre cas d'usage spécifique. Le réseau de neurones utilisé comme socle a été préalablement entraîné sur un nombre substantiel d'images et a appris à reconnaître des objets basiques du quotidien, tels que des voitures, des arbres et des fruits. Nous utilisons une partie de ce réseau pour résoudre notre problème.
Cette partie pourrait être capable de reconnaître très bien les formes, les couleurs et divers autres motifs. En utilisant un nombre réduit de photos de panneaux routiers marqués, nous sommes finalement en mesure d'entraîner davantage un tel réseau à reconnaître les panneaux routiers. Nous avons partiellement contourné le processus d'apprentissage, au cours duquel le réseau acquiert des connaissances sur les attributs de base de l'image. Grâce à cela, nous n'avons pas besoin d'une quantité aussi importante de données d'entraînement.
Dans notre solution, le premier modèle est axé sur la détection d'objets – trouver tous les panneaux routiers visibles dans les images extraites de l'enregistrement.
Après reconnaissance, les images des panneaux sont ensuite exportées et enregistrées. Ces images sont alors transmises au second modèle dont l'unique tâche est de classifier le panneau, c'est-à-dire de lui attribuer une signification et un contexte appropriés.
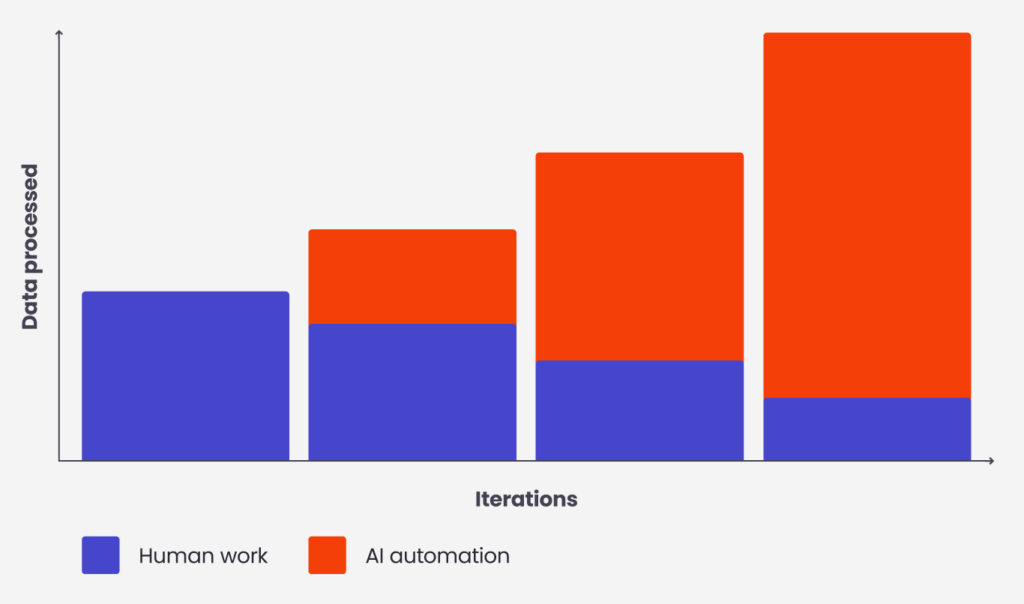
Combinés dans un seul pipeline, les deux modèles seront capables de reconnaître et de classer les panneaux routiers dans l'intégralité de l'enregistrement en quelques secondes. Grâce à cela, le travail effectué par les annotateurs peut être transféré vers l'analyse des prédictions du modèle et les corrections éventuelles. De cette manière, nous pouvons analyser un bien plus grand nombre d'enregistrements simultanément. Un avantage supplémentaire réside dans la livraison plus rapide de nouveaux points de données (images annotées), qui peuvent ensuite être utilisés pour réentraîner les modèles et améliorer leur efficacité.
Résultats de la collaboration
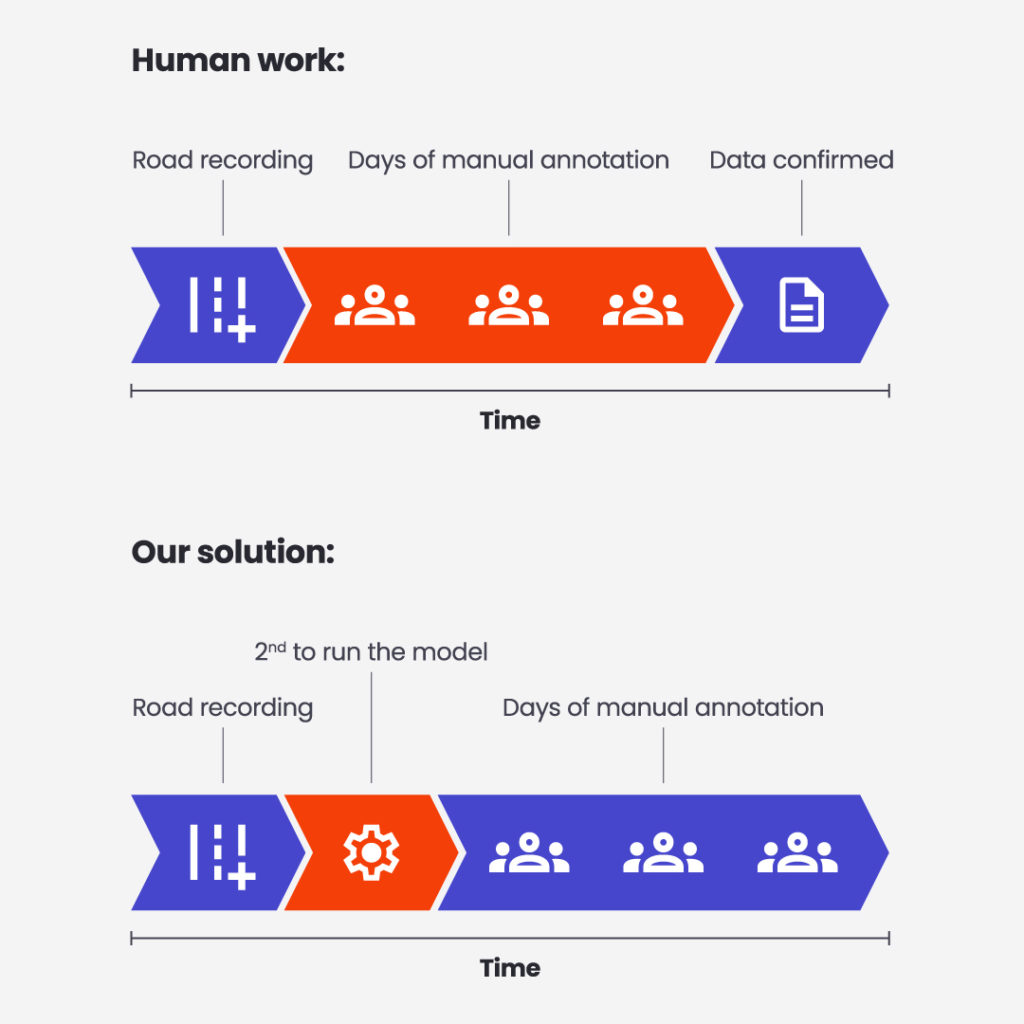
Au départ, notre client utilisait des enregistrements vidéo d'une route et de ses environs pour étiqueter manuellement les panneaux de signalisation visibles du point de vue d'un véhicule. L'étiquetage manuel nécessitait des journées de travail assidu de 4 employés. Ce n'est qu'une fois l'annotation terminée qu'ils pouvaient vérifier leurs étiquettes et confirmer les étiquettes finales.
Grâce à notre solution, au lieu de plusieurs jours de travail, nous étiquetons l'enregistrement en quelques minutes, et une seule personne est nécessaire pour vérifier les résultats du modèle. Cela nous permet de réaffecter la main-d'œuvre à la confirmation des prédictions, ce qui signifie que nous pouvons traiter un plus grand nombre d'enregistrements en même temps.
Des solutions similaires peuvent être utilisées pour de nombreuses tâches liées à la reconnaissance ou à la classification des motifs ou objets sélectionnés dans les images.
Si, dans un secteur donné, nous rencontrons des images susceptibles de nous fournir des informations – nous pouvons trouver une application pour des algorithmes d'IA similaires.
En outre, ces tâches sont de plus en plus soutenues par des solutions cloud. Un praticien des données disposant des compétences appropriées peut créer relativement rapidement les modèles nécessaires et mettre en œuvre unProof of Concept.
arrow_circle_right Études de cas
Découvrez les réussites de nos clients


arrow_circle_rightCONTACT
Planifions comment l'IA peut bénéficier à votre entreprise
Tomasz Smolarczyk
Directrice de l'Intelligence Artificielle