Faire fonctionner le traitement intelligent des documents dans le secteur bancaire – voici ce que nous avons découvert


Intelligent document processing – the use of AI to extract, validate, and route data – isn’t a new concept. Rules-based OCR, template matching, and classic workflow automation have been handling structured documents for years. But there are challenges where those tools fall short: processes involving variable document quality, ambiguous content, and exception-heavy logic. This is where generative AI makes a real difference.
Pourquoi le traitement intelligent des documents n'est jamais ce qu'il paraît sur le papier
Every intelligent document processing engagement has the same moment: somewhere in the early mapping phase, it becomes clear that the process extends far beyond the initial brief. Not because anyone was hiding anything, but because operational processes in large banks accumulate layers of logic, exceptions, and system dependencies that rarely make it into documentation.
Dans notre récent projet pour une grande banque, le processus consistait en la vérification des dossiers de nouveaux clients : s'assurer que la documentation adéquate était en place pour les clients particuliers et entreprises lors de l'onboarding.
Bien que les spécificités soient uniques, les schémas que nous avons rencontrés sont courants dans les processus à forte densité documentaire au sein d'environnements réglementés.
Sur le papier, il s'agit d'une vérification de l'exhaustivité des documents. En pratique, c'était un cycle de contrôle de 20 jours s'étendant sur quatre environnements distincts :
- les systèmes opérationnels des agences où travaillent les équipes de première ligne,
- un entrepôt de données central et un système d'information client,
- une application de contrôle dédiée,
- un référentiel documentaire.
À quoi ressemble réellement le processus en pratique
Systèmes avec différents rôles
The control application pulled data from a specific report, segmented records by client type (individual vs corporate) and then further divided them by legal form and entity structure. It ran an automatic check for minimum document completeness across the full population, then routed a subset to manual quality review. The document repository held the actual documents. The operational systems held the source data. The control application then tracked errors and resolution status – but it wasn’t the system where corrections were made.
Cette distinction – entre l'endroit où les erreurs sont détectées et celui où elles sont réellement corrigées – s'avère extrêmement importante lorsque vous concevez une couche d'automatisation.
Les chiffres qui définissent le défi
Le volume était substantiel : des dizaines de milliers de nouveaux dossiers par mois, la majorité concernant des clients individuels. Le contrôle automatique couvrait l'ensemble de la population, mais la revue qualité manuelle n'atteignait qu'environ 12-14 % des enregistrements. Cet écart entre la couverture complète et la capacité de révision humaine est exactement là où une couche d'IA bien conçue peut avoir un impact opérationnel réel. Mais uniquement si elle est construite avec une compréhension précise de ce que le processus exige réellement.
Pourquoi ce n'est pas qu'un problème d'OCR
Un autre facteur réside dans les documents eux-mêmes.
For individual clients, the document set is relatively structured: identity documents, completed forms, residency confirmations where applicable. For corporate clients, it becomes more varied. Depending on the legal form of the entity, the required documentation might include official registry extracts, business registrations, partnership agreements, board resolutions, powers of attorney, or non-standard documents specific to certain entity types. The business logic for what constitutes a complete folder is a matrix, or rather a matrix with exceptions.
La réalité physique des documents de production
A significant portion of what comes into this process isn’t a clean digital file. It’s a photograph taken on a phone, a low-resolution scan from a branch scanner, or occasionally a handwritten document. Multi-page PDFs are common for corporate documents – especially in the case of complex entities, where they can extend across dozens of pages.
This is why framing IDP as an “OCR problem” is misleading. Classic OCR works well for predictable, well-structured documents. However, it struggles with layout variability, ambiguous content, or unseen formats. When fields appear in unexpected places, the document is partially handwritten, or the business logic depends on context – rules-based systems break down. They either return a wrong answer or no answer, with no mechanism to express uncertainty.
Generative AI models approach this differently. They interpret documents in context, handle ambiguity, and extract meaningful information from document types they haven’t been explicitly trained on. They don’t require a rigid template for every variation – they just need a clear definition of what to look for and the ability to express how confident they are in what they found.
The key is knowing where to apply it. GenAI is most effective in handling ambiguous, variable, and exception-heavy documents – not as a universal replacement. Well-designed automation uses GenAI where it adds value and simpler, cheaper tools everywhere else.
Une IA qui s'adapte à votre environnement, et non l'inverse
Planifier un rendez-vous avec un conseiller en IA
Là où la plupart des couches d'automatisation échouent
1. La faille de la boucle de contrôle
There’s a distinction that’s easy to miss and expensive to discover late: the system that detects errors and tracks their status is not the same as the one where corrections are actually made. As a result, a “resolved” status often reflects a process update – not confirmation that the underlying data has been fixed at the source.
Pour l'automatisation qui s'appuie sur ces indicateurs d'état pour déclencher les étapes suivantes, cela crée un risque réel : le processus peut avancer même si les données restent incorrectes.
Pour y remédier, nous avons introduit une étape de vérification supplémentaire qui confirme si la correction a été appliquée dans le système source (et non simplement marquée comme résolue). Cela comble une lacune souvent négligée dans la conception des solutions IDP.
2. Les enregistrements qui sortent du processus
Records that fail the automatic document completeness check don’t re-enter the standard manual quality review path. They’re handled separately – or not systematically handled at all. At the volumes involved, that’s a meaningful number of cases every month sitting outside structured review, with no systematic picture of what’s failing or why.
Part of what we designed for was bringing these records into a structured AI-assisted triage workflow, so that cases which previously fell through the cracks could be reviewed, categorised, and resolved through the same quality process as everything else. It’s about making sure those cases are visible and consistently handled rather than quietly accumulating outside the main flow.
Notre approche
L'architecture que nous avons développée reflète la complexité réelle du processus plutôt qu'une version idéalisée de celui-ci. Chaque couche répond directement aux contraintes observées dans le processus décrit ci-dessus.
Parce que nous avons conçu la solution spécifiquement pour l'environnement du client, elle s'adapte aux flux de travail et aux dépendances système existants, plutôt que de forcer le processus à s'adapter à un outil prédéfini.
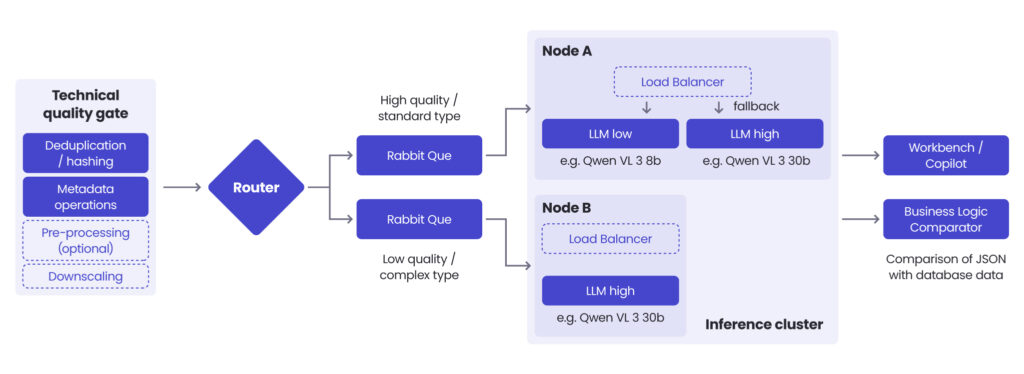
Niveau 1 : Portail qualité
The first layer is pre-processing: a quality gate that every document passes through before any AI inference happens. This stage handles contrast enhancement to improve readability, deduplication, format validation, and basic checks that eliminate empty or corrupt files. Every document filtered here is inference budget saved. Every document that arrives at the model in better condition produces more reliable output.
Couche 2 : Routage des documents vers le bon modèle
Not all documents are equal. Treating them as if they are is expensive and inaccurate. Documents assessed as higher quality (cleaner scans, standard formats, legible content) are routed to a smaller, faster, cheaper model. More ambiguous documents (poor scan quality, handwritten elements, unusual formats) go to a larger, more capable model. Routing based on document quality means spending a compute budget where it actually matters.
Remarque : L'IA générative est une couche de cette solution. Les types de documents plus simples, avec un formatage propre et cohérent, peuvent ne jamais nécessiter de grand modèle génératif. L'architecture est conçue pour appliquer l'IA générative précisément là où ses capacités sont nécessaires.
Couche 3 : Extraction structurée et notation de confiance
The model receives a document (or in the case of multi-page PDFs, a sequence of page images) along with predefined field definitions that tell it what to look for. Output is structured JSON: each field populated with an extracted value and a confidence score. For an identity card, that means name, date of birth, document number, expiry date. For a KRS extract, it means registered entity name, partner details, authorisation dates, legal form classification, and other fields specific to the entity type.
Le score de confiance détermine ce qui se passe ensuite. Les extractions à haute confiance sont recoupées automatiquement avec ce qui existe déjà dans le système. Les extractions à faible confiance sont transmises à un réviseur humain.
L'interface de revue humaine
That reviewer interface is built around a principle we consider non-negotiable: the reviewer needs to see not just what the model extracted, but where in the document that information came from. This grounding (showing the source location alongside the proposed value) is what makes human review efficient and reliable. Without it, you’re asking a person to re-do the work the model was supposed to assist with.
Compétences pour les agents IA
Dans le cadre de ce projet, nous avons développé des compétences dédiées pour le agents IA involved in document processing. In agentic AI design, a skill is a reusable capability module that an agent draws on when it identifies a situation matching the skill description – in this case, specific document types or processing tasks. Building them as modular components rather than hardcoded logic means the system can be extended to new document types without redesigning the underlying pipeline. Well-designed agentic systems separate what an agent knows how to do from the specific task it’s currently executing – and that separation is what makes them maintainable and scalable in production.
En savoir plus sur les agents IA d'entreprise et les systèmes multi-agents
Accéder à l'article
Ce que nous cherchions à valider
L'architecture ci-dessus a été façonnée par trois questions de validation spécifiques auxquelles notre solution devait répondre.
The first was whether the pipeline could handle real production documents – not clean samples, but the actual variety of inputs this process sees: low-quality scans, multi-page PDFs, handwritten content, and documents across different entity types. For this, we ran technical validation on a set of document types covering both individual and corporate onboarding scenarios: including identity documents and multi-page corporate registry records. Both were processed using a vision-capable multimodal model, with PDFs converted into sequence of images, as required by the production pipeline.
The results? All predefined fields were successfully extracted into structured JSON output with field-level confidence scores. For identity documents, this includes fields such as name, date of birth, document number, and expiry date. For corporate records, the model correctly identified entity names, partner details, authorisation dates, and legal structure classifications. Confidence scoring behaved as intended, clearly separating high-certainty outputs from those requiring human review, even with real-world variation in document quality.
La deuxième question était de savoir si la solution pouvait fermer la boucle de contrôle entre l'application de contrôle et les systèmes sources – non pas simplement signaler les erreurs, mais vérifier que les corrections avaient été apportées là où cela était nécessaire.
La troisième portait sur la question de savoir si les enregistrements échouant au contrôle automatique de complétude pouvaient être intégrés à un flux de travail de révision structuré plutôt que traités en dehors du processus principal.
À quoi ressemble la réalité de l'infrastructure
Même une architecture bien conçue échoue si elle ne peut pas fonctionner dans les contraintes d'infrastructure de la banque.
Sending customer documents to a public API isn’t an option in a regulated banking environment. The solution needed to run entirely on infrastructure the bank controls, without external connectivity – an air-gap deployment. Documents stay inside the bank’s perimeter. Models run on bank-managed hardware. Running capable vision models on-premise requires appropriate hardware: GPU infrastructure, configuration, and ongoing management.
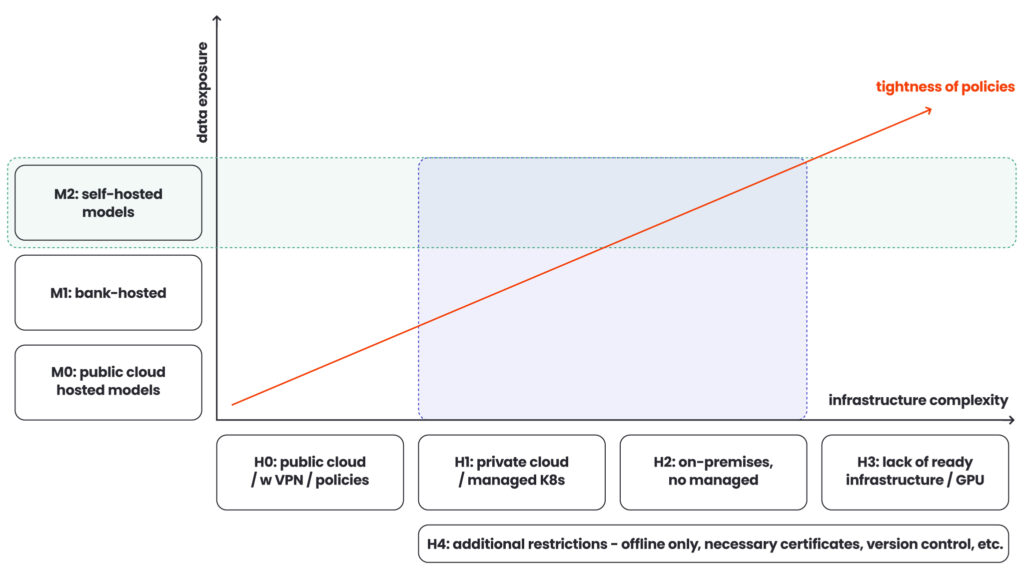
Que la banque dispose déjà de machines adaptées ou qu'elle doive s'en procurer est une variable qui doit figurer dans l'estimation du projet dès le départ – la découvrir tardivement transforme un budget approuvé en une conversation à rouvrir.
Hébergement de modèles : trois options aux compromis différents
Banks also need to make real choices about how they host models – whether the infrastructure team manages them centrally, operational teams deploy and manage them directly, or the bank runs them in a controlled cloud environment with appropriate data boundaries. Each option has different cost, operational complexity, and risk profiles. If you clarify this during the engagement, rather than after you set up the architecture, you’ll avoid the most common source of late-stage project friction.
| HÉBERGÉ DANS LE CLOUD PUBLIC | HÉBERGÉ PAR LA BANQUE | AUTO-HÉBERGÉ (SUR SITE) | |
| Qui gère le modèle | Fournisseur cloud | l'infrastructure ou l'équipe informatique de la banque | Équipes opérationnelles ou ML ops dédiées sur site |
| Où les données restent | Environnement du fournisseur, régi par les politiques DLP et les limites contractuelles | À l'intérieur du périmètre cloud contrôlé de la banque | Matériel détenu par la banque, entièrement isolé du réseau |
| Complexité opérationnelle | Faible (aucune infrastructure à posséder ou à maintenir) | Moyen (nécessite Kubernetes managé ou une capacité de cloud privé) | Élevé (infrastructure GPU, configuration, gestion continue) |
| Risque de conformité | Élevé (contrôles de politique robustes pour respecter les règles de résidence des données bancaires) | Faible-moyen (limites de données contrôlées par la banque) | Le plus faible (les documents ne quittent jamais le périmètre physique de la banque) |
| Idéal pour | Équipes déjà présentes sur le cloud public avec des politiques DLP solides et des périmètres de données approuvés par les autorités de régulation | Banques disposant déjà d'un cloud privé (par exemple OpenShift/K8s) et d'une équipe d'infrastructure centrale | Banques ayant les exigences les plus strictes en matière de résidence des données et une infrastructure GPU sur site existante |
Conclusion
Most organisations considering an IDP project in a regulated environment already know they have a document problem. What they underestimate is the real complexity lying beyond the documents – in process logic, system dependencies, infrastructure constraints, and gaps that only emerge once you’ve mapped the full flow.
This is where the right partner makes a difference. Not in selecting a model or building a pipeline, but in defining the true scope before development starts. That includes uncovering hidden dependencies, edge cases, control gaps, and architectural constraints.
Si cette étape est omise, vous risquez d'investir dans une solution conçue pour le problème tel qu'il apparaît sur le papier, et non tel qu'il existe en production.
Les projets réussis commencent par poser les bonnes questions difficiles dès le départ. C'est là que nous commençons.
If you’re considering an IDP project and want to understand the real scope before committing to an approach – not just the technology, but the process, the architecture, and the implementation model – we’re happy to have that conversation. Fill in the form below to get in touch with our expert.
FAQ : le traitement intelligent des documents dans le secteur bancaire
Intelligent document processing goes beyond traditional optical character recognition by combining artificial intelligence, machine learning, and natural language processing to extract data from both structured and unstructured documents. Unlike classic tools that rely on fixed templates, intelligent document processing solutions can interpret context, handle unstructured data, and adapt to varying document formats, making them far more effective for real-world document processing workflows.
Modern intelligent document processing software is designed to process unstructured documents such as contracts, registry extracts, or scanned documents with inconsistent document layouts. It uses machine learning and natural language processing to identify relevant data fields and convert them into usable digital data, even when the structure is unclear. This makes it possible to reliably process data from complex business documents that would otherwise require extensive manual document processing.
Not entirely, but it can significantly reduce it. Intelligent document processing minimises manual data entry by automating data capture, data validation, and document classification. However, manual intervention is still required for low-confidence cases or edge scenarios. The goal is not elimination, but reducing manual data entry, lowering human error, and removing repetitive data entry from core business workflows.
Le traitement automatisé de documents peut gérer une large gamme de formats, notamment :
– Documents papier et documents numérisés
– Formulaires structurés (par ex. formulaires d'onboarding)
– Documents non structurés (par ex. contrats, dossiers juridiques)
– Fichiers spécifiques au domaine tels que les données de facturation ou les dossiers patients
La capacité à traiter à la fois des données structurées et des données non structurées est ce qui rend le traitement intelligent des documents particulièrement précieux dans le secteur bancaire.
Data validation ensures that extracted relevant data is accurate and consistent with existing business systems. In intelligent document processing solutions, extracted values are cross-checked against source systems or business rules. This step is essential to maintain data integrity, especially in regulated environments where incorrect data capture can impact downstream business processes.


arrow_circle_rightContactez-nous
Obtenez une évaluation honnête – parlez à notre expert en IA
Tomasz Smolarczyk
Directrice de l'Intelligence Artificielle
arrow_circle_right Nos articles




