كشف الأجسام في الصور البانورامية الكبيرة


تزداد شعبية الصور البانورامية في عالم اليوم، لا سيما عند استكشاف المدن باستخدام أدوات مثل Google Street View. ومع التطور السريع لتقنيات الرؤية الحاسوبية، أصبح من الممكن الآن بناء نماذج متطورة لكشف الأجسام في الصور البانورامية للمساعدة في تحديد وتحديد مواقع الأجسام المختلفة فيها.
في هذه المقالة، سنستكشف كيفية بناء نماذج الرؤية الحاسوبية لكشف الأجسام للصور البانورامية باستخدام إطار عمل SAHI (Slicing Aided Hyper Inference) وسنناقش أمثلة على المجالات التي يمكن استخدام مثل هذه النماذج فيها. سنركز على تحديد وكشف لافتات المرور وغيرها من ميزات البنية التحتية لشبكة الطرق.
تحديات العمل مع الصور البانورامية
تطرح الصور البانورامية للمدن، كما في Google Street View، تحديات فريدة عند بناء نماذج التعرف على الكائنات واكتشافها. ومن أبرز هذه التحديات الحجم الكبير للصور. فقد يبلغ عرض هذه الصور آلاف البكسلات، مما يجعل معالجتها بكفاءة أمراً صعباً.
هناك تحدٍ آخر يأتي مع بناء نماذج الرؤية الحاسوبية لكشف الأجسام في الصور البانورامية، وهو صغر حجم الأجسام نسبةً إلى دقة الصورة الإجمالية. في بعض الحالات، قد تشكل الأجسام في الصور البانورامية أقل من 0.1% من مساحة الصورة بأكملها، مما يجعل كشفها وتحديدها وتحليلها صعباً للغاية.
عندما تكون الكائنات صغيرة، قد لا تكون دقة الصور عالية بما يكفي لتوفير مستوى التفاصيل المطلوب للكشف الدقيق عن الكائنات أو تصنيف الصور. بالإضافة إلى ذلك، يمكن أن يجعل الحجم الصغير للكائنات من الصعب تمييزها عن خلفية الصورة، مما قد يزيد من تعقيد إجراء الكشف. يمكن أن يساعد تحليل مناطق محددة من الصورة في عزل الكائنات الصغيرة وتحديدها من الخلفيات المعقدة، مما يحسّن دقة الكشف.
نمذجة الرؤية الحاسوبية للكشف عن الأجسام
يتطلب بناء نماذج اكتشاف الأجسام للصور البانورامية عدة خطوات رئيسية. أولًا، كان علينا الحصول على مجموعة بيانات من الصور البانورامية التي استخدمناها بعد ذلك لتدريب نموذجنا.
إعداد البيانات وتصنيف الصور
يُعد إعداد البيانات خطوة حاسمة في بناء نموذج دقيق وفعّال للكشف عن الأجسام في الصور البانورامية. ويتضمن ذلك جمع ووسم مجموعة كبيرة من الصور البانورامية التي ستُستخدم لتدريب نموذج الكشف عن الأجسام. وفي هذه الحالة تحديدًا، تم وسم بضع مئات من الصور البانورامية يدويًا بعلامات المرور وإشارات المرور وصنابير الحريق ومعالم البنية التحتية للطرق وتسميات أخرى ذات صلة.
يُعد وضع العلامات على الصور يدويًا تقنية مستهلكة للوقت، لكنها ضرورية لتدريب نموذج دقيق للكشف عن الأجسام. يتيح وضع العلامات على كل جسم في الصورة للنموذج التعرف على كل جسم وتصنيفه بدقة عند تقديم صور جديدة. بالإضافة إلى ذلك، تُمكّن البيانات المُعلَّمة النموذج من تصنيف الصور عبر إسنادها إلى فئات محددة مسبقًا بناءً على الأجسام الموجودة فيها.
بعض الإحصاءات حول الصور ومربعات التحديد لمجموعة البيانات الخاصة بنا:
- مجموعة التدريب:
- 500 صورة بانورامية
- 1998 تعليق توضيحي للإطار المحيط
- مجموعة الاختبار:
- 250 صورة بانورامية
- 1045 تعليق توضيحي للإطار المحيط
كانت مجموعات البيانات غير متوازنة بدرجة كبيرة، كما يظهر في الأشكال أدناه. لا يمكن رؤية سوى 29 حالة لعلامات حدود السرعة في مجموعة بيانات التدريب. بالإضافة إلى ذلك، كان أكثر من 80% من صناديق الإحاطة أصغر من 50×50 بكسل. وهذا سياق بالغ الصعوبة لجميع كاشفات الأجسام.
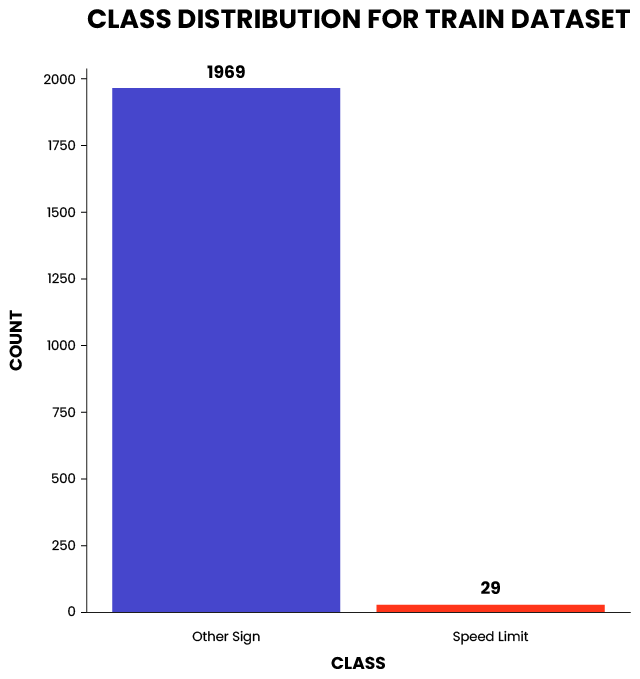
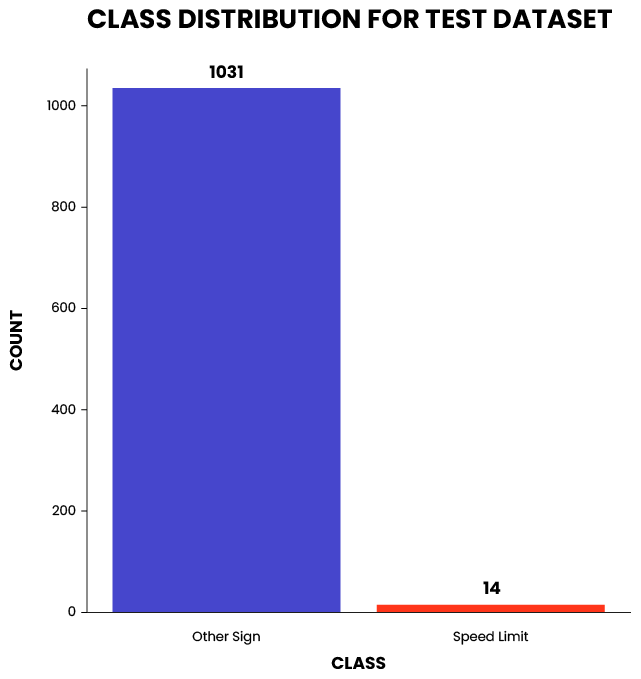
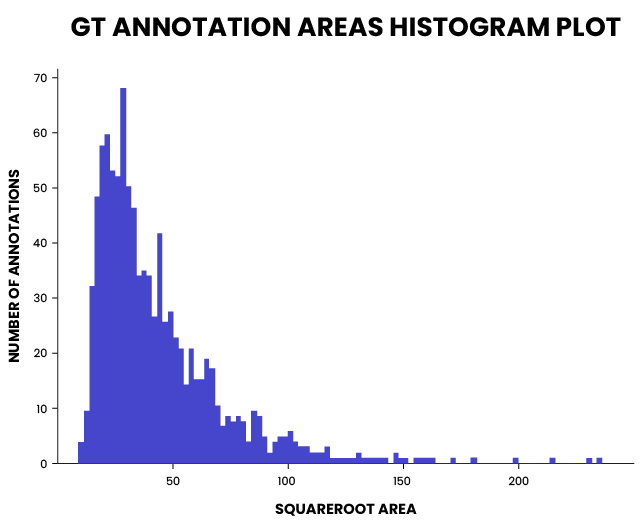
كانت مجموعات البيانات غير متوازنة بدرجة كبيرة، كما يظهر في الأشكال أدناه. لا يمكن رؤية سوى 29 حالة لعلامات حدود السرعة في مجموعة بيانات التدريب. بالإضافة إلى ذلك، كان أكثر من 80% من صناديق الإحاطة أصغر من 50×50 بكسل. وهذا سياق بالغ الصعوبة لجميع كاشفات الأجسام.
كما ترى، كانت هذه عينة صغيرة جداً من البيانات – فعادةً ما نتعامل مع آلاف أو حتى مئات الآلاف من الصور. ومع ذلك، نظراً للحجم الكبير للمناظر البانورامية والحجم الصغير جداً للكائنات التي كنا نصنّفها، استغرق تصنيف تلك الصور السبعمائة والخمسين أكثر من ثلاثة أيام عمل.
بالنسبة لنماذج الإنتاج واسعة النطاق، عندما تحتاج آلاف أو ملايين الصور إلى وضع العلامات، نوصي بأتمتة هذه العملية باستخدام التعلم بالنقل والتكرارات السريعة.
لمعرفة المزيد حول وضع العلامات الآلي على البيانات وتصنيف الصور وتجزئة الحالات، اطلع على مقالتنا. >>
نموذج عائلة YOLO
في حالتنا، اخترنا استخدام عائلة نماذج YOLO. YOLO هي عائلة من نماذج اكتشاف الأجسام التي اكتسبت شعبية مؤخرًا. بصفتها نماذج تعلم عميق وشبكات تعلم عميق، تُستخدم YOLO ومتغيراتها على نطاق واسع في مهام اكتشاف الأجسام. يرمز YOLO إلى "You Only Look Once". استخدمنا YOLOX، وهو ترقية لنموذج YOLO الأصلي. يعتمد YOLOX على بنية شبكة عصبية التفافية وهو نوع من الشبكات العصبية المُحسَّنة لاكتشاف الأجسام. يشتهر YOLOX بأدائه السريع والدقيق في آنٍ واحد، مما يجعله مناسبًا تمامًا لاكتشاف الأجسام في الصور البانورامية.
من أبرز مزايا YOLOX قدرته على تحقيق دقة عالية مع الحفاظ على أوقات استدلال سريعة (أسرع من EfficientDet). ويتحقق ذلك من خلال عدد من التحسينات، مثل الكشف عن الأجسام بدون مراسي، وتحسين استخلاص الميزات، والاستخدام الأكثر كفاءة للذاكرة. تعالج YOLOX خرائط الميزات على مستويات متعددة لتمكين الكشف متعدد المقاييس.
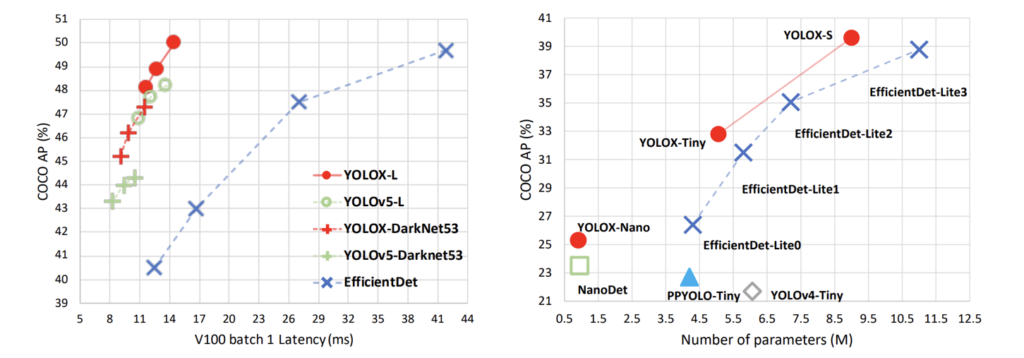
بشكل عام، يُعد كاشف الأجسام YOLOX مناسبًا تمامًا للاستخدام في الصور البانورامية وقد ثبت أنه يحقق أداءً متطورًا في مجموعة متنوعة من مهام رؤية الحاسوب لكشف الأجسام. YOLOX هو أحد عدة نماذج لكشف الأجسام، وهناك طرق متنوعة لكشف الأجسام في هذا المجال. تجعله سرعته ودقته خيارًا شائعًا لمجموعة متنوعة من التطبيقات الواقعية، من المركبات ذاتية القيادة إلى أنظمة المراقبة. يقوم YOLOX بتصنيف الأجسام وتحديد مواقعها في تمريرة واحدة. يمكنه التعامل مع فئات متعددة وتقسيم مساحة الإخراج لاكتشاف فعال.
إطار عمل SAHI لتدريب الرؤية الحاسوبية
أحد الأساليب لتدريب نماذج اكتشاف الأجسام للصور البانورامية التي حققت نتائج رائعة لنا هو إطار Sliced Aided Hyper Inference (SAHI). في حالتنا، تضمّن SAHI تقسيم الصور إلى رقع متداخلة وتدريب نماذج اكتشاف الكائنات على تلك الرقع. وبعد التدريب، يُستخدم النموذج لإجراء التنبؤ على الصور الكاملة باستخدام الاستدلال المُجزّأ.
يُعد مفهوم الاستدلال المُجزأ محورياً في إطار عمل SAHI. في جوهره، يتضمن الاستدلال المُجزأ إجراء استدلال اكتشاف الكائنات على أجزاء أصغر من الصورة البانورامية الأصلية ثم دمج التنبؤات المُجزأة لتوليد مخرجات اكتشاف كائنات كاملة للصورة الأصلية. وتُوضح العملية أدناه:
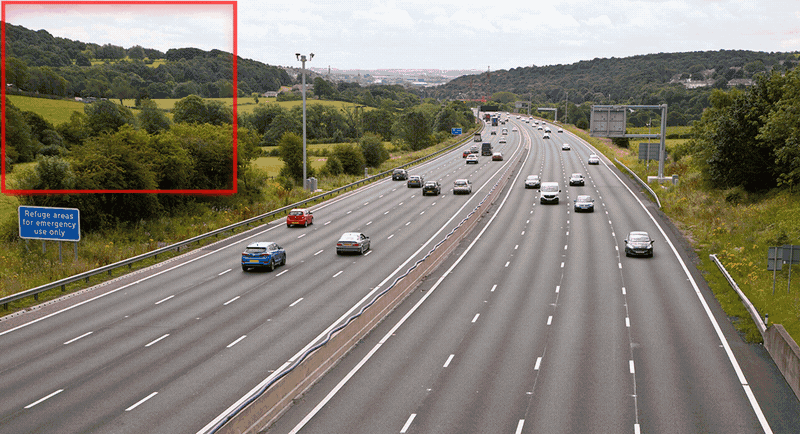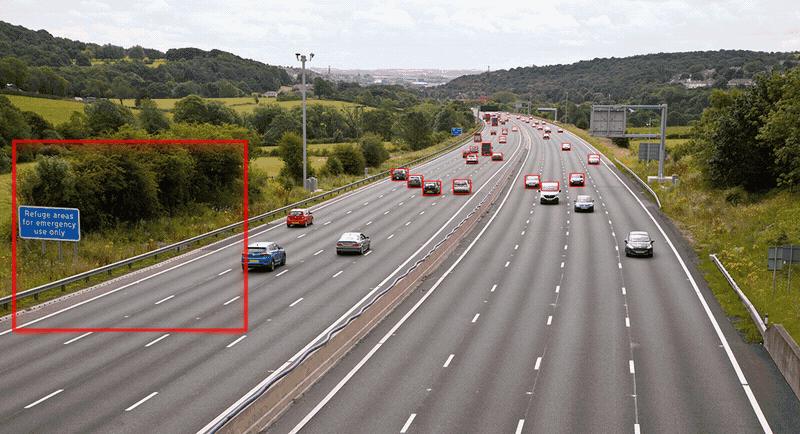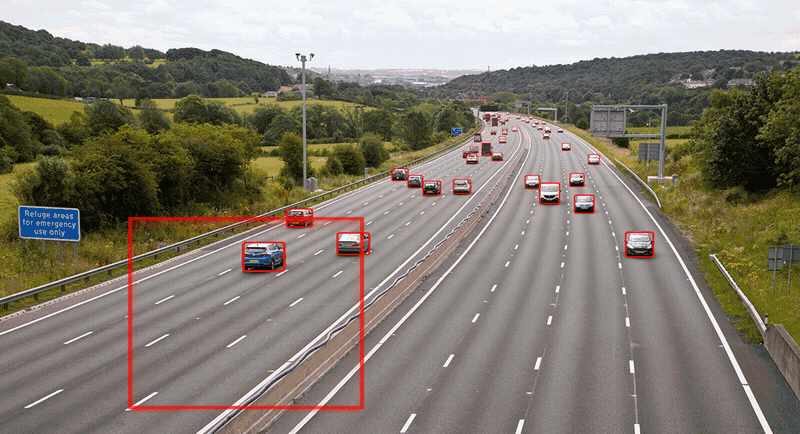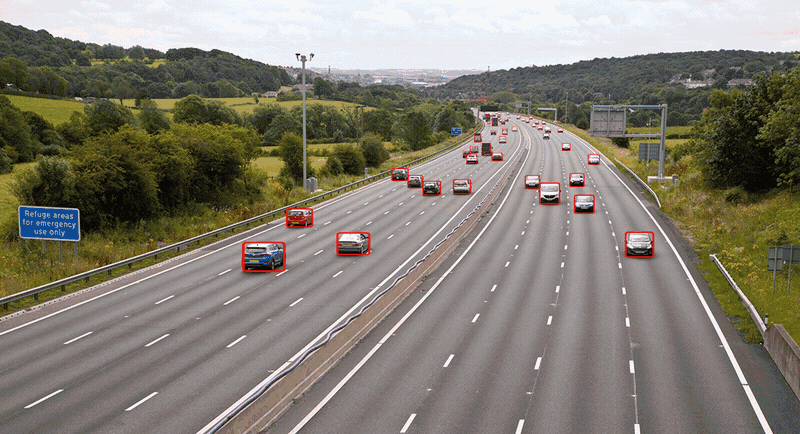
من خلال تقسيم الصورة البانورامية إلى شرائح أصغر والتدريب عليها، يمكن لنموذج اكتشاف الكائنات التعامل بسهولة أكبر مع تحديات الحجم الكبير للصورة وصغر حجم الكائنات، وهي تحديات شائعة عند التعامل مع الصور البانورامية. بالإضافة إلى ذلك، يوفر إطار عمل SAHI آلية لتوحيد التنبؤات التي يولّدها النموذج على الشرائح الفردية، مما يؤدي إلى مخرجات اكتشاف كائنات أكثر دقة وشمولاً للصورة البانورامية بأكملها.
استخدام SAHI سهل مثل استيراده واستدعاء دالة واحدة من خلال تزويده بمواصفات النموذج المدرَّب لدينا ومسار البيانات. ويتولى إطار عمل SAHI الباقي، وتُحفظ النتائج في دليل من اختيارنا. وفيما يلي مقتطف من الكود النموذجي.
from sahi.predict import predict predict( model_type="mmdet", model_path="path/to/model/file.pth", model_config_path="path/to/model/config.py", model_device="cuda:0", model_confidence_threshold=0.25, slice_height=512, slice_width=512, overlap_height_ratio=0.2, overlap_width_ratio=0.2, source="test-images", project="test-images-predictions" )يمكن الاطلاع على مثال للتنبؤ أدناه. لاحظ أنه حتى لافتات المرور الصغيرة جداً في الخلفية يتم اكتشافها بدرجة عالية من الثقة.


بشكل عام، أثبت إطار عمل SAHI أنه نهج فعال لتدريب نماذج اكتشاف الأجسام للصور البانورامية، مما يتيح تحسين الدقة مقارنةً بتقنيات اكتشاف الأجسام التقليدية.
بدائل SAHI
تشمل بعض الأساليب البديلة للكشف عن الأجسام في الصور واسعة النطاق ما يلي:
- تغيير حجم الصورة: في هذا النهج، يُعاد تحجيم الصورة المدخلة إلى حجم أصغر قبل معالجتها بواسطة خوارزمية اكتشاف الكائنات. وقد يقلل ذلك من التعقيد الحسابي للخوارزمية، لكنه قد يؤدي أيضًا إلى دقة أقل، خاصةً بالنسبة للكائنات الصغيرة.
- الأساليب القائمة على المناطق: في هذا الأسلوب، يتم أولاً تقسيم الصورة إلى مناطق ذات أهمية، ثم يتم تطبيق خوارزمية اكتشاف الكائنات على كل منطقة على حدة. يمكن أن يكون هذا طريقة فعالة لتقليل التعقيد الحسابي للخوارزمية، لكنه قد يؤدي أيضاً إلى تفويت عمليات الاكتشاف إذا لم يتم تحديد مناطق الاهتمام بشكل صحيح.
- معماريات متخصصة لكشف الأجسام: كاشفات الطلقة الواحدة المدمجة الميزات (FFSSD), كاشف متعدد المقاييس أحادي الطلقة بإزالة الالتفاف (MDSSD) or QueryDet يمكن استخدامها، ومع ذلك، فإن هذه الأساليب ليست سائدة وعادة ما تتطلب استثمارات عالية في كل من البحث في نتائج الأوراق العلمية وإعادة إنشاء الشبكة وإعادة تدريبها.
في حالتنا، لم نرغب في التضحية بين دقة النموذج وصعوبة التنفيذ، لذا اخترنا استخدام SAHI لأغراضنا.
قيود SAHI لنماذج اكتشاف الكائنات
على الرغم من أن إطار عمل SAHI أثبت فعاليته كنهج لتدريب نماذج اكتشاف الأجسام على الصور البانورامية، إلا أنه يأتي ببعض القيود. ويتمثل أحد التحديات الرئيسية في استخدام SAHI في زيادة زمن الاستدلال وقوة الحوسبة المطلوبة، نظرًا للحاجة إلى معالجة رقع متعددة من الصور ودمج التنبؤات الناتجة.
يمكن استخدام عدة استراتيجيات محتملة للتخفيف من متطلبات سرعة الاستدلال والقدرة الحاسوبية المتزايدة لـ SAHI. أحد الأساليب هو تحديد الجزء من الصورة الذي تتم معالجته بواسطة نموذج اكتشاف الأجسام.
على سبيل المثال، يؤدي إزالة 25% العلوية و25% السفلية من الصورة إلى تقليل عدد الرقع (patches) اللازمة لتوليد تنبؤات جيدة. وتبرير إزالة هذه الأجزاء من الصورة في حالتنا قائم، حيث تحتوي عادةً الأجزاء العلوية والسفلية من صورة البانوراما على السماء وسطح الطريق على التوالي. كما تحدث معظم التشوهات الناتجة عن تأثير العين السمكية في تلك المناطق. وبإدراج رقع من تلك المناطق، فإننا نهدر القدرة الحسابية فقط، إذ لا يستطيع النموذج اكتشاف تجهيزات الطريق بفعالية – مما يؤدي إلى عدد أكبر من الإيجابيات الكاذبة.
استراتيجية أخرى هي تحسين إطار عمل SAHI لتحسين كفاءته. وقد يتضمن ذلك تحسين نموذج اكتشاف الكائنات نفسه، بالإضافة إلى خطوات المعالجة اللاحقة المستخدمة لدمج التنبؤات التي يولّدها النموذج على رقع الصور الفردية (يستخدم تطبيق SAHI الحالي معالجة الرقع بشكل تسلسلي بدلاً من المعالجة على دفعات).
بالإضافة إلى ذلك، يمكن للتطورات في الأجهزة، مثل استخدام وحدات المعالجة المتخصصة كوحدات معالجة الرسومات (GPUs) أو وحدات معالجة الموترات (TPUs)، أن تساعد أيضًا في تعزيز سرعة الاستدلال وتقليل متطلبات القدرة الحاسوبية لنماذج اكتشاف الأجسام القائمة على SAHI.
بشكل عام، في حين يمكن أن تكون SAHI نهجًا قويًا لتدريب نماذج اكتشاف الأجسام للصور البانورامية، فمن المهم مراعاة القيود المحتملة لهذا الإطار، واستكشاف استراتيجيات للتخفيف من هذه القيود لتحقيق الأداء الأمثل.
اكتشف المزيد عن خدمات الرؤية الحاسوبية لدينا
عرض المزيد
أمثلة على استخدام كاشفات الأجسام الصغيرة جدًا والصور الكبيرة
على الرغم من التحديات المرتبطة بالعمل مع الصور البانورامية أو اكتشاف الأجسام الصغيرة جدًا، هناك عدة أمثلة على كيفية استخدام نماذج اكتشاف الأجسام لتقديم فوائد واقعية.
المركبات ذاتية القيادة
يمكن استخدام نماذج اكتشاف الكائنات في المركبات ذاتية القيادة لتحديد الكائنات داخل البيئة، مثل المشاة والسيارات وعلامات المرور وغيرها من معالم البنية التحتية. وفي البيئات الحضرية، توفر الصور البانورامية ثروة من المعلومات حول المحيط، مما يجعلها مصدر بيانات ممتازًا للأنظمة التي تكتشف الكائنات المختلفة على الطريق.
أنظمة الأمان
يمكن لأنظمة الأمن استخدام نماذج كشف الأجسام لتحديد التهديدات المحتملة داخل المدينة. على سبيل المثال، يمكن لكاميرات المراقبة (CCTV) المثبتة في الأماكن العامة استخدام هذه الأساليب لكشف الأشخاص وتحديد السلوك المشبوه، مثل حمل شخص لسلاح أو التصرف بشكل غير منتظم.
المعلومات الجغرافية المكانية
يمكن للتطبيقات الجيومكانية، مثل اكتشاف الأجسام من صور الأقمار الصناعية، أن تستفيد أيضاً من استخدام كاشفات الأجسام الصغيرة جداً. في الواقع، يُعدّ اكتشاف وتصنيف الأجسام الصغيرة في صور الأقمار الصناعية أمراً بالغ الأهمية للعديد من التطبيقات في مجالات مثل المراقبة البيئية والزراعة والأمن الوطني.
يمكن استخدام نماذج اكتشاف الأجسام في المراقبة البيئية لتحديد التغيرات في البيئة، مثل إزالة الغابات أو التلوث. ويمكن للصور واسعة النطاق أن توفر رؤية شاملة للبيئة، مما يجعلها مصدر بيانات ممتازاً لنظام اكتشاف متطور.
التصوير الطبي والفحص المجهري
في التصوير الطبي، يُعد الكشف عن الأجسام الصغيرة أمرًا ضروريًا للتعرف على أمراض مثل السرطان وتشخيصها. على سبيل المثال، يمكن أن يكون الكشف عن الأورام أو الآفات الدقيقة في صور الرنين المغناطيسي (MRI) أو التصوير المقطعي المحوسب (CT) أمرًا بالغ الأهمية للتشخيص والعلاج المبكر. وفي المجهرية، يُستخدم الكشف عن الأجسام الصغيرة للكشف عن بنية وسلوك الكائنات المجهرية والخلايا وتحليلها. ويمكن أن يشمل ذلك الكشف عن بروتينات محددة أو تراكيب خلوية أو مسببات الأمراض.
اكتشاف الأجسام في الصور البانورامية الكبيرة: الخاتمة
يُعد بناء نماذج الرؤية الحاسوبية لكشف الأجسام لصور البانوراما للمدن باستخدام إطار عمل SAHI مجالاً بحثياً مثيراً مع العديد من التطبيقات المحتملة. يتيح إطار عمل SAHI كشف الأجسام بدقة وكفاءة في الصور، مما يجعله الخيار الأمثل لتطوير نماذج الرؤية الحاسوبية لصور البانوراما. مع تزايد توافر الصور البانورامية من منصات مثل Google Maps، فإن التطبيقات المحتملة لنماذج كشف الأجسام لصور البانوراما للمدن لا حصر لها.
إذا كنت ترغب في استخدام أحدث نماذج اكتشاف الكائنات في منتجك، قم بزيارة صفحة عروضنا للذكاء الاصطناعي وتعلم الآلة وتواصل معنا للحصول على مزيد من المعلومات.
موارد إضافية: إطار عمل SAHI
يتضمن اكتشاف الأجسام في الصور البانورامية الكبيرة تحديد الأجسام وتحديد مواقعها داخل صور فوتوغرافية عالية الدقة للغاية ذات مجال رؤية واسع. ونظرًا لأن هذه الصور أكبر بكثير من الصور القياسية، فإنها تتطلب تقنيات معالجة خاصة لتحليلها بفعالية.
تتمثل التحديات الرئيسية في حجمها الهائل، الذي يتطلب قدرة حوسبة كبيرة، وصعوبة الحفاظ على الدقة عند اكتشاف الأجسام الصغيرة ضمن مشاهد كبيرة ومفصلة.
تتضمن تقنية تجزئة الصور (Image tiling) تقسيم البانوراما الكبيرة إلى أقسام أصغر وأكثر قابلية للإدارة. وتُعالَج كل قسم على حدة لاكتشاف الأجسام، مما يسهّل التعامل مع الدقات العالية ويحسّن أداء الاكتشاف.
تشمل الأدوات الشائعة أطر التعلم العميق مثل TensorFlow وPyTorch، بالإضافة إلى نماذج اكتشاف الأجسام مثل YOLO وFaster R-CNN. وغالباً ما يتم دمجها مع خطوط معالجة مسبقة مخصصة للتعامل مع الصور الكبيرة.
يمكن لقطاعات مثل المراقبة الأمنية، ومراقبة حركة المرور، والبحوث البيئية، والتفتيش الصناعي أن تستفيد جميعها استفادة كبيرة من الصور البانورامية، التي تتيح مراقبة مناطق واسعة وتحليل الأجسام بتفصيل دقيق.

استفد من الذكاء الاصطناعي لتحقيق ميزة تنافسية. تواصل مع خبيرنا لمناقشة احتياجاتك.
Tomasz Smolarczyk
مدير الذكاء الاصطناعي
arrow_circle_right مدونتنا


