Atténuer les risques liés à l'IA grâce aux meilleures pratiques de test des LLM


Imagine launching a groundbreaking AI tool, only to have it propose biased decisions, fabricate legal citations, or misdiagnose a health condition. These aren’t hypothetical scenarios – they’re real-world failures that erode trust and create serious risks. Notable examples include models like Gemini and ChatGPT providing inaccurate information about science and history, Air Canada’s customer service AI chatbot offering non-existent promotions and refunds to the clients, and AI-powered health assistants generating misleading medical advice or recommending unsafe treatments. Hallucinations can have various causes, but usually, we can detect them through LLM testing and take corrective action when needed.
Adopter les dernières modèles IA, switching to another one, or expanding system capabilities is appealing. The pace of updates and the variety of adaptations has accelerated, with multiple major model releases and an increasing number of new use cases in short timeframes. These imply changes in our productivity, enhance our capabilities, and help us focus on what matters, but also introduce risk for the end-user.
Balancing innovation with reliability requires testing protocols. As AI technology advances, so do the strategies and frameworks for ensuring dependable performance. In this blog post, we’ll first explore the key risks of unreliable AI and then discuss LLM testing protocols to mitigate these challenges.
Principaux risques à traiter dans les tests de LLM
Les modèles d'IA apportent des capacités puissantes mais aussi des défis. Voici quelques-uns des risques les plus pressants que les organisations doivent prendre en compte lors du déploiement et de la maintenance grands modèles de langage (LLM).
Résultats incohérents ou mal alignés
One of the biggest challenges in testing large language models is ensuring consistency and alignment with expected behaviour. LLMs can produce responses that vary significantly for similar inputs, leading to reliability issues in applications requiring precise or repeatable answers. Additionally, models may generate outputs that deviate from brand guidelines, ethical considerations, or regulatory requirements.
Baisse de performance dans les tâches clés
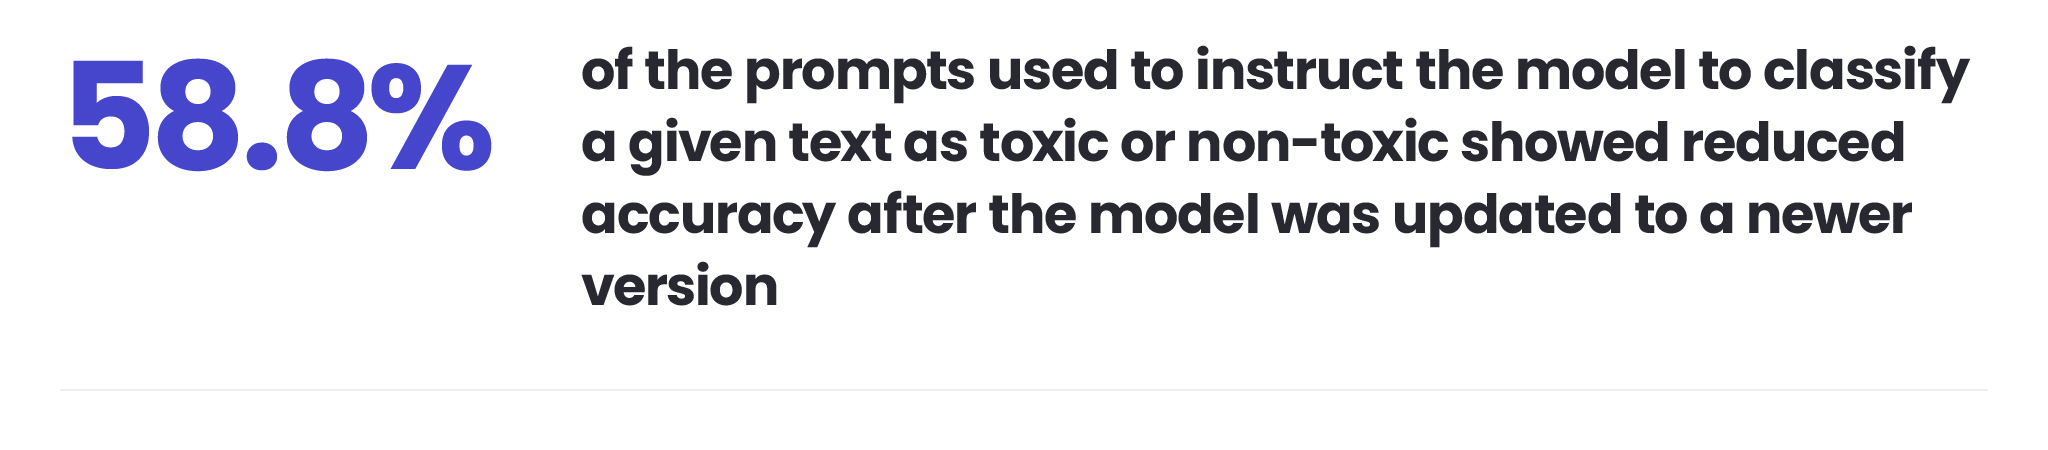
When upgrading your model to a newer version, you need to take particular care, as it doesn’t always lead to universal improvement. A 2024 study found that model updates can degrade performance in specific tasks, impacting critical applications like content moderation and customer feedback analysis.
Insight: A 2024 study on Regression Testing for Evolving LLM APIs showed that 58.8% of prompts used to instruct the model to classify given text as toxic or non-toxic exhibited decreased accuracy after the model was updated to a newer, more advanced version.
Dérive des données
Les modèles d'IA dépendent des données utilisées pour les entraîner. Avec le temps, les changements de langage, les tendances émergentes ou l'évolution du comportement des clients peuvent rendre les modèles moins précis. Ce phénomène, connu sous le nom de « dérive des données », peut conduire à des prédictions obsolètes ou non pertinentes.
Menaces de sécurité spécifiques à l'IA
AI systems face unique security risks, including prompt injections (tricking AI into generating unintended or harmful outputs), data poisoning (feeding malicious data to corrupt results), and data leakage (unintentionally exposing sensitive information). Tools like Lakera Guard help secure large language models in real time.
Aperçu : curieux d'en savoir plus sur les attaques par prompt ? Essayez Gandalf par Lakera – un jeu où vous testez vos compétences pour amener le modèle à révéler des informations secrètes.
Latence et réponses lentes
Large AI models can be computationally intensive, leading to slower response times. For real-time applications – such as financial trading algorithms or live customer support – these delays can have significant repercussions, including missed opportunities, disrupted workflows, and frustrated users. In high-stakes environments, even slight lags can lead to financial losses, security risks, or decreased trust in AI-driven decisions.
Coûts croissants
Sophisticated AI models typically require increased computational resources. Cloud processing fees, storage demands, and energy consumption can accumulate, complicating scalability. Achieving a balance between performance and cost is needed for sustainable AI integration.
Risques de conformité réglementaire
With regulations like the EU AI Act and GDPR taking effect, AI compliance is critical. Organisations must ensure their artificial intelligence systems do not violate legal standards, such as data privacy laws or restrictions on high-risk AI applications.
Découvrez l'impact de l'EU AI Act sur l'industrie chimique
En savoir plus
Protocoles de test pour l'IA et les LLM
Comprendre les risques liés à l'IA n'est que la première étape de l'élaboration de stratégies de test proactives. Pour garantir que les LLM et les modèles d'IA fournissent des résultats cohérents et de haute qualité, nous avons besoin de méthodes de validation structurées.
Mesurer la qualité des réponses du modèle
A straightforward approach to validating AI reliability is to build a dataset containing a collection of prompts paired with expected response guidelines. Such a solution acts as a benchmark to test whether the model behaves as intended across key scenarios.
Pendant les tests, les sorties du modèle sont comparées aux réponses attendues pour évaluer des aspects tels que :
- Cohérence – L'IA produit-elle des réponses stables pour une même entrée ?
- Exactitude – Les résultats sont-ils factuellement exacts et conformes aux directives ?
- Robustesse – Le modèle peut-il gérer les variations de formulation sans contradictions ?
- Format – La réponse suit-elle la structure requise (par ex. JSON, tableaux) ?
- Conformité – L'IA respecte-t-elle les normes éthiques, juridiques et politiques ?
Si des divergences apparaissent, nous pouvons y remédier par un affinage, des ajustements de prompt ou des mécanismes de repli.
Étude de cas : Extraction de données avec de grands modèles de langage
For several of our clients from the ecommerce and logistics sectors, we created an automated data extraction solution. The enhanced process of separating and verifying business data from PDF files and operational documents has helped them eliminate slow, manual data entry and email forwarding. Using the GPT4o model, structured data was extracted and validated through automated routines, generating accurate JSON outputs ready for further processing in seconds, rather than minutes, per document.
- workflows LlamaIndex a facilité des améliorations itératives, en affinant la qualité d'extraction dans les cas complexes où l'exécution initiale échouait à la validation.
- MLflow, largement utilisé pour gérer le cycle de vie de l'apprentissage automatique, a été intégré pour suivre les expériences et surveiller les performances.
Grâce à ces projets, nos solutions ont considérablement réduit les temps de traitement, amélioré la précision et minimisé les interventions manuelles, permettant une prise de décision plus rapide et des opérations rationalisées.
Découvrez comment l'extraction de données par IA aide notre client du secteur de l'assurance
Voir l'étude de cas
Modèle agissant comme un juge
When tasks require subjective judgment – such as evaluating conversational AI, summarising complex texts, or translating nuanced content – the LLM-as-a-judge framework can be highly effective. This approach leverages the AI’s capabilities to critique and score its outputs.
Carefully designed evaluation prompts enable performance assessment. Specially designed instructions allow us to assess how well a model performs under certain conditions. This method is particularly valuable when we need a human-like judgment, but full automation remains the goal.
Étude de cas : Validation de traduction pour l'industrie chimique
As part of our project for a leading company in the chemical industry, we validated AI-generated translations of its website content, which included product information and marketing materials. Our goal was to ensure factual accuracy and compliance, as errors in toxicity warnings, numerical values, and health-related terms could mislead customers and harm brand credibility.
Un LLM concurrent, développé par un autre fournisseur d'IA, a validé les résultats originaux en matière de détection de toxicité, de risques pour la santé et la sécurité, et d'exactitude factuelle – en se concentrant sur les entités nommées, les nombres, les dates et les unités. Des outils comme Promptfoo permettre la comparaison de modèles et de prompts, en identifiant les configurations les plus efficaces pour garantir la cohérence et la précision dans les domaines sensibles.
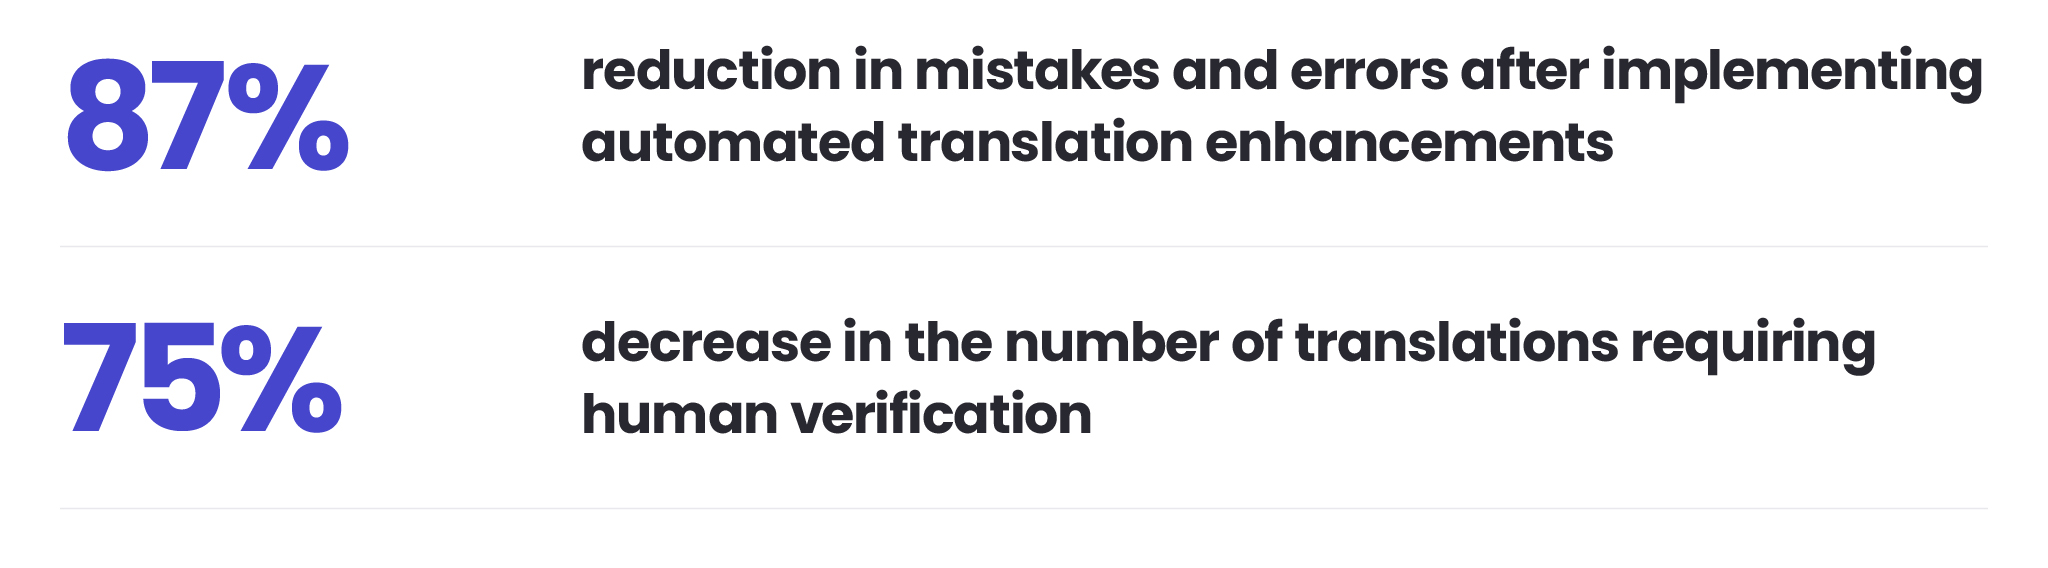
Results for Polish as the pilot language with translations across more than 200 websites show an 87% decrease in error rates after automated translation improvements. The project also brought a 75% reduction in translations requiring human review, significantly improving content reliability, reducing costs, and minimising manual effort.
Commencez par des revues manuelles, progressez vers des tests automatisés
Dans certains cas, des évaluations manuelles initiales sont nécessaires pour établir des références de qualité. En analysant les schémas dans les résultats de haute et de faible qualité, nous pouvons obtenir des informations qui aident à concevoir des flux de travail de tests automatisés.
Les entrées collectées peuvent être réutilisées pour prévenir toute régression des performances. Le retraitement des données historiques avec des modèles mis à jour, dans un processus connu sous le nom de backtesting, garantit cohérence et fiabilité dans le temps.
Étude de cas : garantir la cohérence des traductions grâce aux tests et à la validation des LLM
During our project assessing AI-generated translations, it became clear that inconsistencies in proprietary terms, marketing slogans, and industry-specific phrases were a significant challenge. Wanting to translate content into 28 languages from various language groups, such as Germanic, Romanic, Slavic, Asian, Middle Eastern, and Finno-Ugric, the client needed a new approach to address the issue.
Experts created a glossary of approved translations, ensuring that key terms remained uniform across all languages, with some left in English to preserve brand identity. The glossary was then integrated into the validation process, helping automated translations maintain accuracy and consistency across international markets.
Personnaliser votre suite de tests pour LLM
Industry experts use the approaches outlined above widely. However, it is important to remember that AI systems vary in complexity, capabilities, and limitations. That’s why, to ensure effective LLM testing, you may need strategies tailored to specific functions and behaviours.
For example, retrieval-augmented generation (RAG) models require validation of how well they integrate external data, while models with different memory mechanisms demand specialised consistency checks. Similarly, agent-based AI workflows, designed to operate autonomously, need testing frameworks that assess decision-making and adaptability.
En alignant les stratégies de test sur les caractéristiques uniques de chaque modèle, les organisations peuvent garantir des systèmes d'IA plus fiables, conscients du contexte et performants.
Suivi des performances et des coûts de l'IA
Garantir la fiabilité de l'IA à long terme nécessite un suivi continu des performances et de l'utilisation des ressources. La surveillance continue aide à détecter les anomalies, à optimiser l'efficacité et à prévenir les régressions dans les environnements de production.
L'optimisation des ressources informatiques, la gestion de la consommation de jetons et le perfectionnement de l'utilisation des modèles contribuent à équilibrer performance et efficacité. Des audits et des ajustements réguliers garantissent des opérations d'IA durables sans coûts inutiles.
Outils de surveillance automatisés, tels queTableau de bord API d'OpenAI, AWS CloudWatch, et Azure Monitor, suivez les indicateurs de performance clés et identifiez les écarts. Cette approche proactive aide à maintenir la cohérence et la réactivité du modèle.
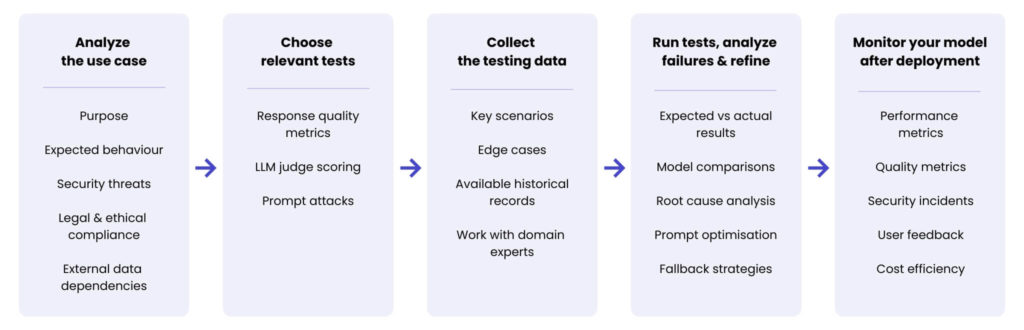
pipeline de test des LLM
The LLM Testing Pipeline diagram presented below puts all the key concepts discussed in this article in order. By following this structured approach – from analysing the use case to monitoring performance – teams can systematically assess model quality, refine outputs, and maintain long-term reliability.
Tirez parti des protocoles de test des LLM avec un partenaire technologique éprouvé
Sans évaluation structurée, les mises à jour de modèles peuvent introduire des incohérences, dégrader la précision ou augmenter les coûts opérationnels, sapant ainsi la confiance et l'efficacité.
Heureusement, les tests d'IA ont évolué parallèlement à la technologie elle-même. Des techniques de validation structurées à la surveillance automatisée, les entreprises peuvent désormais accéder à des méthodologies qui atténuent les risques sans étouffer l'innovation.
As the adoption of large language models accelerates, the demand for specialised AI and LLM testing expertise will only grow. Organisations that invest in strong validation frameworks today will have the best chance to harness AI’s full potential – while maintaining control over performance, security, and costs.
Ainsi, si vous souhaitez maintenir votre organisation à la pointe de l'innovation en tirant parti de solutions d'IA éprouvées et rigoureusement testées, et en les développant, contactez-nous via le formulaire ci-dessous.
FAQ
Common concerns are hallucinations, inconsistent responses, and misleading outputs that lead to reliability issues. Performance drops can also pose risks, as upgrading a model doesn’t always guarantee better results. Data drift is also challenging, with AI data becoming outdated as languages, trends, and user behaviour evolve. AI-specific security threats, such as prompt injections, data poisoning, and leakage, can compromise models, while latency issues may slow real-time processing. Additionally, maintaining AI infrastructure can be costly due to high computational demands, and involves aligning with regulatory standards.
LLM testing helps identify weaknesses and ensures consistent performance by evaluating response accuracy and stability, detecting model regressions after updates, and monitoring for security vulnerabilities. It can also play a significant role in ensuring regulatory and ethical compliance.
Implementing LLM testing effectively requires a structured approach. The process should include manual reviews to set quality benchmarks and automated testing to improve performance and efficiency. Measuring model response quality involves comparing outputs against expected answers to assess accuracy. Using LLM as a judge helps leverage the AI’s capabilities to critique and evaluate its outputs, while backtesting helps ensure model consistency over time, even after new model updates.
To balance AI performance with cost efficiency, businesses should optimise computational resources, and manage token and model usage to prevent waste. Cost-effective cloud solutions can help manage expenses, while implementing performance monitoring tools like OpenAI’s API Dashboard, AWS CloudWatch, and Azure Monitor ensures efficient use of resources without sacrificing reliability.
Without structured evaluation, AI systems can introduce inconsistencies, degrade accuracy, and increase costs. Robust LLM testing frameworks ensure that models remain reliable, compliant, and efficient, helping businesses unlock AI’s full potential while mitigating risks associated with unpredictable performance.

arrow_circle_rightContactez-nous
Discutons de la manière dont nous pouvons soutenir vos projets d'IA
Tomasz Smolarczyk
Directrice de l'Intelligence Artificielle
arrow_circle_right Autres articles