«هل يمكنك تحسين ذلك؟» – الجزء 1: مقدمة إلى الدقة الفائقة


ما هي الدقة الفائقة؟
التصوير فائق الدقة (SR) هو فئة من التقنيات التي تعزز (تزيد) دقة الصورة من دقة منخفضة (LR) إلى دقة عالية (HR). وفي الآونة الأخيرة، حققت تقنيات التعلم العميق (DL) نجاحاً كبيراً في حل مشكلة الدقة الفائقة للصور والفيديو.
في هذه المقالة، ستجد سيناريوهات استخدام SR، والنظرية الكامنة وراءها، والتقنيات المختلفة المستخدمة، والمقاييس، وأمثلة على التصور "قبل" و"بعد".
سيناريوهات الاستخدام
المراقبة
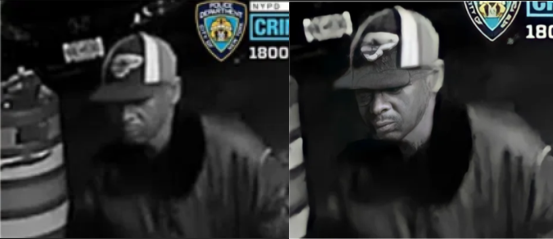
المصدر: https://www1.nyc.gov/site/nypd/services/see-say-something/crimestoppers.page
يمكن استخدام SR للكشف عن الصور منخفضة الدقة التي يتم الحصول عليها من كاميرات المراقبة وتحديدها وإجراء التعرف على الوجوه عليها. يعد تطبيق تقنيات SR لتحسين لقطات المراقبة أقرب شيء لما يمكن أن نراه في المسلسل التلفزيوني CSI.
الصور الطبية
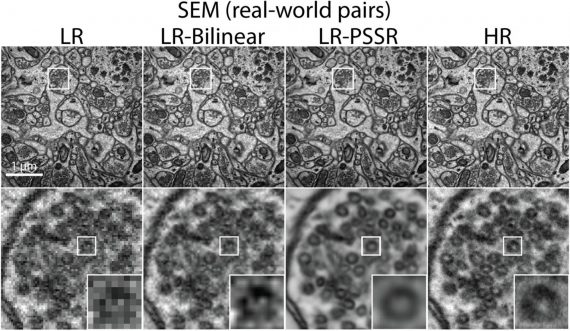
Cقد يكون التقاط صور الرنين المغناطيسي (MRI) عالية الدقة أمرًا صعبًا عندما يتعلق الأمر بوقت المسح والتغطية المكانية ونسبة الإشارة إلى الضوضاء (SNR). وتساعد تقنية الدقة الفائقة على حل هذه المشكلة من خلال توليد صور رنين مغناطيسي عالية الدقة من صور رنين مغناطيسي منخفضة الدقة.
صور الأقمار الصناعية
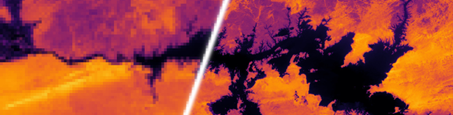
الحالة الأخرى التي قد ترغب فيها في تطبيق تقنية الاستشعار عن بعد (SR) على صورك أولاً هي عندما يكون جمع بيانات الدقة العالية (HR) مكلفاً. وينطبق هذا بشكل خاص على صور الأقمار الصناعية، حيث يمكن أن تبلغ تكلفة كيلومتر مربع واحد من الصور بدقة 30 سم أكثر من 25 دولاراً. أما تكلفة الصور بدقة 1 متر فتبلغ حوالي 10 دولارات لكل كيلومتر مربع. وهذا يعني أنه مقابل مجموعة تبلغ 1000 كيلومتر مربع، تدفع 10,000 دولار وليس 25,000 دولار – أي تحقيق وفورات ضخمة في التكاليف لشركتك.
الإعلام
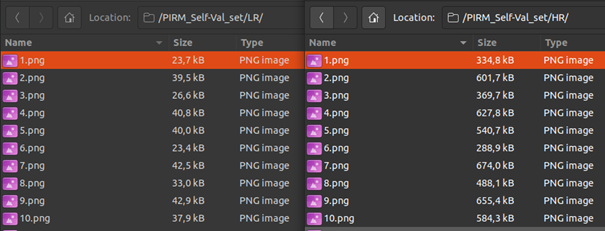
يمكن استخدام الدقة الفائقة لتقليل تكاليف الخادم، إذ يمكن إرسال الوسائط بدقة أقل ورفع دقتها أثناء التشغيل. ويوضح الشكل أعلاه الفرق بين صور PIRM ذاتية التحقق منخفضة الدقة (LR) وعالية الدقة (HR) (https://pirm.github.io/). على اليسار، لدينا صور مصغّرة بمقدار 4x، وعلى اليمين، صور HR الأصلية.
الدقة الفائقة في العالم الحقيقي
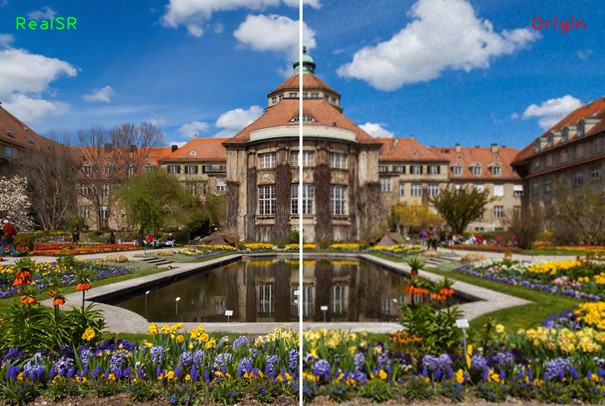
يمكن استخدام SR لتقليل التشوهات والضوضاء من الصور الواقعية. بشكل أساسي، يمكنك تحسين جميع صور السيلفي وصور العطلات قبل تحميلها إلى Facebook أو Instagram.
تحسين الألعاب – DLSS
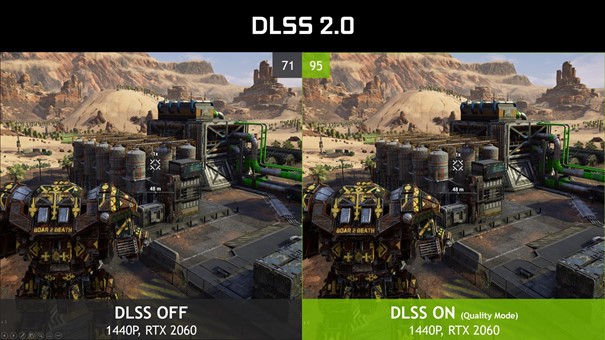
DLSS (اختصار لـ Deep Learning Super Sampling) هي شبكة عصبية للتعلم العميق تستخدم قوة وحدات Tensor Cores من NVIDIA RTX لتعزيز معدلات الإطارات وتوليد إطارات حادة تقترب من العرض الأصلي أو تتجاوزه. من خلال الاستفادة من شبكة عصبية للتعلم العميق، تستطيع DLSS الجمع بين منع التعرجات وتحسين الميزات وتحسين حدة الصورة وتحجيم العرض، وهو ما لا تستطيع حلول منع التعرجات التقليدية تحقيقه. بهذا النهج، تقدم DLSS أداءً أعلى يصل إلى ضعف الأداء مع جودة صورة مماثلة للعرض الأصلي بالدقة الكاملة. وهي تمنحك هامش الأداء اللازم لتعظيم إعدادات تتبع الأشعة وزيادة دقة الإخراج. تعمل DLSS بمعالجات AI مخصصة على وحدات RTX GPU تُسمى Tensor Cores.
بالاقتران مع تقنيات DL الأخرى
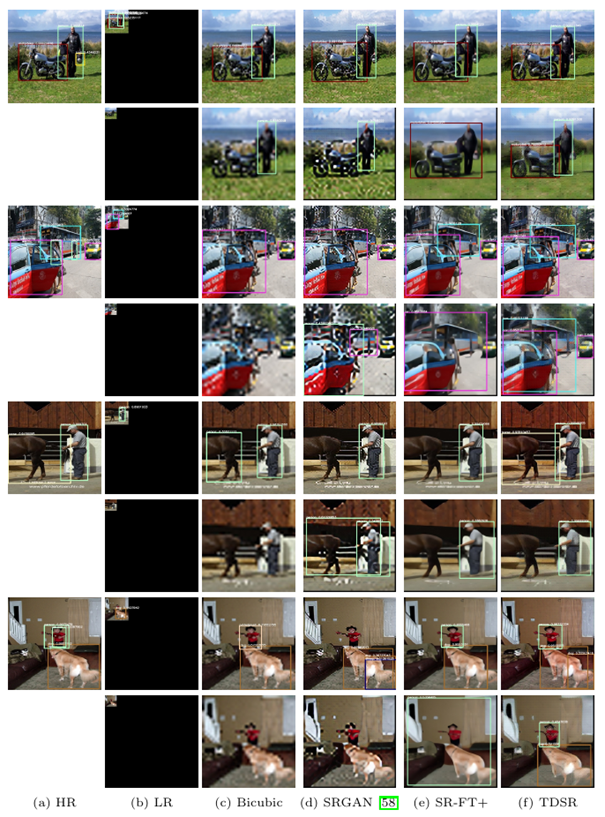
تخيّل أن لديك مجموعة من البيانات وتريد القيام ببعض كشف الأجسام مع ذلك، فإن البيانات ذات جودة منخفضة حقاً، ربما من كاميرات فيديو قديمة أو رخيصة. وعندما تحاول تطبيق نماذج التعلم العميق (DL) العادية الخاصة بك، فإنها لا تؤدي أداءً جيداً… يمكنك تعزيز أدائها من خلال تمرير صورك أولاً عبر شبكة SR.
في المقال التالي من هذه السلسلة، سأخبرك المزيد عن طرق إعادة تشكيل الصور الرقمية وكيفية قياس أدائها.


arrow_circle_rightاتصل بنا
عزّز أداء نماذج التعلّم العميق لديك باستخدام التصوير فائق الدقة. تواصل مع خبيرنا لمعرفة المزيد
Tomasz Smolarczyk
مدير الذكاء الاصطناعي
arrow_circle_right مقالات أخرى



