أتمتة وسم البيانات باستخدام التعلم بالنقل
لدعم تحليل القيادة الذاتية، بنينا نماذج رؤية حاسوبية تُؤتمت وسم تسجيلات الطرق. ويكتشف الحل إشارات المرور ويصنّفها، مما يقلّص العمل اليدوي من أيام إلى دقائق ويمكّن الفرق من معالجة قدر أكبر بكثير من البيانات.

الخدمات
الاحتياج التجاري
كان أحد عملائنا يبني أداة تحليل متعلقة بالقيادة الذاتية. مع اقتراب مشروع جديد، واجهوا مهمة تحليل محتوى تسجيلات الطرق. تطلبت هذه المهمة العمل اليدوي للعديد من الأشخاص الذين حللوا المسار وحددوا العديد من الكائنات المختلفة المرئية عليه.
تعد هذه المشكلة شائعة جدًا في الوقت الحاضر. يتيح تطوير أساليب الرؤية الحاسوبية حل مشكلات تجارية متعددة في آنٍ واحد. ومع ذلك، ومن أجل تدريب النماذج المناسبة، يجب أن تتوفر لدينا بيانات مُصنّفة بشكل صحيح. عادةً، نحتاج إلى كميات كبيرة من البيانات لتدريب نموذج التعلم العميق، وهو ما يرتبط بعبء عمل كبير على المصنّفين اليدويين.
كانت مهمة فريقنا إنشاء نماذج تعلم آلي تتيح أتمتة جزئية لعملية وضع العلامات. قررنا البدء بوضع علامات على إشارات الطرق.
الرؤية الحاسوبية
بينما يمكننا بسهولة استيعاب قدرة الآلات على تحليل كمية كبيرة من البيانات المنظمة مثل الجداول من تقييم الائتمان، فإن قدرة الآلة على التعرف على صورة أو مقطع فيديو وفهمه هي أمر أكثر بديهية وإثارة للإعجاب.
مع التطورات الحديثة في القدرة الحاسوبية، وأساليب التعلم الآلي الأحدث والأفضل، أصبحنا بالفعل في منطقة غالبًا ما ترتبط بالكتب والأفلام الخيالية العلمية. السيارات ذاتية القيادة، والتعرف على الوجه المتاح في جهاز نحمل جميعًا في جيوبنا، وآلات تقرر ما إذا كان هناك بقعة مرئية في الأشعة السينية لرئتينا، أو ما إذا كانت حالة الجلد التي التقطنا صورة لها للتو قد تكون خطيرة. كل هذه تطبيقات مدروسة جيدًا وعاملة لرؤية الحاسوب.
يمكن تقسيم معظمها إلى فئتين رئيسيتين:
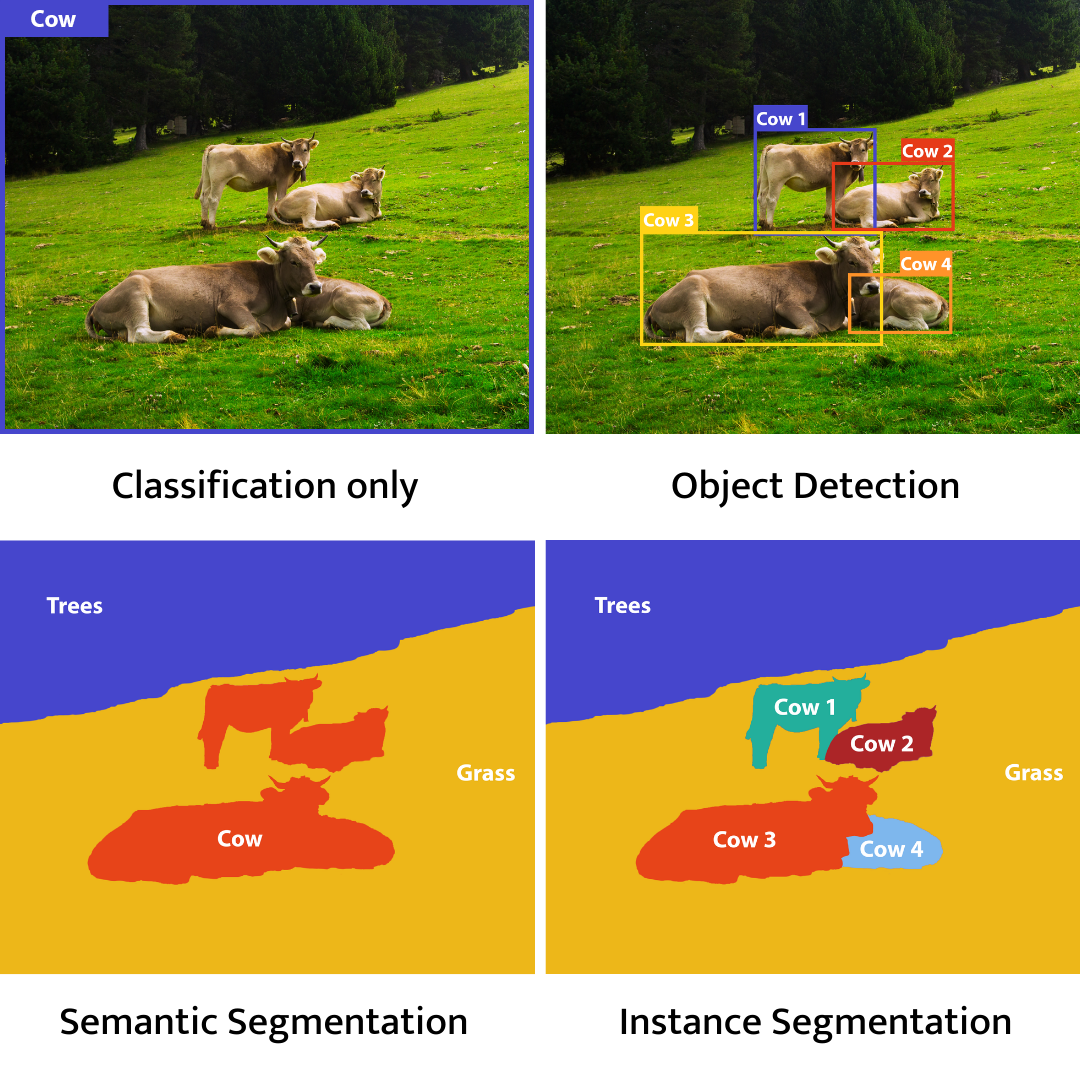
تصنيف الصور– تتمثل مهمة خوارزميات التعلم العميق في تصنيف صورة أو مقطع فيديو إلى فئة واحدة (أو عدة فئات). ومن خلال هذا النوع من النماذج، يمكننا مثلاً تحديد ما إذا كانت الآفة الجلدية خبيثة أم لا (في هذه الحالة، تُصنَّف الصورة ضمن إحدى فئتين – خبيثة أو غير خبيثة).
كشف الكائنات– تُستخدم للكشف عن الأجسام المرئية في الصورة. باستخدام هذه التقنية يمكننا، على سبيل المثال، الكشف عن البشر في التسجيل المرئي أو عد خلايا الدم في صور المجهر.
التقسيم– يركّز على تقسيم الصورة إلى مقاطع. يُصنَّف كل بكسل ويُجمَّع وفقاً لذلك. نستخدم هذه الأساليب في الغالب لتحديد الحدود في الصور.
- التجزئة الدلالية– نُسنِد فئة لكل بكسل، ولا نتعرّف على حالات منفصلة للأجسام. على سبيل المثال، إذا رأينا عدة مبانٍ، فسيتم تصنيفها جميعًا على أنها "مبنى" ولن تتوفر معلومات عن أي مبنى تحديدًا.
- تجزئة الحالات– على عكس التقسيم الدلالي، فإننا نأخذ في الاعتبار حالات الكائنات. كما نقوم بتصنيف كل بكسل ولكن في هذه الحالة نأخذ في الاعتبار أيضاً الكائنات المنفصلة. في هذا المثال، سنقوم بترقيم المباني الظاهرة في الصورة كمبنى رقم 1، ومبنى رقم 2، وهكذا.
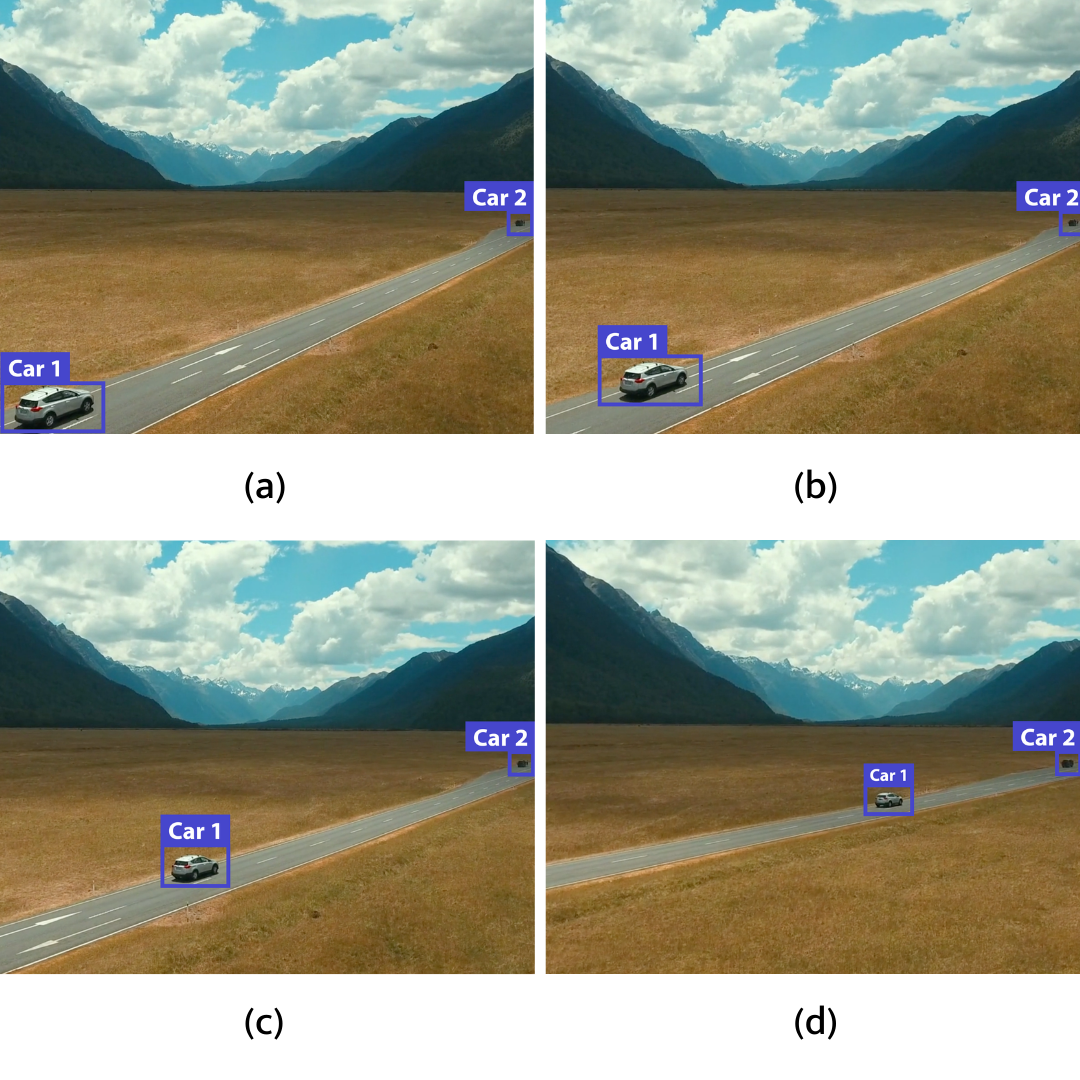
تتبع الأجسام– باستخدام كل من الكشف والتصنيف، يمكننا أيضًا تتبّع جسم معيّن. فإذا رأينا في الفيديو سيارة تسير في الشارع، يمكننا تتبّع حركتها مع معرفة أن هذه هي السيارة نفسها، وليست حالة أخرى لجسم جديد.
وصف الحل
درسنا أساليب متعددة خلال المرحلة التجريبية من المشروع.
في النهاية، قررنا إنشاء نموذجين متخصصين منفصلين والاستفادة من مبدأ نقل التعلم.
في حالة مهام الرؤية الحاسوبية، عادةً ما يعني التعلم بالنقل استخدام شبكات عصبية مدرَّبة مسبقًا كأساس. تم تدريب الشبكة الأساسية على مجموعات بيانات ضخمة وتمكنت من تعلم التعرف على الأشكال والأنماط العامة. وباستخدام مثل هذه الشبكة، يمكننا بعد ذلك إعادة تدريبها بشكل إضافي لتلبية احتياجاتنا المحددة.
دعونا نعرض هذه الفكرة بطريقة أكثر توضيحًا من خلال حالة الاستخدام المحددة لدينا. تم تدريب الشبكة العصبية المستخدمة كعمود فقري مسبقًا على عدد كبير من الصور وتعليمها التعرف على الأشياء الأساسية اليومية، مثل السيارات والأشجار والفواكه. نستخدم جزءًا من هذه الشبكة لحل مشكلتنا.
قد يكون ذلك الجزء قادرًا على التعرف على الأشكال والألوان وأنماط أخرى متنوعة بشكل جيد للغاية. ومن خلال استخدام عدد أقل من الصور لعلامات الطريق المحددة، نتمكن في النهاية من تدريب مثل هذه الشبكة بشكل إضافي للتعرف على علامات الطريق. لقد تجاوزنا عملية التعلم جزئيًا، والتي تكتسب خلالها الشبكة معرفة بالسمات الأساسية للصورة. وبفضل ذلك، لا نحتاج إلى هذه الكمية الكبيرة من بيانات التدريب.
في حلنا، يركز النموذج الأول على اكتشاف الكائنات – إيجاد جميع لافتات الطرق المرئية في الإطارات المأخوذة من التسجيل.
بعد التعرف عليها، يتم لاحقاً تصدير صور اللافتات وحفظها. ثم تُنقل هذه الصور إلى النموذج الثاني بمهمة واحدة تتمثل في تصنيف اللافتة، أي إعطائها معنى وسياقاً مناسبين.
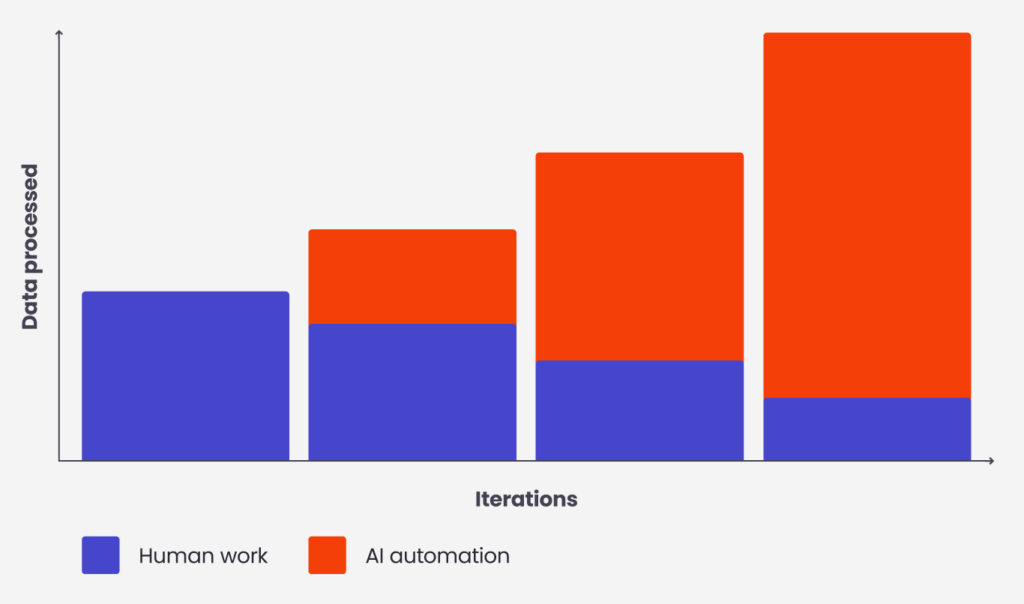
عند دمجهما في مسار معالجة واحد، سيتمكن كلا النموذجين من التعرف على لافتات الطرق وتصنيفها في التسجيل بأكمله في غضون ثوانٍ. وبفضل ذلك، يمكن نقل العمل الذي يقوم به المصنّفون إلى تحليل تنبؤات النموذج والتصحيحات المحتملة. وبهذه الطريقة، يمكننا تحليل عدد أكبر بكثير من التسجيلات في الوقت نفسه. وتتمثل ميزة إضافية في تسليم أسرع لنقاط البيانات الجديدة (الصور المصنّفة)، والتي يمكن بعد ذلك استخدامها لإعادة تدريب النماذج وتحسين فعاليتها.
نتائج التعاون
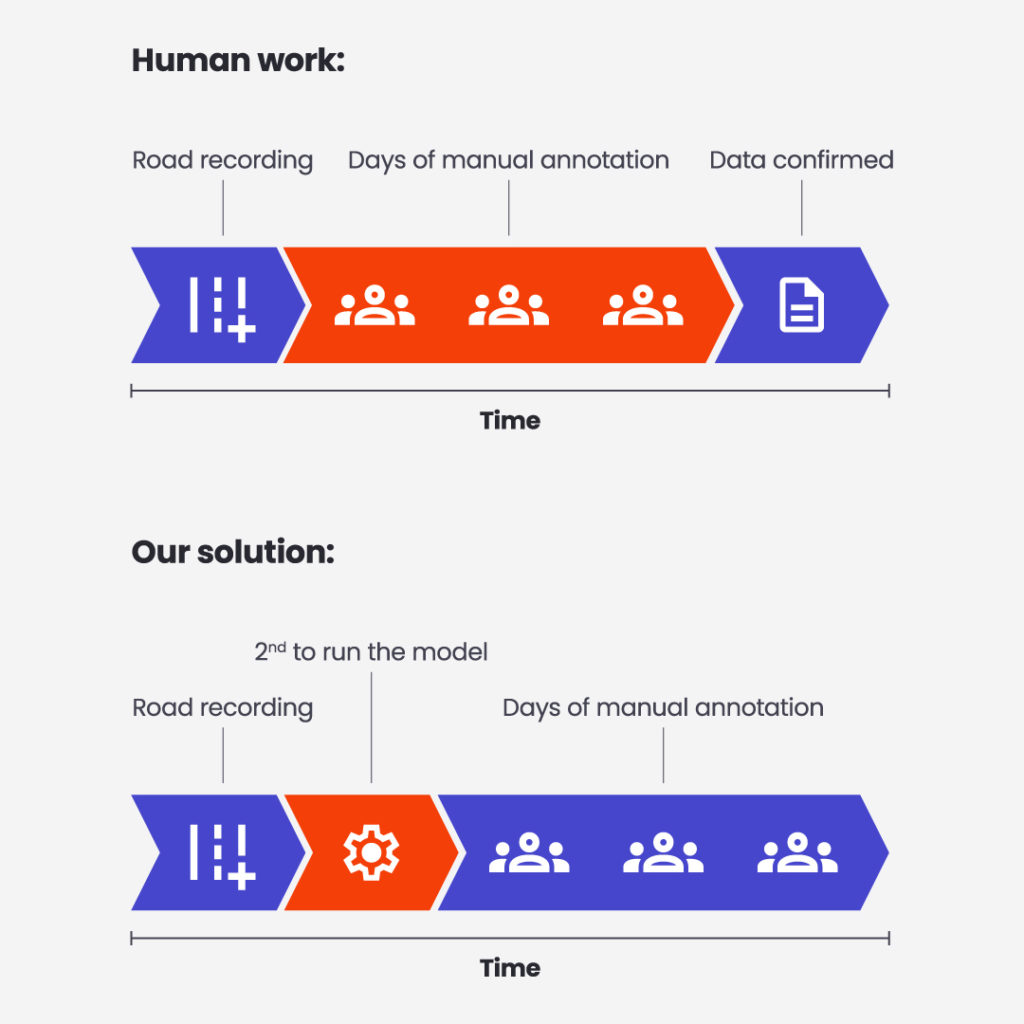
في البداية، استخدم عميلنا تسجيلات فيديو لطريق ومحيطه لوضع علامات يدوية على إشارات المرور المرئية من منظور المركبة. تطلب وضع العلامات اليدوي أيامًا من العمل الدؤوب لـ 4 موظفين. فقط بعد الانتهاء من وضع العلامات، كان بإمكانهم التحقق المتقاطع من علاماتهم وتأكيد العلامات النهائية.
بفضل حلنا، بدلاً من أيام من العمل، نقوم بوسم التسجيل في غضون دقائق، ولا يلزم سوى شخص واحد للتحقق من نتائج النموذج. وهذا يتيح لنا إعادة توجيه القوى العاملة نحو تأكيد التنبؤات، مما يعني أننا قادرون على معالجة عدد أكبر من التسجيلات في الوقت نفسه.
يمكن استخدام حلول مماثلة في العديد من المهام المتعلقة بالتعرف على الأنماط أو الكائنات المحددة في الصور أو تصنيفها.
إذا صادفنا في صناعة معينة صورًا يمكن أن تزودنا بمعلومات – يمكننا إيجاد تطبيق لخوارزميات ذكاء اصطناعي مماثلة.
بالإضافة إلى ذلك، يتم دعم هذه المهام بشكل متزايد بحلول سحابية. يمكن لممارس البيانات ذي المهارات المناسبة إنشاء النماذج اللازمة وتنفيذإثبات المفهوم.
arrow_circle_right دراسات الحالة
اقرأ قصص نجاح عملائنا


arrow_circle_rightتواصل معنا
لنخطط لكيفية استفادة أعمالك من الذكاء الاصطناعي
Tomasz Smolarczyk
مدير الذكاء الاصطناعي