בוטים קוליים מבוססי AI במגזר הבנקאי הפולני (חלק 1)


בנוף המתפתח במהירות של בנקאות דיגיטלית, לא ניתן להפריז בחשיבותם של שירותי דיבור ציבורי יעילים. שירותים אלה ממלאים תפקיד מכריע בשיפור חוויית הלקוח, במיוחד בהקשר של המגזר הבנקאי הפולני, שבו אינטראקציה ותקשורת עם הלקוח הן בעלות חשיבות עליונה. עם ההתקדמות בבינה מלאכותית ובעיבוד שפה טבעית, היכולות של שירותי דיבור ציבורי עברו טרנספורמציה יוצאת דופן, ומציעות דרכים אינטואיטיביות ויעילות יותר לתקשר עם לקוחות.
שוק ה-voicebot במגזר הפיננסי הפולני גדל באופן דינמי. הלקוחות כבר רגילים לשוחח עם עוזרים וירטואליים ולשאול אותם שאלות נפוצות, למשל, לגבי מצב החשבון. לדוגמה, PKO, אחד הבנקים הפולניים הוותיקים ביותר, משתמש בעוזרים וירטואליים כבר למעלה משלוש שנים. למעשה, על פי הודעה לעיתונות שלהם, יש להם לא פחות מ-18 עוזרים וירטואליים שונים, ונכון לאוגוסט 2023, הבוטים הקוליים שלהם בלבד כבר ביצעו למעלה מ- 25 מיליון שיחות עם למעלה מ-9 מיליון לקוחות. מרשים, נכון?
עם הצמיחה המהירה שלAIכדאי לבחון כיצד ניתן ליישם טכנולוגיות הקשורות ל-AI בבנקים ובמוסדות פיננסיים אחרים. זהו המוקד העיקרי של מחקר ומאמר זה, שהוכנו בשיתוף על ידי Kamil Machalica, מדען נתונים בכיר בתחום ה-AI, ו-Szymon Rożdzyński, מהנדס תוכנה ב-DevOps.
הבה נצא לחקירה מפורטת של שירותי דיבור ציבוריים שונים, תוך התמקדות מיוחדת ביישומם בתעשיית הבנקאות הפולנית. על מנת לשקף מקרוב את צורכי הלקוח שלנו, בדומה לאלה הקיימים בסביבות מרכזי קשר, טכנולוגיות אלה ייבדקו עם משפטים המותאמים לתרחישי בנקאות.
דגימות אלו יוגברו לאחר מכן ברמות רעש שונות, תוך יצירת שכפול אותנטי של סביבת השמע האופיינית לשיחות טלפון עם לקוחות אמיתיים. המתודולוגיה שלנו נועדה להציע הערכה ריאלית של היכולות של כל שירות, המשקפת את האופי המורכב והתובעני של אינטראקציות עם לקוחות במוקדי שירות בנקאיים.
אך לפני שנגיע לכך, ישנם מספר אתגרים אפשריים שיש לדון בהם.
אתגרים עם בוטים קוליים מבוססי AI בבנקאות בפולין
כאשר אנו נכנסים לשלב שילוב שירותי דיבור ציבוריים במגזר הבנקאי הפולני, אנו נתקלים במגוון אתגרים. מכשולים אלו הם קריטיים לפיתוח טכנולוגיות דיבור יעילות ואפקטיביות המותאמות לצרכי הלקוחות הפולנים. להלן נפרט כמה אתגרים מרכזיים:
תמיכה מוגבלת בשפה הפולנית
אתגר מרכזי הוא התמיכה המוגבלת בשפה הפולנית בשירותי דיבור ציבוריים נפוצים. לדוגמה, AWS Lex, שירות מוכר להמרת דיבור לטקסט, אינו תומך בפולנית. הדבר מחייב בחינת פתרונות חלופיים או פיתוח מודלים מותאמים אישית עבור הדקדוק המורכב והניואנסים של ההגייה הפולנית.
משאבי מחקר מוגבלים
בשל המחסור במחקרים ובנצ'מרקים חיצוניים העוסקים ביישומים ייחודיים לבנקאות הפולנית, מרבית המחקר בתחום זה נערך באופן פנימי. משמעות הדבר היא שמוסדות מתחילים לעתים קרובות מאפס, ומשקיעים זמן ומשאבים ניכרים במחקר ראשוני כדי להבין את היכולות והמגבלות של טכנולוגיות דיבור קיימות עבור השפה הפולנית ודרישות הבנקאות. שירותי הענן הציבוריים עוברים שינויים משמעותיים, וכתוצאה מכך המחקר מתיישן לעתים קרובות.
מגבלות זמן ומגבלות נתונים במחקר
אתגר משמעותי נוסף הוא מגבלת הזמן, מאחר שהמחקר אינו המטרה העיקרית של הפרויקט. הפרויקט נאלץ להתמודד עם מגבלה זו, מה שהוביל למערך נתונים שלמרות שאינו נרחב, היה מספק לצרכים המיידיים של הפרויקט. עם זאת, לצורך תובנות מקיפות יותר ודיוק גבוה יותר, המחקר היה מפיק תועלת מדוגמאות קול נוספות וממסמנים נוספים, מעבר לשניים שהיו מעורבים. הדבר היה משפר את הלמידה והביצועים של המערכת, במיוחד בסביבה הפונה ללקוחות.
מדדי השוואה – STT ו-TTS
ההערכה של שירותי דיבור ציבוריים היא דו-פנית: המרת דיבור לטקסט (STT) והמרת טקסט לדיבור (TTS). STT מתמקד בתמלול מדויק של פולנית מדוברת לטקסט, חיוני להבנת שאילתות לקוחות. הערכת TTS עוסקת בהמרת פולנית כתובה למילים מדוברות באופן טבעי ומדויק, חיוני לתגובות לקוחות ברורות ומובנות.
בסעיפים הבאים נבחן כל אתגר בפירוט, נדון בהשפעתו על פריסת שירותי דיבור ציבוריים בבנקאות הפולנית ובאסטרטגיות אפשריות להתמודדות עמם.
המרת דיבור לטקסט
טכנולוגיה הידועה בשםSTT – דיבור לטקסט, הידוע גם כזיהוי דיבור אוטומטי (ASR), ממיר שפה מדוברת לטקסט כתוב. הוא שימושי במיוחד באפליקציות שבהן יש להמיר דיבור לצורה שמחשבים ואלגוריתמים חכמים יכולים לעבד. לדוגמה, עוזרים וירטואליים לתמיכת לקוחות.
ניסוי תוכנן לבחינת יכולות המרת דיבור לטקסט (STT) לצורך הערכת שירותי דיבור ציבוריים בתחום הבנקאות הפולנית. בתצורת הניסוי נמדדו מספר היבטים מרכזיים לקביעת היעילות והאפקטיביות של פתרונות שונים.
להלן סקירה מפורטת של מערך הניסוי ומה נמדד.
מערכי נתונים
- משפטי בנקאות פולניים מוקלטים: בסך הכל הוקלטו 52 משפטים הספציפיים לתרחישי בנקאות. משפטים אלה כללו דוגמאות כמו “האם היועץ יכול לעזור לי בהגדרת יעדי החיסכון החדשים שלי באפליקציית הבנק?“ (אנגלית: האם יועץ יכול לעזור לי להגדיר את יעדי החיסכון החדשים שלי באפליקציית הבנק?).
- שיחות ארוכות: בנוסף למשפטים, הוקלטו 3 שיחות מורחבות בין יועץ ללקוח. דיאלוגים אלה הדמו אינטראקציות בנקאיות אמיתיות, ולכדו את המורכבות והמגוון של תרחישי שירות לקוחות במגזר הבנקאי.
- רמות רעש מיושמות: לאחר ההקלטה, דגימות אודיו אלו הועברו דרך שבעה רמות שונות של רעש לבן, עם ערכי יחס אות לרעש (SNR) שנעו בין 20- ל-10. הדבר נעשה כדי לבחון את העמידות של פתרונות STT בתנאי שמיעה שונים שאיתם ניתן להיתקל בסביבות מציאותיות.
מדדי הערכה
לצורך ההערכה שלנו, נתנו עדיפות לפשטות ובהירות בבחירת המדדים, לאור המגבלות על זמן ומשאבי המחקר. התמקדנו בשני מדדים פשוטים אך חושפניים להערכת הפתרונות:
שיעור שגיאות מילים (WER)
המדד העיקרי להערכת הדיוק של פתרונות STT היה WER עבור דגימות אודיו ללא רעש מוסף. מדד זה סיפק קו בסיס לביצועים בתרחיש הטוב ביותר. WER הוא מדד מרכזי המשמש להערכת הדיוק של מערכות זיהוי דיבור.
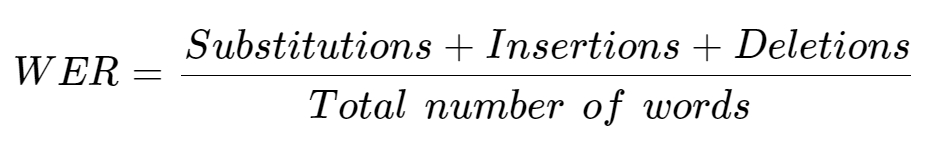
הוא מחושב כמספר השגיאות (הכוללות החלפות, השמטות והוספות של מילים) חלקי המספר הכולל של המילים שנאמרו, ובעצם מכמת באיזו תדירות המערכת טועה בהבנת מילים או מפספסת אותן. מדד זה מסייע בהשוואת היעילות של פתרונות שונים של המרת דיבור לטקסט, במיוחד בהבנת מהימנותם בתמלול מדויק של שפה מדוברת.
זמן ביצוע
הזמן שנדרש לתמלול נמדד בכל אחת מסביבות הענן (GCP, Azure, AWS המארחות את OpenAI Whisper) כדי להימנע מהטיות הקשורות לעיבוד מקומי (on-premises). מדד זה סייע בהערכת היעילות של כל פתרון.
פתרונות שנבדקו
בניסיוננו לזהות את שירותי הדיבור הציבורי היעילים ביותר עבור המגזר הבנקאי הפולני, בדקנו מספר פתרונות בולטים. קריטריוני הבחירה שלנו התבססו על פופולריות בשוק, יכולות תמיכה בשפות ותצורות אחסון, תוך הבטחת הערכה מגוונת ומקיפה.
Google Cloud Platform (GCP) ו-Microsoft Azure: אלה נבחרו מכיוון שהם הפתרונות הפופולריים ביותר בשוק והיו אפשרויות זמינות בשער הקולי. השימוש הנרחב והמוניטין שלהם בתעשייה הפכו אותם למועמדים מובילים להערכה.
OpenAI Whisper המתארח ב-AWS: נבחר בשל תמיכתו בשפה הפולנית וכפתרון מתארח עצמאית, המספק ניגוד לאפשרויות ה-serverless של GCP ו-Azure. הכללתו אפשרה השוואה מקיפה בין פתרונות serverless לפתרונות מתארחים עצמאית מבחינת ביצועים, מדרגיות ושיקולים תפעוליים.
תוצאות
הניסוי נועד ללכוד תמונה מקיפה של האופן שבו כל שירות STT ביצע את תפקידו לאורך ממדים שונים:
דיוק בתנאי שמיעה שונים: על ידי יישום רמות רעש שונות, הניסוי בחן עד כמה כל שירות הצליח להתמודד עם שינויים באיכות האודיו.
ביצועים בתרחישי בנקאות מציאותיים: השימוש במשפטים בנקאיים אמיתיים ובשיחות מורחבות סיפק סביבת בדיקה מציאותית לכל שירות STT.
הגדרה זו סיפקה הבנה מפורטת של החוזקות והמגבלות של כל שירות ביישום בנקאי בעולם האמיתי, והנחתה את קבלת ההחלטות בבחירה וביישום של טכנולוגיות STT.
דיוק בתנאי שמיעה שונים
לפני בדיקת רמות רעש שונות, הקיימות בתרחישי העולם האמיתי, בדקנו ביצועי בסיס של תמלול דיבור לטקסט עם דגימות ראשוניות שלא הושפעו מרעש לבן מלאכותי. בהערכת יכולות תמלול הדיבור לטקסט של מנועים שונים עבור המגזר הבנקאי הפולני, התמקד הניתוח שלנו במערך נתונים שכלל 52 משפטים ו-3 שיחות, המשקפים את השיח האופייני הנפוץ בשירות לקוחות.
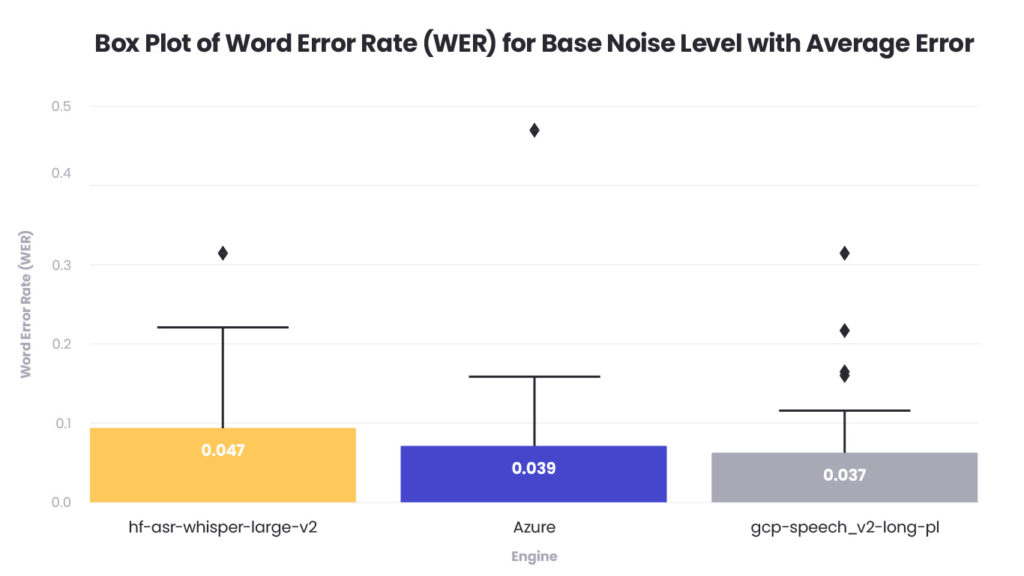
הנתונים החזותיים המוצגים בגרף תיבת התפלגות הנלווה ממחישים את שיעור שגיאות המילים (WER) בשלושה מנועי המרת דיבור לטקסט נבחרים. המנוע הראשון, (AWS) hfasr-whisper-large-v2, מסומן בכתום וחושף WER ממוצע של 0.047, עם טווח המצביע על דיוק משתנה. לעומת זאת, Azure מוצג בכחול ו (GCP) gcp-speech-v2-long-pl המוצגים באפור, מציגים עקביות הדוקה יותר בתוצאות עם ממוצע WER של 0.039 ו-0.037 בהתאמה.
ניתוח שיעור שגיאות מילים לפי אורכי אודיו
בהקשר של המחקר הפנימי שלנו, תחת מגבלות משאבים וזמן, להערכת שירותי דיבור ציבורי בתחום הבנקאות הפולנית, הקדשנו תשומת לב מיוחדת לשיעור שגיאות המילים (WER) ביחס לאורך דגימות האודיו. מרכיב זה במחקר שלנו חיוני כדי להעריך כיצד שירותי תמלול דיבור לטקסט שונים מתמודדים עם קלטי אודיו באורכים משתנים, דבר הנפוץ באינטראקציות של שירות לקוחות.
גישת המחקר ומגבלותיו
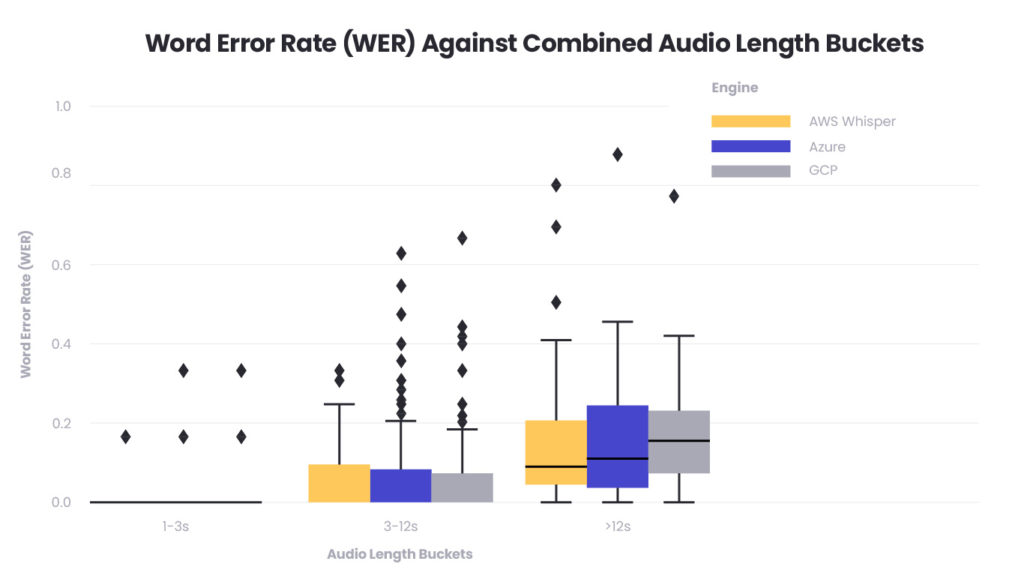
המחקר כלל סיווג של משפטים ושיחות בנקאיות מוקלטות לשלוש קטגוריות של אורך אודיו: קצר (1-3 שניות), בינוני (3-12 שניות) וארוך (מעל 12 שניות). למרות המגבלות ברוחב ובעומק הנתונים עקב אילוצי זמן ומשאבים, הסיווג אפשר הערכה ממוקדת של הביצועים של כל מנוע speech-to-text.
פרשנות והשלכות
הגרף מציע המחשה כיצד WER מופץ בין אורכי האודיו השונים עבור כל שירות. באופן בולט, כל השירותים מתפקדים יחסית היטב עם קטעי אודיו קצרים. עם זאת, קיים גידול ניכר ב-WER עבור קלטי אודיו ארוכים יותר. אפשרות אחת היא שקלטי אודיו ארוכים יותר מכילים באופן טבעי יותר מידע ולכן יותר נקודות שגיאה פוטנציאליות, כולל מבני משפטים מורכבים. בנוסף, שיחות ארוכות יותר עשויות לכלול אוצר מילים ותחביר מגוונים יותר, מה שיכול לבחון את גבולות המודלים המאומנים, במיוחד אם נתוני האימון לא כיסו באופן מספק גיוון כזה.
השפעת רעש לבן על דיוק המרת דיבור לטקסט
בשלב הבא של המחקר הפנימי שלנו, הוספנו רעש לבן לרשומות האודיו הבסיסיות שלנו כדי לדמות סביבה שמיעתית ריאלית ומאתגרת יותר. שלב זה היה קריטי בקביעת העמידות של שירותי המרת דיבור לטקסט כנגד דרגות שונות של רעש רקע, שהיא בעיה נפוצה בשיחות טלפון בעולם האמיתי במגזר הבנקאי. יחס אות לרעש (SNR) שימש כמדד לאתגרים אלו, כאשר ערכי SNR שליליים מצביעים על תרחישים שבהם הרעש גובר על הדיבור, וערכים חיוביים מייצגים תנאי דיבור ברורים יותר.
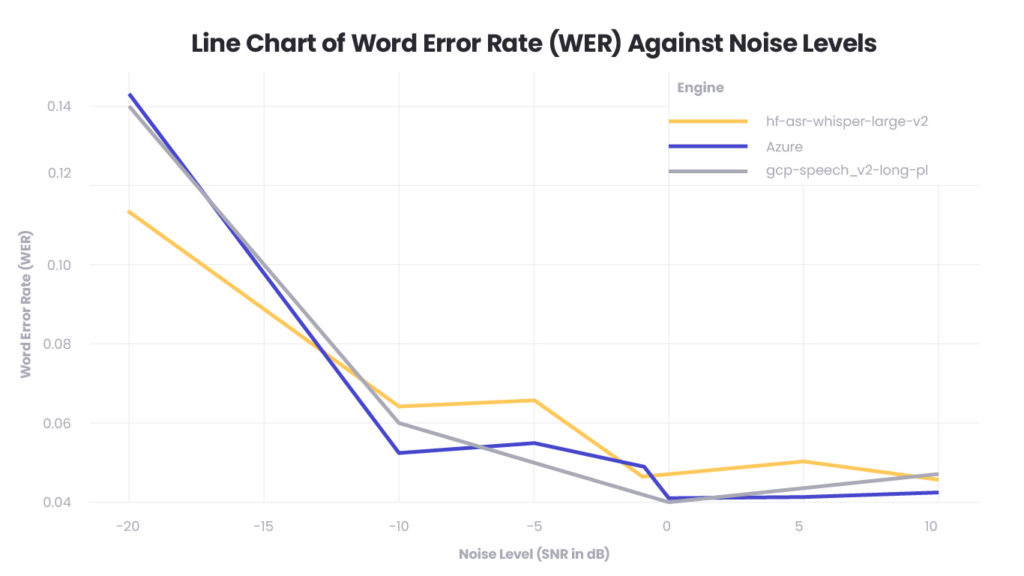
תרשים הקו המוצג מציג את שיעור שגיאות המילים (WER) של כל מנוע המרת דיבור לטקסט ביחס לרמות שונות של רעש, הנמדדות כיחס אות לרעש (SNR) בדציבלים. המנועים שנבדקו, ובהם AWS Whisper, Azure ושירות המרת הדיבור לטקסט של GCP, מציגים כיצד הביצועים שלהם נפגעים ככל שהרעש גובר, כצפוי בהתחשב בכך שרעש עלול לטשטש את בהירות הדיבור.
מסקנות
נוכחות של רעש לבן בדרך כלל מגדילה את שיעור שגיאות המילים (WER) בכל השירותים, כאשר ההשפעה המשמעותית ביותר מתרחשת ברמות רעש גבוהות יותר (ערכי SNR נמוכים יותר). ככל שרמת הרעש פוחתת (ערכי SNR גבוהים יותר), השירותים מתחילים לשחזר את הדיוק, מה שמצביע על כך שיש להם יכולת מסוימת להבחין בין דיבור לרעש רקע עד לסף מסוים.
בהשוואה בין שירותי המרת דיבור לטקסט בתנאי רעש משתנים, התוצאות מציגות תמונה מורכבת. AWS Whisper הפגין את הביצועים העמידים ביותר בתרחישי רעש קיצוניים, במיוחד ב-SNR של -20 dB, מה שמעיד על מידת חוסן גבוהה בהגדרות איכות שמע ירודה מאוד. עם זאת, ככל שה-SNR עלה לרמות המייצגות יותר שיחות טלפון רועשות אופייניות, גם AWS וגם GCP התבלטו כמתחרים חזקים, והציגו דיוק משופר בתמלול דיבור.
קשה להסיק באופן חד-משמעי איזה משני השירותים הללו—AWS או GCP—מספק ביצועים עדיפים בהתבסס על גודל המדגם המוגבל של המחקר שלנו. שני השירותים הפגינו יכולות בולטות בטיפול ברעש רקע, וההבדלים בביצועיהם היו שוליים. הדבר מצביע על כך שעבור סביבות עם כמות מתונה של רעש, כגון אלו הצפויות בפעילות מוקדי שירות, גם AWS וגם GCP מציעים פתרונות המרת דיבור לטקסט ברי-קיימא, כאשר הבחירה תלויה ככל הנראה בגורמים אחרים כגון יכולות אינטגרציה, עלות והעדפת המשתמש.
חשוב להבין שדציבלים הם יחידת מידה יחסית, במיוחד כאשר דנים ביחס אות לרעש (SNR). ה-SNR יכול להשתנות באופן משמעותי בהתאם לרמת ההספק של אות הכניסה; אות בעל הספק גבוה יותר, גם עם אותה כמות רעש, יניב ערך SNR גבוה יותר. שונות זו מדגישה את המורכבות של הערכה מדויקת של ביצועי המרת דיבור לטקסט בתנאי עולם אמיתי שונים.
תקציר
המחקר שלנו בנושא ההשפעה של רעש על שירותי המרת דיבור לטקסט מצביע על תחום שמבשיל לפיתוח נוסף, במיוחד בכל הנוגע לתקינה של רמות אותות קלט להשגת מדידות SNR אחידות יותר. בהיקף ובדרישות של פרויקט זה, רמת הניתוח הנוכחית סיפקה תובנות מספקות.
עם זאת, גישה מדויקת יותר ל-SNR יכולה לשפר את הדיוק החזוי של האופן שבו שירותים אלה יפעלו בסביבות אקוסטיות מגוונות בפעילות שירות הלקוחות של המגזר הבנקאי.
בחלק השני של מאמר זה, נציג לך טכנולוגיה נוספת הממלאת תפקיד מכריע בפיתוח voicebots (ולא רק בתעשיית הבנקאות) – TTS – Text-to-Speech. זוהי טכנולוגיה הממירה טקסט כתוב לדיבור.


arrow_circle_right מאמרים נוספים
בחרו את הקריאה הבאה שלכם



arrow_circle_rightצור קשר
