الروبوتات الصوتية المدعومة بالذكاء الاصطناعي في القطاع المصرفي البولندي (الجزء 1)


في المشهد سريع التطور للخدمات المصرفية الرقمية، لا يمكن المبالغة في أهمية خدمات الكلام العامة الفعّالة. تؤدي هذه الخدمات دورًا محوريًا في تعزيز تجربة العملاء، لا سيما في سياق القطاع المصرفي البولندي، حيث يكون التفاعل مع العملاء والتواصل أمرًا بالغ الأهمية. ومع التقدم في الذكاء الاصطناعي ومعالجة اللغة الطبيعية، شهدت قدرات خدمات الكلام العامة تحولًا ملحوظًا، مما يوفر طرقًا أكثر بديهية وكفاءة للتفاعل مع العملاء.
ينمو سوق الروبوتات الصوتية في القطاع المالي البولندي بشكل ديناميكي. اعتاد العملاء الآن على التحدث مع المساعدين الافتراضيين وطرح أسئلتهم الشائعة عليهم، مثل الاستفسار عن حالة الحساب. على سبيل المثال، يستخدم PKO، أحد أقدم البنوك البولندية، المساعدين الافتراضيين منذ أكثر من ثلاث سنوات حتى الآن. في الواقع، وفقًا لبيانهم الصحفي، لديهم ما يصل إلى 18 مساعدًا افتراضيًا مختلفًا، واعتبارًا من أغسطس 2023، أجرت روبوتاتهم الصوتية وحدها بالفعل أكثر من 25 مليون محادثة مع أكثر من 9 ملايين عميل. مثير للإعجاب، أليس كذلك؟
مع النمو السريع لـAI، من الجيد الاطلاع على كيفية إمكانية تطبيق التقنيات المرتبطة بالذكاء الاصطناعي في البنوك والمؤسسات المالية الأخرى. وهذا هو المحور الرئيسي لهذه الدراسة والمقال، اللذين أُعدّا بالتعاون بين كاميل ماخاليتسا، كبير علماء بيانات الذكاء الاصطناعي، وشيمون روژدجينسكي، مهندس برمجيات DevOps.
لنبدأ استكشافاً مفصلاً لمختلف خدمات الكلام العامة، مع التركيز بشكل خاص على تطبيقها في قطاع الخدمات المصرفية البولندي. ولمحاكاة احتياجات عملائنا عن كثب، المشابهة لتلك الموجودة في بيئات مراكز الاتصال، ستخضع هذه التقنيات للاختبار بجمل مصممة خصيصاً لسيناريوهات مصرفية.
سيتم بعد ذلك تعزيز هذه العينات بمستويات مختلفة من الضوضاء، مما يخلق محاكاة واقعية لبيئة الصوت النموذجية في المحادثات الهاتفية مع العملاء الحقيقيين. وقد صُممت منهجيتنا لتقديم تقييم واقعي لقدرات كل خدمة، بما يعكس الطبيعة المعقدة والمتطلبة لتفاعلات العملاء في مراكز الاتصال المصرفية.
ولكن قبل أن نصل إلى ذلك، هناك عدة تحديات محتملة يجب مناقشتها.
التحديات المتعلقة بالروبوتات الصوتية المدعومة بالذكاء الاصطناعي في القطاع المصرفي البولندي
بينما نتوغل في دمج خدمات الكلام العامة في القطاع المصرفي البولندي، نواجه مجموعة من التحديات. هذه العقبات حاسمة لتطوير تقنيات كلام فعالة وفعالة من حيث التكلفة مصممة خصيصًا لتلبية احتياجات العملاء البولنديين. نوجز هنا بعض التحديات الرئيسية:
دعم محدود للغة البولندية
يتمثل أحد التحديات الرئيسية في الدعم المحدود للغة البولندية في خدمات الكلام العامة السائدة. على سبيل المثال، لا يدعم AWS Lex، وهي خدمة معروفة لتحويل الكلام إلى نص، اللغة البولندية. وهذا يستلزم استكشاف حلول بديلة أو تطوير نماذج مخصصة للقواعد النحوية المعقدة وفروق النطق الدقيقة في اللغة البولندية.
محدودية موارد البحث
نظرًا لقلة الدراسات الخارجية والمعايير المرجعية المتعلقة بالتطبيقات الخاصة بالقطاع المصرفي البولندي، تُجرى معظم الأبحاث في هذا المجال داخليًا. وهذا يعني أن المؤسسات غالبًا ما تبدأ من الصفر، مستثمرةً وقتًا وموارد كبيرة في الأبحاث الأولية لفهم قدرات وقيود تقنيات الكلام الحالية الخاصة باللغة البولندية والمتطلبات المصرفية. وتخضع خدمات الحوسبة السحابية العامة لتغييرات كبيرة، مما يؤدي إلى أن تصبح الأبحاث غالبًا قديمة.
قيود الوقت وحدود البيانات في البحث
يتمثل أحد التحديات الكبيرة الأخرى في ضيق الوقت، نظرًا لأن البحث ليس الهدف الأساسي للمشروع. كان على المشروع التعامل مع هذا القيد، مما أدى إلى مجموعة بيانات كافية للاحتياجات المباشرة للمشروع رغم أنها ليست واسعة النطاق. ومع ذلك، لتحقيق رؤى أكثر شمولاً ودقة، سيستفيد البحث من المزيد من الأمثلة الصوتية والمزيد من المُصنِّفين، بما يتجاوز الاثنين المشاركين. ومن شأن ذلك أن يعزز تعلّم النظام وأداءه، لا سيما في بيئة موجهة للعملاء.
مقاييس المقارنة – STT و TTS
يتسم تقييم خدمات الكلام العامة بجانبين: تحويل الكلام إلى نص (STT) وتحويل النص إلى كلام (TTS). يركز STT على النسخ الدقيق للغة البولندية المنطوقة إلى نص، وهو أمر بالغ الأهمية لفهم استفسارات العملاء. أما تقييم TTS فيتعلق بتحويل اللغة البولندية المكتوبة إلى كلمات منطوقة بطريقة طبيعية ودقيقة، وهو أمر ضروري لتقديم ردود واضحة ومفهومة للعملاء.
في الأقسام التالية، سنستكشف كل تحدٍ بالتفصيل، ونناقش تأثيره على نشر خدمات الكلام العامة في القطاع المصرفي البولندي والاستراتيجيات المحتملة لمعالجتها.
تحويل الكلام إلى نص
تقنية تُعرف باسمSTT – تحويل الكلام إلى نص، المعروف أيضًا بالتعرف التلقائي على الكلام (ASR)، يحوّل اللغة المنطوقة إلى نص مكتوب. وهو مفيد بشكل خاص في التطبيقات التي تحتاج فيها الكلام إلى تحويله إلى شكل يمكن لأجهزة الكمبيوتر والخوارزميات الذكية معالجته. على سبيل المثال، المساعدون الافتراضيون لدعم العملاء.
تم تصميم تجربة لاختبار قدرات تحويل الكلام إلى نص (STT) لتقييم خدمات الكلام العامة في القطاع المصرفي البولندي. في إعداد التجربة، تم قياس عدة جوانب رئيسية لتحديد فعالية وكفاءة الحلول المختلفة.
فيما يلي نظرة تفصيلية على إعداد التجربة وما تم قياسه.
مجموعات البيانات
- الجمل المصرفية البولندية المسجلة: تم تسجيل ما مجموعه 52 جملة خاصة بسيناريوهات مصرفية. تضمنت هذه الجمل أمثلة مثل “هل يمكن للمستشار مساعدتي في تكوين أهدافي الادخارية الجديدة في تطبيق البنك؟“ (بالإنجليزية: هل يمكن لمستشار مساعدتي في إعداد أهدافي الادخارية الجديدة في تطبيق الخدمات المصرفية؟).
- محادثات مطولة: بالإضافة إلى الجمل، تم تسجيل 3 محادثات موسّعة بين مستشار وعميل. حاكَت هذه الحوارات تفاعلات مصرفية حقيقية، والتقطت تعقيد وتنوع سيناريوهات خدمة العملاء في القطاع المصرفي.
- مستويات الضوضاء المطبقة: بعد التسجيل، خضعت هذه العينات الصوتية لسبعة مستويات مختلفة من الضوضاء البيضاء، مع قيم نسبة الإشارة إلى الضوضاء (SNR) التي تتراوح من -20 إلى 10. تم ذلك لاختبار متانة حلول تحويل الكلام إلى نص (STT) في ظروف سمعية متنوعة قد يتم مواجهتها في البيئات الواقعية.
مقاييس التقييم
لتقييمنا، أعطينا الأولوية للبساطة والوضوح في اختيار المقاييس، نظراً للقيود المفروضة على وقت البحث وموارده. ركزنا على مقياسين مباشرين لكن كاشفين لتقييم الحلول:
معدل خطأ الكلمات (WER)
كان المقياس الأساسي لتقييم دقة حلول STT هو معدل خطأ الكلمات (WER) لعينات صوتية دون أي ضوضاء مضافة. وقد وفّر هذا المقياس خط أساس لأداء أفضل سيناريو. يُعد WER مقياساً رئيسياً يُستخدم لتقييم دقة أنظمة التعرف على الكلام.
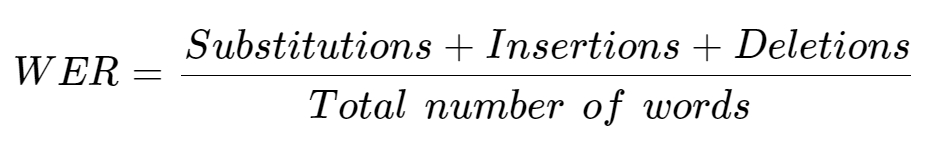
يُحسب هذا على أنه عدد الأخطاء (التي تشمل الاستبدال والحذف والإدراج للكلمات) مقسومًا على إجمالي عدد الكلمات المنطوقة، وهو ما يحدد أساسًا مدى تكرار سوء فهم النظام للكلمات أو تفويته لها. يساعد هذا المقياس في مقارنة فعالية حلول تحويل الكلام إلى نص المختلفة، لا سيما في فهم موثوقيتها في النسخ الدقيق للغة المنطوقة.
وقت التنفيذ
تم قياس الوقت المستغرق في النسخ في كل من بيئات السحابة (GCP، Azure، AWS المستضيفة لـ OpenAI Whisper) لتجنب التحيزات المرتبطة بالمعالجة المحلية. ساعد هذا المقياس في تقييم كفاءة كل حل.
الحلول المُختبرة
في سعينا لتحديد أكثر خدمات الكلام العامة فعالية لقطاع الخدمات المصرفية البولندي، اختبرنا عدة حلول بارزة. استندت معايير اختيارنا إلى الشعبية في السوق، وقدرات دعم اللغات، وتكوينات الاستضافة، مما ضمن تقييماً متنوعاً وشاملاً.
منصة جوجل السحابية (GCP) ومايكروسوفت أزور: تم اختيارهما لأنهما الحلول الأكثر شيوعاً في السوق وكانا من الخيارات المتاحة في بوابة الصوت. وقد جعلهما استخدامهما الواسع وسمعتهما في القطاع مرشحين رئيسيين للتقييم.
OpenAI Whisper المستضاف على AWS: اختير لدعمه اللغة البولندية ولكونه حلاً مستضافاً ذاتياً، مما يوفر تبايناً مع الخيارات الخالية من الخوادم في GCP وAzure. وقد أتاح هذا الإدراج إجراء مقارنة شاملة بين الحلول الخالية من الخوادم والحلول المستضافة ذاتياً من حيث الأداء وقابلية التوسع والاعتبارات التشغيلية.
النتائج
هدفت التجربة إلى التقاط صورة شاملة لكيفية أداء كل خدمة تحويل الكلام إلى نص (STT) عبر أبعاد مختلفة:
الدقة في الظروف السمعية المختلفة: من خلال تطبيق مستويات ضوضاء مختلفة، قيّمت التجربة مدى قدرة كل خدمة على التعامل مع اختلافات جودة الصوت.
الأداء في سيناريوهات مصرفية واقعية: وفّر استخدام جمل مصرفية فعلية ومحادثات موسّعة بيئة اختبار واقعية لكل خدمة STT.
أتاح هذا الإعداد فهمًا تفصيليًا لنقاط القوة والقيود الخاصة بكل خدمة في تطبيق مصرفي واقعي، مما وجّه عملية اتخاذ القرار في اختيار تقنيات STT وتنفيذها.
الدقة في ظروف سمعية مختلفة
قبل اختبار مستويات الضوضاء المختلفة الموجودة في السيناريوهات الواقعية، اختبرنا أداءً أساسياً لتحويل الكلام إلى نص باستخدام عينات أولية لم تتأثر بالضوضاء البيضاء الاصطناعية. في تقييم قدرات تحويل الكلام إلى نص لمحركات مختلفة في القطاع المصرفي البولندي، ركز تحليلنا على مجموعة بيانات تتكون من 52 جملة و3 محادثات، تحاكي الخطاب النموذجي الذي يُصادف في خدمة العملاء.
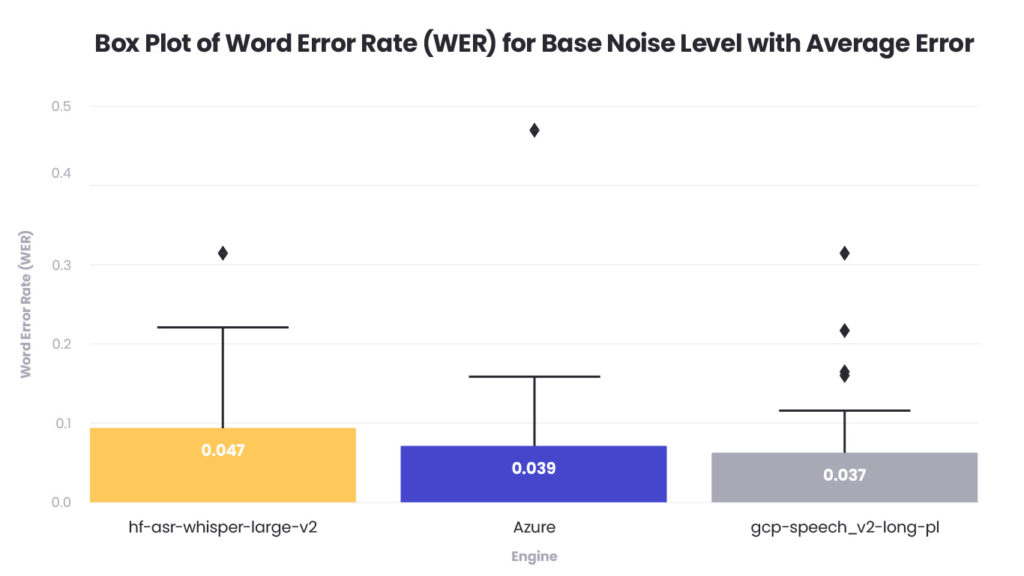
يوضح الرسم البياني للمربع والإحصاءات المرفق معدل خطأ الكلمات (WER) عبر ثلاثة محركات مختارة لتحويل الكلام إلى نص. المحرك الأول، (AWS) hfasr-whisper-large-v2، يُشار إليه باللون البرتقالي ويكشف عن متوسط معدل خطأ الكلمات (WER) بنسبة 0.047، مع نطاق يشير إلى دقة متغيرة. في المقابل، Azure يظهر باللون الأزرق و (GCP) gcp-speech-v2-long-pl الموضحة باللون الرمادي، تُظهر اتساقًا أكبر في النتائج بمتوسط WER يبلغ 0.039 و0.037 على التوالي.
تحليل معدل خطأ الكلمات عبر أطوال الصوت المختلفة
في سياق بحثنا الداخلي المحدود بالموارد والوقت لتقييم خدمات الكلام العامة في القطاع المصرفي البولندي، أولينا اهتماماً خاصاً لمعدل خطأ الكلمات (WER) فيما يتعلق بطول العينات الصوتية. يُعد هذا المكوّن من دراستنا أساسياً لقياس كيفية تعامل خدمات تحويل الكلام إلى نص المختلفة مع المدخلات الصوتية ذات المدد المتفاوتة، وهو أمر شائع في تفاعلات خدمة العملاء.
منهجية البحث والقيود
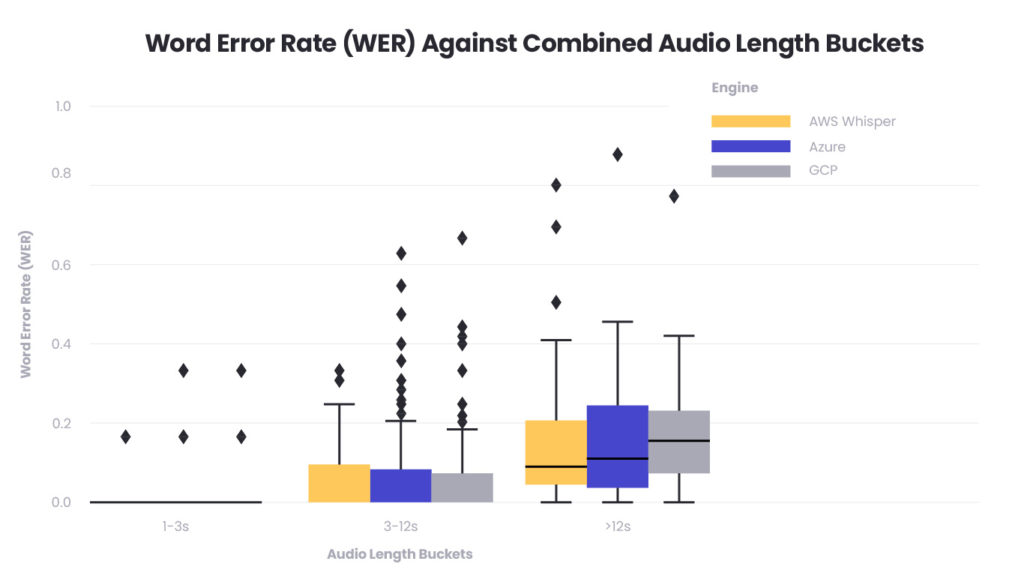
تضمنت الدراسة تصنيف الجمل والمحادثات المصرفية المسجلة إلى ثلاث فئات حسب طول الصوت: قصير (1-3 ثوانٍ)، ومتوسط (3-12 ثانية)، وطويل (أكثر من 12 ثانية). على الرغم من القيود في اتساع وعمق البيانات بسبب قيود الوقت والموارد، أتاح التصنيف إجراء تقييم مركّز لأداء كل محرك تحويل الكلام إلى نص.
التفسير والآثار المترتبة
يقدم الرسم البياني تصوراً لكيفية توزيع معدل خطأ الكلمات (WER) بين أطوال الصوت المختلفة لكل خدمة. ومن الجدير بالذكر أن جميع الخدمات تؤدي أداءً جيداً نسبياً مع المقاطع الصوتية القصيرة. ومع ذلك، هناك زيادة ملحوظة في معدل خطأ الكلمات للمدخلات الصوتية الأطول. أحد الاحتمالات هو أن المدخلات الصوتية الأطول تحتوي بطبيعتها على معلومات أكثر، وبالتالي نقاط خطأ محتملة أكثر، بما في ذلك تراكيب الجمل المعقدة. بالإضافة إلى ذلك، قد تحتوي المحادثات الأطول على مفردات وتراكيب نحوية أكثر تنوعاً، مما قد يختبر حدود النماذج المدربة، خاصة إذا لم تغطِ بيانات التدريب هذا التنوع بشكل كافٍ.
تأثير الضوضاء البيضاء على دقة تحويل الكلام إلى نص
في المرحلة اللاحقة من دراستنا الداخلية، أضفنا ضوضاء بيضاء إلى تسجيلاتنا الصوتية الأساسية لمحاكاة بيئة سمعية أكثر واقعية وتحدياً. كانت هذه الخطوة حاسمة في تحديد مدى متانة خدمات تحويل الكلام إلى نص أمام درجات متفاوتة من الضوضاء الخلفية، وهي مشكلة شائعة في المحادثات الهاتفية الواقعية في القطاع المصرفي. استُخدمت نسبة الإشارة إلى الضوضاء (SNR) كمقياس لهذه التحديات، حيث تشير قيم SNR السالبة إلى سيناريوهات تطغى فيها الضوضاء على الكلام، بينما تمثل القيم الموجبة ظروف كلام أوضح.
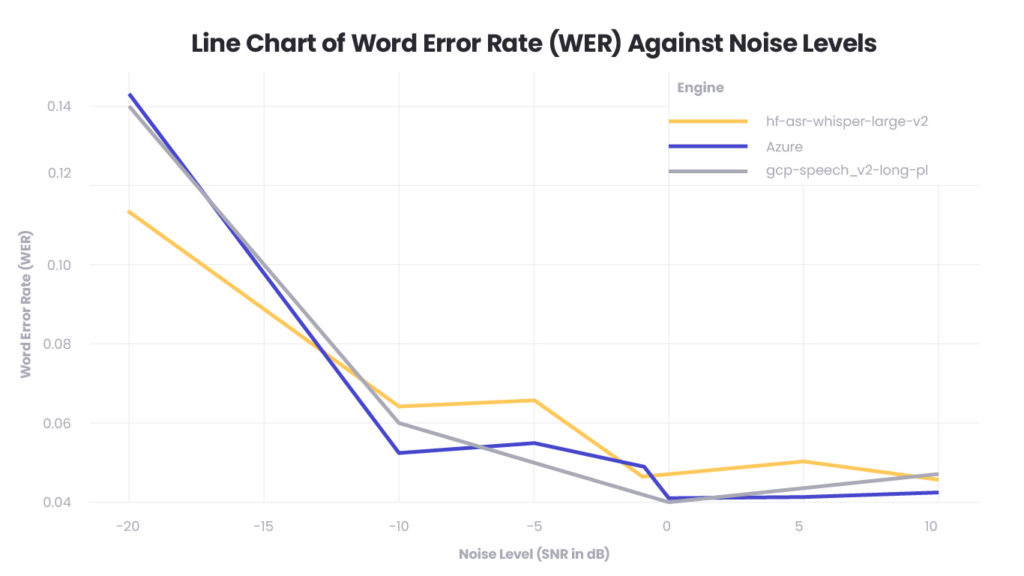
يعرض المخطط الخطي المقدم معدل خطأ الكلمات (WER) لكل محرك تحويل الكلام إلى نص مقابل مستويات مختلفة من الضوضاء، مقاسة بنسبة الإشارة إلى الضوضاء (SNR) بالديسيبل. تُظهر المحركات المختبرة، بما في ذلك AWS Whisper وAzure وخدمة تحويل الكلام إلى نص من GCP، كيف يتدهور أداؤها مع زيادة الضوضاء، وهو أمر متوقع نظرًا لأن الضوضاء يمكن أن تحجب وضوح الكلام.
الاستنتاجات
يؤدي وجود الضوضاء البيضاء عمومًا إلى زيادة معدل خطأ الكلمات (WER) في جميع الخدمات، مع حدوث التأثير الأكبر عند مستويات الضوضاء الأعلى (قيم SNR المنخفضة). ومع انخفاض مستوى الضوضاء (ارتفاع قيم SNR)، تبدأ الخدمات في استعادة دقتها، مما يشير إلى امتلاكها قدرة معينة على التمييز بين الكلام والضوضاء الخلفية حتى حد معين.
في مقارنة خدمات تحويل الكلام إلى نص تحت ظروف ضوضاء متفاوتة، ترسم النتائج صورة دقيقة. أظهر AWS Whisper الأداء الأكثر قوة في سيناريوهات الضوضاء القصوى، خاصة عند نسبة إشارة إلى ضوضاء SNR تبلغ -20 ديسيبل، مما يشير إلى درجة عالية من المرونة في إعدادات جودة الصوت الضعيفة جدًا. ومع ذلك، مع زيادة SNR إلى مستويات أكثر تمثيلاً لمحادثات الهاتف الصاخبة النموذجية، برز كل من AWS وGCP كمنافسين قويين، مما أظهر دقة محسّنة في تحويل الكلام.
من الصعب الجزم بشكل قاطع أيهما من هذين الخدمتين — AWS أم GCP — يوفّر أداءً متفوقًا بناءً على حجم العينة المحدود في دراستنا. أظهرت كلتا الخدمتين قدرات ملحوظة في التعامل مع الضوضاء الخلفية، وكانت الفروق في أدائهما هامشية. يشير ذلك إلى أنه بالنسبة للبيئات التي تحتوي على قدر معتدل من الضوضاء، مثل تلك المتوقعة في عمليات مراكز الاتصال، تقدّم كل من AWS وGCP حلولاً قابلة للتطبيق لتحويل الكلام إلى نص، مع احتمال اعتماد الاختيار على عوامل أخرى مثل قدرات التكامل والتكلفة وتفضيلات المستخدم.
من المهم أن نفهم أن الديسيبل هو وحدة قياس نسبية، لا سيما عند مناقشة نسبة الإشارة إلى الضوضاء (SNR). يمكن أن تختلف نسبة الإشارة إلى الضوضاء اختلافًا كبيرًا اعتمادًا على مستوى قدرة إشارة الدخل؛ فالإشارة ذات القدرة الأعلى، حتى مع نفس كمية الضوضاء، ستؤدي إلى قيمة SNR أعلى. ويبرز هذا التباين مدى تعقيد التقييم الدقيق لأداء تحويل الكلام إلى نص في ظروف واقعية مختلفة.
الملخص
يشير بحثنا في تأثير الضوضاء على خدمات تحويل الكلام إلى نص إلى مجال خصب لمزيد من التطوير، لا سيما من حيث توحيد مستويات إشارة الإدخال لتحقيق قياسات أكثر اتساقًا لنسبة الإشارة إلى الضوضاء (SNR). وبالنسبة لنطاق هذا المشروع ومتطلباته، فقد وفّر مستوى التحليل الحالي رؤى كافية.
ومع ذلك، فإن اتباع نهج أكثر دقة تجاه SNR قد يعزّز الدقة التنبؤية لأداء هذه الخدمات في البيئات الصوتية المتنوعة لعمليات خدمة العملاء في القطاع المصرفي.
في الجزء الثاني من هذه المقالة، سنعرض لك تقنية أخرى تلعب دوراً حاسماً في تطوير الروبوتات الصوتية (وليس فقط في القطاع المصرفي) – TTS – تحويل النص إلى كلام. إنها تقنية تحوّل النص المكتوب إلى كلام.


arrow_circle_right مقالات أخرى
اختر قراءتك التالية



arrow_circle_rightاتصل بنا
