JSONB dans les projets JAVA


Les programmeurs backend peuvent stocker des données au format JSON depuis longtemps, depuis PostgresSQL 9.2. Cette solution présente un certain nombre d'avantages. Malheureusement, elle présente également plusieurs inconvénients.
Depuis la version 9.4, la représentation binaire de JSON – JSONB – a été introduite, ce qui enregistre les données un peu plus lentement que JSON, mais accélère leur traitement et permet de créer des index. Il est de notoriété publique que l'on peut créer des index sur une colonne JSONB, mais le sujet est assez complexe et l'on peut aboutir à des requêtes inefficaces.
Dans cet article, nous nous concentrerons sur JSONB. Je présenterai les bonnes pratiques d'utilisation de ce type de colonne et soulignerai ses limites.
Exemple de création d'un tableau et de son remplissage avec des données
J'aime visualiser ce qui est dit, alors créons une table avec une colonne de type JSONB contenant quelques données :
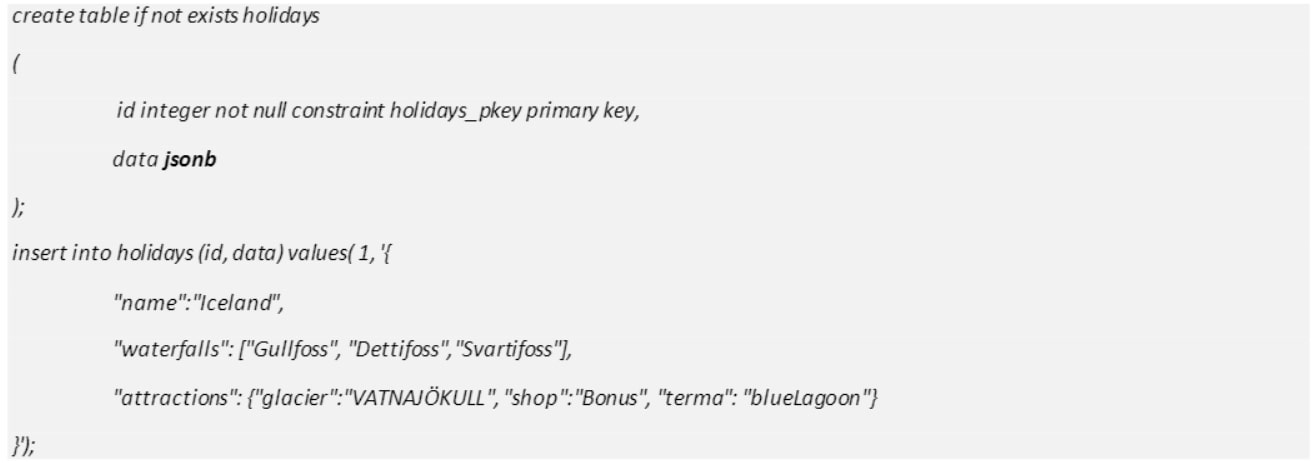
La colonne de type JSONB contient un champ texte (nom), une liste (waterfalls), et une carte (attractions).
Après avoir exécuté «sélectionner * des vacances» nous obtiendrons :
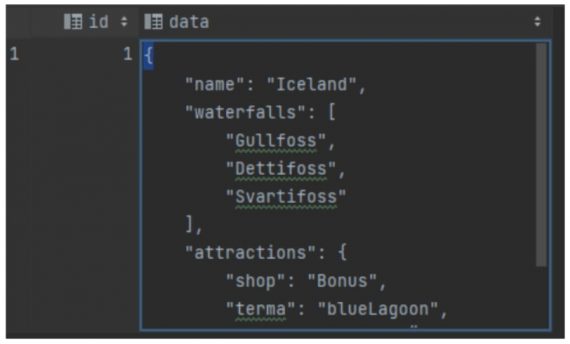
La création d'un tel modèle est simple. Il n'est pas nécessaire de spécifier les types de champs. Tout a été converti en JSONB sans aucun problème. La colonne ID a été ajoutée car la table sera mappée à une entité dans JPA qui nécessite un ID.
L'application de JSONB
Quand utiliser JSONB :
- Structure de données imprévisible : nous devons conserver les données dans la base de données, mais il n'est pas clair quelles données nous recevrons d'un fournisseur externe. Ou nous permettons au client de définir ses propres champs.
- De nombreux attributs (champs) sont rarement utilisés, par exemple des données conservées dans la base de données uniquement pour l'affichage. Ou bien nous les conservons simplement parce qu'ils pourraient être utiles un jour.
- Relation avec plusieurs objets : lorsque nous ne souhaitons pas appliquer la JOIN clause dans une table avec des relations pour des raisons de performance. Nous pouvons facilement enregistrer la liste des relations en JSONB.
Quand ne pas utiliser JSONB :
- Requêtes inefficaces : Postgres dans les requêtes utilise des statistiques qui ne sont pas conservées pour JSONB. Il devine comment exécuter une requête et fait parfois une mauvaise estimation. Grâce aux index, vous pouvez accélérer la requête, mais j'y reviendrai plus en détail plus loin dans l'article.
- Espace disque limité : KEY et VALUE sont conservés au format JSONB. Si vous avez un million d'enregistrements et que vous conservez KEY/VALUE pour chacun d'entre eux, la KEY sera dupliquée un million de fois. Je vous suggère de lire l'article qui décrit comment l'espace disque a été réduit de 30 % après la suppression de 45 clés des colonnes – https://heap.io/blog/when-to-avoid-jsonb-in-a-postgresql-schema
- Lorsque nous souhaitons appliquer une contrainte sur un champ : il n'est pas facile de rendre un champ unique.
Optimisation des requêtes : un regard de plus près sur l'indexation
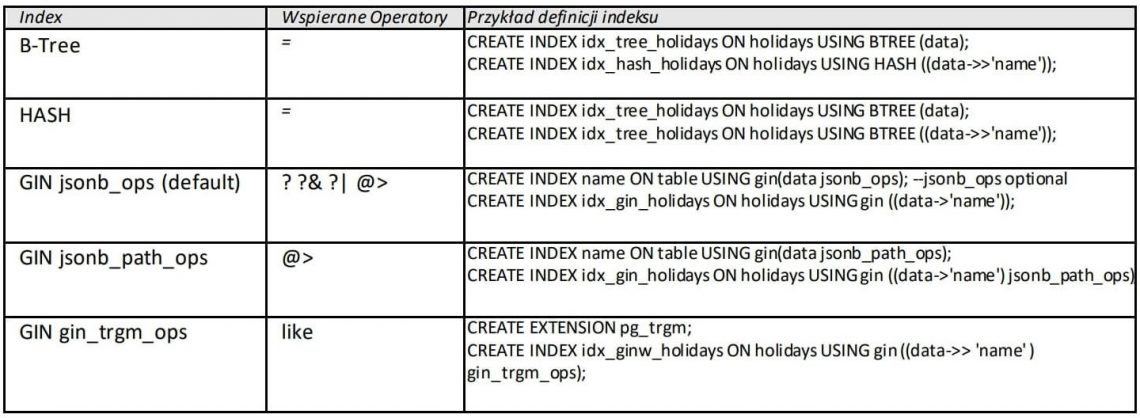
B-Tree: Il fonctionne uniquement avec l'opérateur d'égalité (=). Cela peut être fait pour toute la colonne JSONB ou sous forme de fonction sur un champ spécifique.
Hash: De manière similaire à un B-tree, il ne fonctionne qu'avec l'opérateur d'égalité (=). Il peut également être utilisé sur un champ dans JSONB. Avec B-tree, les requêtes sont plus rapides que les hashs, mais prennent plus d'espace et les insertions prennent plus de temps.
Gin:
- Postgres dispose de classes d'opérateurs intégrées pour l'index GIN (https://www.postgresql.org/docs/current/gin-builtin-opclasses.html)
L'index GIN avec la classe d'opérateurs JSONB_OPS (par défaut) prend en charge les opérateurs d'existence (?,? &,? |) et de contenance (@>). Il ne fonctionne que sur KEY. Il peut être appliqué sur une colonne ou un champ. Il faut faire attention à l'espace disque, car il en consomme beaucoup. Il est moins efficace que Hash et B-Tree, mais plus flexible.
- L'opérateur de classe Gin avec JSONB_PATH_OPS ne prend en charge que @> mais occupe moins d'espace ; SELECT, UPDATE, DELETE et le temps de compilation sont plus rapides qu'avec JSONB_OPS.
- Gin avec l'utilisation de GIN_TRGM_OPS comme seul index prend en charge l'opérateur like. Pour cela, vous devez installer l'extension PG_TRGM. Elle ne fonctionne que pour les valeurs, pas pour les clés.
À quoi ressemblent les requêtes Java ?
Dans mes projets, j'utilise diverses méthodes pour effectuer des requêtes avec Spring Data JPA. Afin d'essayer d'utiliser les index créés sur la table JSONB, nous nous concentrerons sur 3 options :
- Déclaration @Query
- Spécifications
- Déclaration @Query avec requête native
Déclaration @Query
JPA ne prend pas en charge les opérateurs JSONB (- >>? @> etc.). Par exemple, l'opérateur – >> peut être remplacé par la fonction JSONB_EXTRACT_PATH_TEXT.

A similaire requête peut be obtenu utilisant le spécification.
Spécifications

L'utilisation de spécifications pour les requêtes n'est pas lisible, mais elle est idéale pour construire des requêtes dynamiques. Malheureusement, écrire une requête à l'aide d'une fonction ne sera pas efficace. Si nous créons un index : BTREE ((data – >> ‘name’)), il sera ignoré lors de l'exécution de la requête utilisant des spécifications. Si nous voulons accélérer la requête, nous pouvons utiliser la fonction CREATE INDEX func_hname_indx ON holidays (jsonb_extract_path_text (data, ‘name’));
@Query avec une requête native

Les requêtes natives permettent d'utiliser des opérateurs destinés aux recherches JSONB, par exemple data – >> 'waterfalls' et donc, l'utilisation d'index.
Dans la section suivante, je décrirai une liste de requêtes avec des informations de performance.
Les exemples de création d'index et de requêtes
* SEQ = Recherche séquentielle sur l'ensemble de la table
* Analyse d'index = recherche rapide à l'aide de l'index
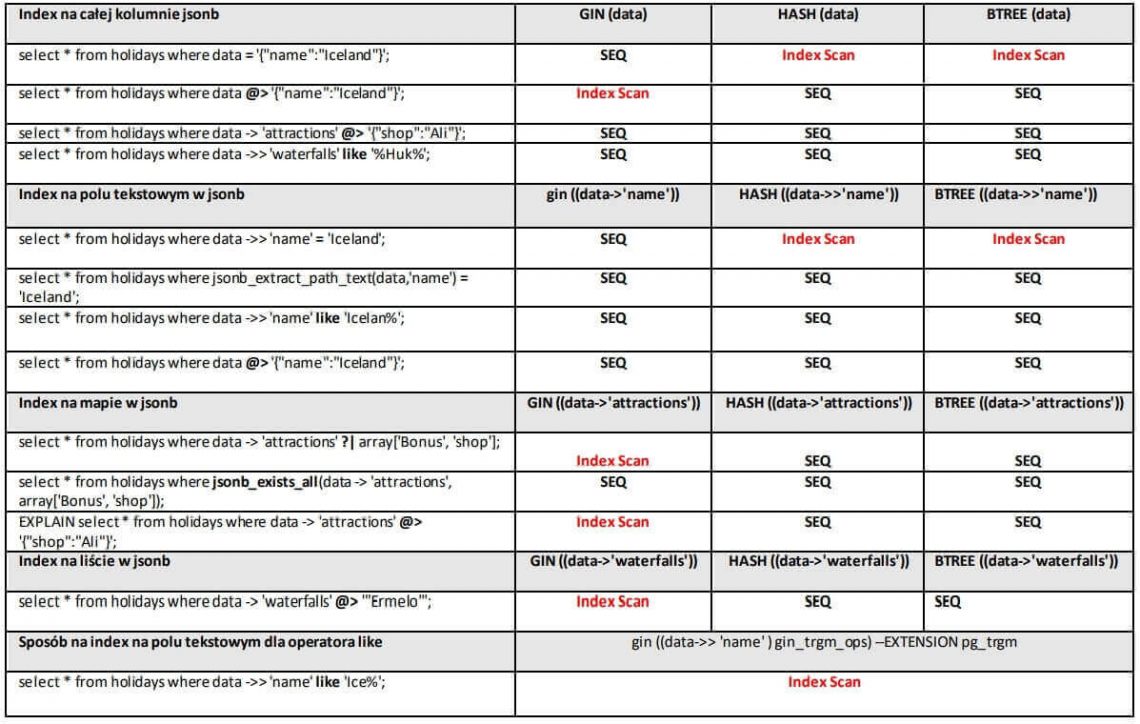
La liste ci-dessus montre la flexibilité de l'index Gin, qui peut être utilisé dans de nombreuses situations.
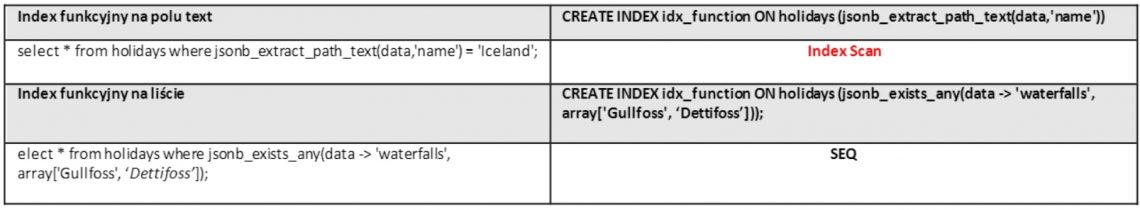
Pour ceux qui évitent les requêtes natives dans le code, mais qui ont besoin d'un index, je souhaite montrer un exemple d'index de fonction pouvant être utilisé et implémenté avec @Query.
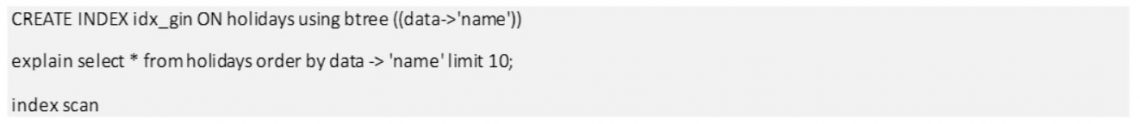
Trier les résultats : la clause « order by » is uniquement pris en charge par l'index BTree
Résumé
JSONB est très utile dans de nombreux cas, notamment pour les données en lecture seule et les données qui ne nécessitent pas de requêtes avancées.
Si notre projet nécessite l'utilisation de JSONB et de requêtes plus complexes, nous pouvons toujours créer un index et implémenter une requête native.
Pour les bases de données volumineuses (plus d'un million d'enregistrements), vous devez être particulièrement prudent et envisager de conserver les données dans les colonnes traditionnelles pour lesquelles les statistiques sont conservées et utilisées pour l'optimisation des requêtes.


arrow_circle_rightContactez-nous
Nous vous aiderons à choisir la technologie la mieux adaptée à votre solution
Marcin Zyga
Chief AI & Information Officer
arrow_circle_right Nos articles