Introduction à l'ingénierie logicielle


Chez Spyrosoft, nous sommes très fiers de notre culture de partage des connaissances. Compte tenu de la demande croissante d'ingénieurs logiciels, une tendance claire peut être observée – de plus en plus de personnes sont prêtes à commencer leur carrière dans l'informatique même sans formation technique formelle. Considérant cette tendance comme inévitable et naturelle, nous avons décidé de contribuer à la base de ressources croissante pour les nouveaux adeptes de l'ingénierie logicielle.
Cet article est le premier d'une série consacrée aux fondamentaux de l'ingénierie logicielle.
Introduction au génie logiciel : définition et signification
Commençons par définir l'ingénierie logicielle. L'histoire de l'ingénierie logicielle commence dans les années 1960. Sa définition est assez simple : l'ingénierie logicielle est une discipline d'ingénierie qui traite de tous les aspects de la production de logiciels. Qu'est-ce que cela signifie ? Décryptons-le.
Le domaine de l'ingénierie logicielle
L'ingénierie logicielle est généralement associée au codage, qui ne représente qu'une partie de l'ensemble du spectre d'activités qu'elle englobe. Voici une liste plus complète :
- Planification
- Analyse
- Développement
- Mise en œuvre
- Programmation
- Design
- Tests
- V&V (vérification et validation)
La plupart des praticiens de l'ingénierie logicielle considèrent le développement, la mise en œuvre et la programmation comme un domaine commun. On pourrait soutenir qu'ils ne sont pas identiques, mais il s'agirait d'un débat plutôt théorique et hautement abstrus. Par commodité, englobons-les tous sous le terme unique de développement.
Si nous parlons d'ingénierie logicielle, il est naturel que nous définissions également le terme « logiciel ». Wikipédia, citant la norme ISO/IEC 2382:2015, définit le logiciel comme « un ensemble de programmes informatiques et de documentation et données associées. Cela contraste avec le matériel, à partir duquel le système est construit et qui effectue le travail. ».
Pour une personne contemporaine, le logiciel est une évidence. Tout le monde l'utilise au quotidien. Des éléments comme les applications mobiles ou les divers systèmes web font partie intégrante de notre vie. Lorsque l'on observe le secteur du logiciel, il est important de distinguer deux types courants d'entreprises : les entreprises de produit et les entreprises de services.
Comme son nom l'indique, les entreprises de produits produisent un logiciel – un produit logiciel. Généralement, le produit est vendu à tout client capable et désireux de l'acheter. Il s'agit, par nature, d'un système générique, pas nécessairement adapté aux besoins du client. Au contraire, les entreprises de services, comme Spyrosoft, fournissent des produits entièrement personnalisés et dédiés à un client donné. Dans un premier temps, une analyse approfondie des besoins métier est réalisée et, sur cette base, le produit est conçu, développé, testé et déployé en production. Les produits logiciels génériques sont également appelés produits COTS – commercial off-the-shelf products. Le système d'exploitation Windows est un très bon exemple de ce type de produit. Il est disponible à l'achat pour toute entité intéressée sous la même forme. Spyrosoft ne vend pas de tels produits. Nous créons des solutions logicielles sur mesure, des outils dédiés à un client particulier, uniques en fonction de ses exigences et de son contexte métier.
Couches logicielles
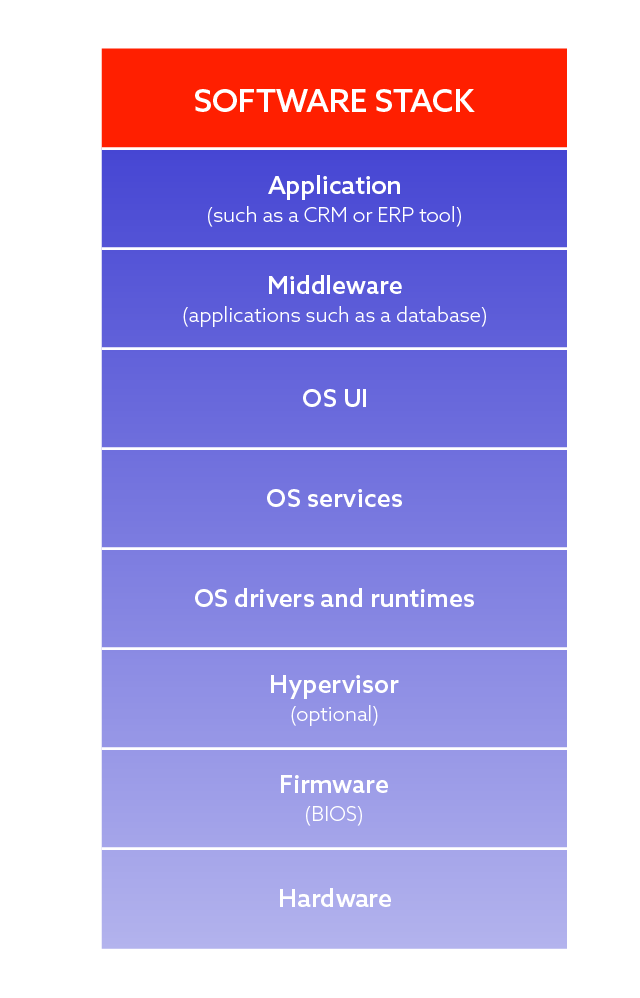
Le terme « logiciel » est vaste et il peut être bénéfique de le stratifier en plusieurs couches. Certaines de ces couches ne sont pas nécessairement pertinentes pour ce que nous faisons chez Spyrosoft, mais il est utile d'avoir une vision complète et de comprendre le contexte de chaque couche. Il existe huit couches :
Hardware
La couche la plus basse n'est pas à proprement parler un logiciel, mais chaque logiciel s'exécute sur un type de matériel donné, c'est pourquoi elle est incluse ici par souci d'exhaustivité. Chez Spyrosoft, nous ne fournissons pas de solutions matérielles, mais dans nos départements embarqués, nous traitons des logiciels de bas niveau fortement dépendants du matériel sous-jacent.
Micrologiciel (BIOS)
La couche logicielle la plus basse pouvant être fournie. Le firmware est essentiellement un logiciel qui contrôle le matériel sous-jacent. Les couches logicielles supérieures n'interagissent pas directement avec le matériel, mais s'appuient sur le firmware pour assurer cette interaction. Ainsi, le firmware fournit une couche d'abstraction et rend, dans une certaine mesure, les logiciels de niveau supérieur indépendants du matériel.
Hypervisor
Un hyperviseur est un outil essentiel pour gérer les processus de virtualisation – il s'agit d'un logiciel qui crée et exécute des machines virtuelles.
Le système d'exploitation
On peut le diviser en runtime et pilotes, services et enfin interface utilisateur. Tout le monde connaît les systèmes d'exploitation, tels que Windows, Linux ou Android, et leurs interfaces utilisateur graphiques. Nous sommes habitués à des interactions de haut niveau, par exemple nous cliquons sur une icône sur notre bureau et quelque chose se produit. En réalité, un simple clic de souris déclenche généralement de nombreux traitements dans divers logiciels. Imaginons que vous souhaitiez envoyer un message à votre ami en utilisant l'une des applications de messagerie populaires. Cela semble vraiment facile, n'est-ce pas ? Il suffit de saisir le message, d'appuyer sur ENTRÉE et d'attendre la réponse. Cependant, il se passe bien plus de choses en coulisses. Décomposons cela un peu :
- Tout d'abord, vous utilisez l'interface graphique (GUI) de votre système d'exploitation pour saisir le message dans une fenêtre de l'application choisie.
- Il existe nécessairement un service du système d'exploitation responsable de la communication réseau qui prépare réellement le message à transmettre sur internet. Il est également chargé de recevoir les messages entrants et de les traduire dans un format assimilable par les applications de niveau supérieur.
- Au final, le message doit être physiquement transmis sur un support, par exemple un câble, ou sans fil par voie hertzienne. C'est le rôle des couches logicielles les plus basses, comme les pilotes, de veiller à ce que le matériel effectue la transmission réelle des données.
Nous espérons que cela démontre clairement que des interactions apparemment simples peuvent déclencher une série massive d'événements et d'activités logiciels et que les systèmes d'exploitation sont des systèmes logiciels assez complexes.
Middleware
Le middleware est également appelé « colle logicielle ». Il fournit aux applications logicielles des services allant au-delà de ceux disponibles au niveau du système d'exploitation. Les services d'accès aux bases de données sont souvent qualifiés de middleware. Pour simplifier, vous pouvez considérer le middleware comme des applications sans interface graphique. Le middleware n'est pas un outil sur lequel on clique. Il fonctionne en arrière-plan. Vous pouvez communiquer avec lui, mais pas de la manière à laquelle vous êtes très probablement habitué – une souris et un écran tactile ne fonctionneront pas dans ce cas. Le middleware répond à un message envoyé dans un format particulier via un canal de communication défini, par exemple un port TCP/IP.
L'application
La dernière couche logicielle est la couche applicative. Les applications sont utilisées quotidiennement par la plupart d'entre nous. Un exemple parfait d'application est un navigateur web. D'autres exemples sont MS Teams, Outlook ou Excel.
Activités fondamentales d'ingénierie logicielle
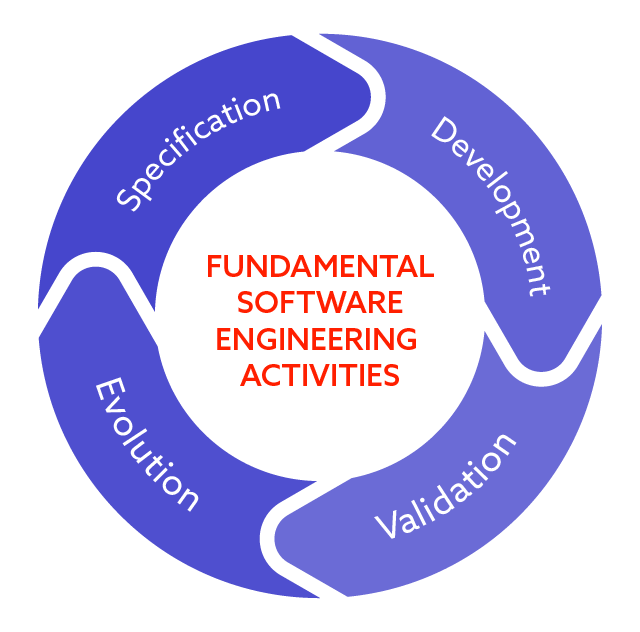
Maintenant que vous savez ce qu'est le logiciel, il est temps d'examiner de plus près les différentes activités réalisées par les ingénieurs logiciels. Ce n'est qu'un modèle parmi d'autres. Sa simplicité vous aidera, je l'espère, à mieux comprendre le processus de développement logiciel.
- Spécification : Un ingénieur logiciel a besoin d'une spécification pour commencer son travail. Généralement, la spécification est un type de documentation qui vous aide à comprendre ce que le logiciel est censé faire.
- Développement: Généralement, s'il est clair ce que le logiciel est censé faire, la phase de conception et de développement peut être lancée.
- ValidationÀ ce stade, le logiciel réel est vérifié par rapport à la spécification correspondante.
- Évolution: De nombreux logiciels disparaissent au fil du temps parce que les entreprises, les marchés, et donc les besoins des sociétés et les attentes des utilisateurs de logiciels évoluent. Il est donc nécessaire de faire évoluer régulièrement les logiciels développés. C'est un processus qui peut durer de très nombreuses années (vous souvenez-vous de la publication de la première version du système d'exploitation Windows ? En 1985, et il existe encore aujourd'hui)
Toutes les étapes présentées ci-dessus forment un cycle. Si quelque chose change, vous devez à nouveau recueillir les spécifications, reprendre le développement et valider le logiciel développé ou les modifications apportées ; ainsi, le logiciel évolue.
Ingénierie logicielle vs informatique
Il est également utile de connaître les différences entre l'ingénierie logicielle et l'informatique. Elles peuvent sembler similaires, mais elles sont en réalité assez différentes. L'informatique se concentre sur la théorie et les fondamentaux ; l'ingénierie logicielle s'intéresse aux aspects pratiques du développement et de la livraison de logiciels utiles. C'est là la différence. L'ingénierie logicielle est efficace et axée sur la fourniture de logiciels fonctionnels.
En d'autres termes, les entreprises/institutions (une grande partie étant réalisée par le monde académique) spécialisées en informatique mènent des recherches et cherchent de nouveaux algorithmes, méthodes et moyens d'optimiser les solutions et méthodes existantes. Spyrosoft, en tant qu'entreprise de développement, n'est pas, à proprement parler, une entreprise d'informatique fondamentale. Nous produisons des logiciels opérationnels.
Ingénierie système vs ingénierie logicielle
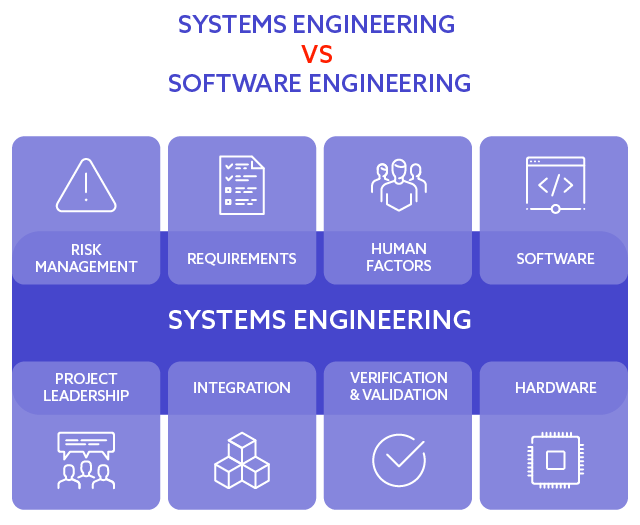
L'ingénierie logicielle ne se concentre pas uniquement sur le logiciel, mais aussi sur la vie quotidienne, car les entreprises ne tournent pas uniquement autour du logiciel. Des facteurs tels que le matériel, les pièces mécaniques, les matériaux, les aspects juridiques et de conformité, la prise de décision humaine, la gestion des risques et bien d'autres doivent être pris en compte lors de la gestion d'une entreprise. C'est pourquoi la notion de système peut être définie – un système, selon le dictionnaire Merriam-Webster, est un groupe d'éléments en interaction ou interdépendants qui agissent selon un ensemble de règles pour former un tout unifié. De toute évidence, le logiciel peut faire partie d'un système, et c'est d'ailleurs généralement le cas aujourd'hui. Ainsi, l'ingénierie logicielle peut être considérée comme une partie de l'ingénierie des systèmes.
Pour illustrer le concept et délimiter une frontière entre la partie logicielle et non logicielle du système, nous pouvons examiner deux exemples :
N° 1 – Une voiture moderne et son ABS (système antiblocage des roues)
Une structure simplifiée d'un tel système intègre :
- Unité de contrôle – un logiciel s'exécutant sur un matériel spécifique qui peut contrôler le fonctionnement de l'ensemble du système.
- Capteurs de roue – peuvent nécessiter un certain logiciel pour fonctionner mais sont, en général, des composants matériels.
- Vannes hydrauliques – composants mécaniques responsables du freinage effectif.
Il est clairement visible que le système est bien plus qu'un simple logiciel. Alors que l'ingénieur logiciel doit uniquement se concentrer sur l'unité de contrôle et s'assurer qu'elle est capable de recevoir, de traiter puis d'envoyer des signaux aux autres parties du système, l'ingénieur système doit se concentrer sur l'ensemble du fonctionnement et de la conception du système, et comprendre les interactions entre tous ses composants. En revanche, un ingénieur système n'a pas besoin de connaître toutes les subtilités de l'unité de contrôle.
N° 2 – Un système bancaire pour la gestion des prêts
N'étant pas expert bancaire, je peux imaginer que, par exemple :
- Les prêts d'un montant supérieur à une limite définie, par exemple 1 000 000 PLN, doivent être approuvés par un directeur régional – un facteur humain à prendre en compte.
- Pour certaines raisons juridiques ou de conformité, des documents spécifiques peuvent devoir être imprimés et conservés dans les archives – une activité de conformité à intégrer dans un système.
Et encore une fois, il est clair que ces préoccupations ne relèvent pas du logiciel mais peuvent être cruciales pour l'ensemble du processus métier et, par conséquent, pour la conception du système.
Chez Spyrosoft, nous nous concentrons sur la conception et le développement de logiciels, mais cela ne peut se faire sans le contexte du système dans son ensemble. Nous disposons d'une équipe d'ingénieurs systèmes qualifiés et d'analystes métier qui aident nos clients à concevoir leurs systèmes et à faire correspondre les processus métier aux logiciels.
Architecture générique d'un système logiciel
Pour comprendre le fonctionnement des systèmes logiciels de nos jours, il est utile de jeter un coup d'œil aux architectures typiques des systèmes logiciels modernes. Cette fois, ne nous attardons pas sur les définitions formelles mais concentrons-nous plutôt sur les aspects pratiques.
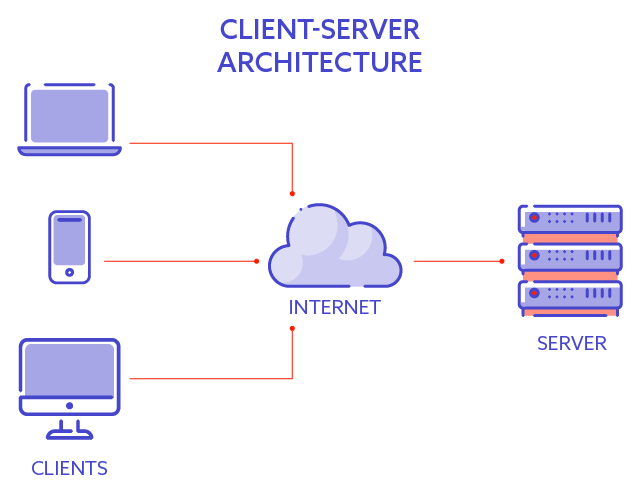
L'architecture système la plus simple d'un système logiciel moderne est l'architecture client-serveur. Elle comporte deux éléments essentiels :
- The client – non pas la personne qui utilise l'ordinateur, mais une application exécutée sur cet ordinateur
- The server – non pas le serveur physique, mais l'application exécutée sur le serveur qui est capable de traiter les requêtes provenant du client.
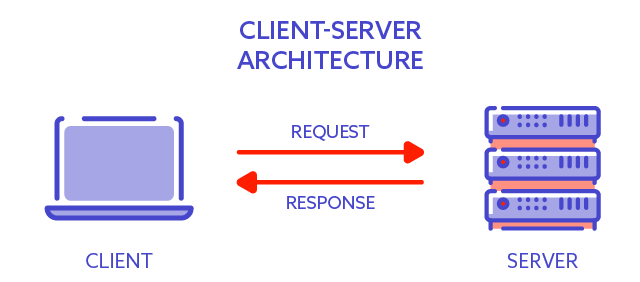
Illustrons cela par un exemple concret, tel qu'un système bancaire. Lorsqu'un client de la banque – l'utilisateur de notre système – souhaite effectuer un virement, il ouvre la page web de la banque et se connecte au système. Ensuite, à l'aide des contrôles présents sur la page web, l'utilisateur peut fournir toutes les données nécessaires à un virement. Une telle requête est envoyée au serveur bancaire, qui exécute le virement. Le serveur renvoie la réponse pour informer l'utilisateur du succès ou non de l'opération.
Ainsi, le client, dans ce cas, est le navigateur web sur l'ordinateur portable ou de bureau de l'utilisateur. Le serveur est l'application exécutée sur le serveur détenu ou loué par la banque. L'utilisateur n'a pas besoin de connaître l'emplacement physique du serveur tant qu'il connaît l'adresse du système bancaire (URL – uniform resource locator). Le navigateur web sait où envoyer la requête en fonction de l'URL, puis le serveur renvoie les résultats. Dans cet exemple, le serveur est généralement placé dans une salle serveur sécurisée.
De toute évidence, les utilisateurs ne transportent pas toujours leur ordinateur portable de nos jours. Un smartphone ou une tablette est généralement plus pratique. Le client de l'exemple ci-dessus pourrait également être une application bancaire exécutée sur un appareil mobile. L'appareil utilisé par l'utilisateur ne devrait pas avoir d'importance tant que l'application peut communiquer avec le serveur.
Architecture à trois niveaux
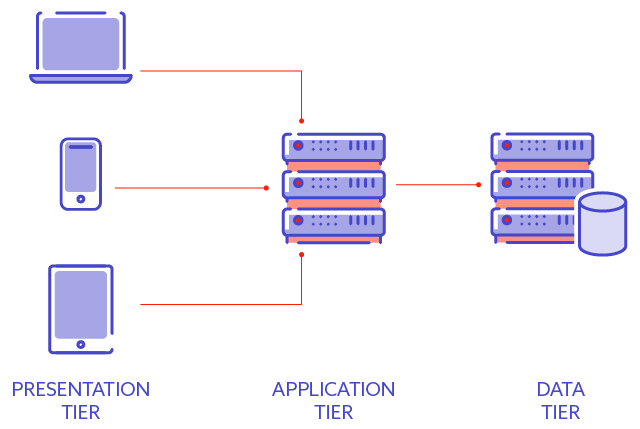
Si tout vous a semblé très simple jusqu'à présent, compliquons davantage la question. La conception du système est relativement simple lorsqu'elle se limite au client et au serveur. Cependant, vous pouvez introduire un autre composant et, au lieu de deux niveaux, il y en aura trois – nous obtenons ainsi une architecture à trois niveaux.
La couche supplémentaire, absente de l'exemple précédent, est la couche de données. Vous imaginez facilement que la plupart des entreprises traitent des tonnes de données de nos jours, il est donc raisonnable de disposer d'une partie dédiée du système responsable du traitement et du stockage des données.
Ainsi, les trois niveaux peuvent être brièvement décrits comme suit :
- Couche de présentation – partie du système destinée à l'utilisateur, qui permet à un utilisateur, par exemple, de saisir les données et de recevoir une communication de la couche applicative.
- Couche applicative – élément de logique métier, qui possède des fonctionnalités spécifiques au métier et effectue généralement la majeure partie du traitement.
- Niveau de données – responsable du traitement et du stockage des données.
Imaginons à nouveau un système bancaire. La plupart des banques traitent des pétaoctets de données. Dans un tel environnement, les processus liés aux données s'exécutent sur un serveur dédié et sont gérés par un logiciel dédié – un logiciel de base de données. Dans les exemples précédents, nous avons supposé que le serveur contenait déjà une base de données « en interne ». Mais dans ce cas, la base de données sera placée ailleurs, par exemple sur un autre serveur. Ainsi, la couche applicative – un serveur de logique métier, lors du traitement de la requête, enverra une demande pour obtenir ou stocker des données à la couche de données – le serveur de base de données. Et là encore, ces deux serveurs peuvent se trouver dans deux emplacements physiques différents. Qui plus est, l'utilisateur n'est même pas conscient qu'il y a deux serveurs en dessous ; il interagit toujours avec le système bancaire via un navigateur web ou une application bancaire.
Sans serveur (cloud)
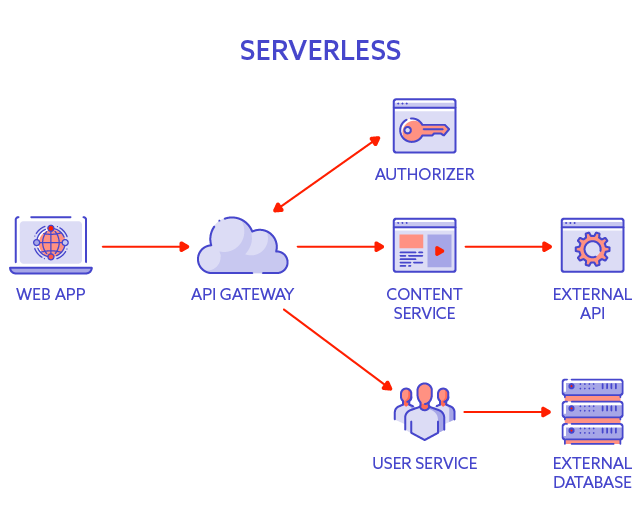
Est-il possible d'avoir un système moderne sans serveur ? Une architecture serverless ?
Dans une certaine mesure, oui – le cloud est le maître mot !
Mais qu'est-ce que le cloud ? Pour nos besoins, nous allons définir le cloud comme la puissance de calcul et la capacité de stockage pouvant être louées pour une période et un objectif donnés.
Ce qui est essentiel avec le cloud, c'est que ni l'utilisateur ni le propriétaire du logiciel n'a besoin de savoir où le ou les serveurs sont physiquement situés. Par exemple, lorsque nous avons analysé le système bancaire, vous avez probablement remarqué que l'utilisateur se connecte au serveur de la banque et n'a pas besoin de savoir où se trouve ce serveur. Cependant, la banque, elle, a besoin de le savoir. Avec le cloud, la banque n'a pas besoin de le savoir non plus ! Il se trouve quelque part dans le cloud et le fournisseur cloud doit s'assurer que les ressources informatiques sont disponibles pour la banque, mais leur emplacement physique est secondaire.
Les clouds modernes offrent non seulement de la puissance de calcul et des capacités de stockage, mais aussi d'autres services, par exemple un service d'autorisation ou un service de base de données, afin de rendre le développement et le déploiement d'applications dans le cloud plus faciles et plus rapides.
Flexibilité et évolutivité avec un modèle cloud
Les clients du cloud doivent veiller à disposer du bon niveau de puissance de calcul et de capacité de stockage, mais cela n'est pas figé – cela peut évoluer avec le temps. Dans une architecture client-serveur, si une banque compte actuellement 1 million de clients et un seul serveur, elle pourrait constater que lorsque le nombre de clients atteint 2 millions, il sera nécessaire de disposer de serveurs supplémentaires pour traiter toutes les requêtes.
L'achat et le déploiement d'un nouveau serveur physique peuvent être un processus assez long. Cependant, l'augmentation des ressources dans le cloud sera probablement bien plus simple – il suffit de commander davantage de puissance de calcul, et c'est tout – elle est à votre disposition en quelques minutes. Le processus de mise à l'échelle peut nécessiter des modifications supplémentaires de votre logiciel, mais cela concerne les architectures serverless et client-serveur. Plus intéressant encore, la banque peut louer la puissance de calcul pour une durée définie, par exemple un trimestre si elle le souhaite.
Et si vous n'avez besoin que d'un peu de puissance de calcul la nuit en raison de l'activité fluctuante de vos utilisateurs sur une période de vingt-quatre heures ? Avec le cloud, vous ne payez que ce que vous utilisez. Le cloud vous offre de la flexibilité. Cela fait du cloud un excellent moyen de réduire les coûts et d'obtenir une évolutivité à la demande.
Si vous avez des dizaines de milliers d'utilisateurs quotidiens mais seulement quelques centaines la nuit, vous pouvez gérer vos ressources en conséquence et vous ne payez finalement que la puissance de calcul que vous utilisez réellement. La ressource que vous ne consommez pas pendant la nuit sera transférée ailleurs et consommée par quelqu'un qui la paiera à ce moment-là. Il s'agit donc d'une situation gagnant-gagnant pour le client et le fournisseur de cloud, qui conduit à une utilisation optimale des ressources.
Stabilité
Lorsqu'un serveur tombe en panne pour une raison quelconque, l'ensemble du système est hors service et les utilisateurs ne peuvent pas l'utiliser tant que la défaillance n'est pas éliminée. Avec le cloud, vous n'avez plus à vous en soucier. Chaque fournisseur de cloud dispose d'un mécanisme unique conçu pour vous fournir rapidement un autre serveur, de sorte que votre système ne soit indisponible qu'une minute ou deux. C'est une raison supplémentaire pour laquelle tant d'entreprises ont décidé de migrer vers le cloud.
Payez uniquement ce dont vous avez besoin
Les tarifs du cloud sont flexibles. Les grandes entités peuvent négocier des tarifs individuels pour obtenir un rapport coût-efficacité encore meilleur. Il convient également de rappeler que vous pouvez définir des limites de paiement en tant que client. Par exemple, vous pouvez déterminer que vous ne paierez qu'un certain montant par mois. Attention, toutefois – une fois la limite atteinte, vous avez également épuisé les ressources, votre système n'est donc plus opérationnel. De manière générale, le cloud vous offre un meilleur contrôle sur vos coûts.
PS. Si vous souhaitez démarrer ou développer votre carrière en tant qu'ingénieur logiciel, nous vous invitons à consulter notre section carrière. Nous sommes toujours ravis d'entrer en contact avec des candidats prometteurs !


arrow_circle_rightContactez-nous
Nous vous aiderons à choisir la technologie la mieux adaptée à votre solution
Marcin Zyga
Chief AI & Information Officer
arrow_circle_right Nos articles


