Les voicebots IA dans le secteur bancaire polonais (partie 1)


Dans le paysage en évolution rapide de la banque numérique, l'importance de services de parole publique efficaces ne saurait être surestimée. Ces services jouent un rôle crucial dans l'amélioration de l'expérience client, en particulier dans le contexte du secteur bancaire polonais, où l'interaction et la communication avec les clients sont primordiales. Avec les avancées de l'intelligence artificielle et du traitement du langage naturel, les capacités des services de parole publique ont connu une transformation remarquable, offrant des moyens plus intuitifs et efficaces d'interagir avec les clients.
Le marché des voicebots dans le secteur financier polonais connaît une croissance dynamique. Les clients sont désormais habitués à parler à des assistants virtuels et à leur poser des questions courantes, par exemple sur le statut du compte. Par exemple, PKO, l'une des plus anciennes banques polonaises, utilise des assistants virtuels depuis plus de trois ans. En fait, selon leur communiqué de presse, ils disposent de pas moins de 18 assistants virtuels différents et, depuis août 2023, leurs voicebots à eux seuls ont déjà mené plus de 25 millions de conversations avec plus de 9 millions de clients. Impressionnant, n'est-ce pas ?
Avec la croissance rapide deAI, il est judicieux d'examiner comment les technologies liées à l'IA peuvent être mises en œuvre dans les banques et autres institutions financières. C'est le thème principal de cette étude et de cet article, co-préparés par Kamil Machalica, Senior AI Data Scientist, et Szymon Rożdzyński, DevOps Software Engineer.
Engageons-nous dans une exploration détaillée de divers services publics de reconnaissance vocale, en nous concentrant particulièrement sur leur application dans le secteur bancaire polonais. Afin de refléter fidèlement les besoins de nos clients, similaires à ceux rencontrés dans les environnements de centres de contact, ces technologies seront testées avec des phrases adaptées aux scénarios bancaires.
Ces échantillons seront ensuite enrichis avec différents niveaux de bruit, créant une réplique authentique de l'environnement sonore typique des conversations téléphoniques avec de vrais clients. Notre méthodologie est conçue pour offrir une évaluation réaliste des capacités de chaque service, reflétant la nature complexe et exigeante des interactions clients dans les centres de contact bancaires.
Mais avant d'y parvenir, plusieurs défis possibles doivent être discutés.
Défis liés aux voicebots IA dans le secteur bancaire polonais
Alors que nous nous lançons dans l'intégration de services de parole publics dans le secteur bancaire polonais, nous rencontrons une série de défis. Ces obstacles sont essentiels pour le développement de technologies de la parole efficaces et efficientes, adaptées aux besoins des clients polonais. Nous présentons ici quelques défis clés :
Prise en charge limitée de la langue polonaise
Un défi majeur réside dans le support limité de la langue polonaise par les principaux services publics de reconnaissance vocale. Par exemple, AWS Lex, un service de reconnaissance vocale réputé, ne prend pas en charge le polonais. Cela nécessite d'explorer des solutions alternatives ou de développer des modèles personnalisés adaptés à la grammaire complexe et aux nuances de prononciation du polonais.
Ressources de recherche limitées
En raison de la rareté des études externes et des benchmarks sur les applications spécifiques au secteur bancaire polonais, la plupart des recherches dans ce domaine sont menées en interne. Cela signifie que les institutions partent souvent de zéro, investissant un temps et des ressources considérables dans des recherches primaires pour comprendre les capacités et les limites des technologies vocales existantes pour la langue polonaise et les exigences bancaires. Les services de cloud public subissent des changements importants, ce qui rend les recherches souvent obsolètes.
Contraintes de temps et limites de données dans la recherche
Un autre défi important est la contrainte de temps, la recherche n'étant pas l'objectif principal du projet. Le projet a dû composer avec cette limitation, ce qui a conduit à un ensemble de données qui, sans être exhaustif, était suffisant pour les besoins immédiats du projet. Toutefois, pour obtenir des informations plus complètes et une meilleure précision, la recherche bénéficierait d'un plus grand nombre d'exemples vocaux et d'annotateurs supplémentaires, au-delà des deux impliqués. Cela améliorerait l'apprentissage et les performances du système, en particulier dans un environnement orienté client.
Métriques de comparaison – STT et TTS
L'évaluation des services de parole publics comporte deux volets : la reconnaissance vocale (STT) et la synthèse vocale (TTS). La STT consiste à transcrire avec précision la parole polonaise en texte, ce qui est essentiel pour comprendre les demandes des clients. L'évaluation de la TTS consiste à convertir le polonais écrit en paroles prononcées de manière naturelle et précise, ce qui est essentiel pour des réponses claires et compréhensibles aux clients.
Dans les sections suivantes, nous examinerons chaque défi en détail, en discutant de leur impact sur le déploiement de services vocaux publics dans le secteur bancaire polonais et des stratégies potentielles pour y répondre.
Reconnaissance vocale
Une technologie connue sous le nom deSTT – Reconnaissance vocale, également connue sous le nom de reconnaissance automatique de la parole (ASR), convertit le langage parlé en texte écrit. Elle est particulièrement utile dans les applications où la parole doit être convertie en une forme que les ordinateurs et les algorithmes intelligents peuvent traiter. Par exemple, les assistants virtuels de support client.
Une expérience a été conçue pour tester les capacités de reconnaissance vocale (STT) afin d'évaluer les services de parole publics dans le domaine bancaire polonais. Dans le cadre de l'expérience, plusieurs aspects clés ont été mesurés pour déterminer l'efficacité et l'efficience des différentes solutions.
Vous trouverez ci-dessous un aperçu détaillé de la configuration de l'expérience et de ce qui a été mesuré.
Ensembles de données
- Phrases bancaires polonaises enregistrées : Au total, 52 phrases spécifiques aux scénarios bancaires ont été enregistrées. Ces phrases comprenaient des exemples tels que “Le consultant peut-il m'aider à configurer mes nouveaux objectifs d'épargne dans l'application bancaire ?“ (Ang. Un consultant peut-il m'aider à définir mes nouveaux objectifs d'épargne dans l'application bancaire ?).
- Conversations longues : En plus des phrases, 3 conversations étendues entre un consultant et un client ont été enregistrées. Ces dialogues simulaient des interactions bancaires réelles, capturant la complexité et la variété des scénarios de service client dans le secteur bancaire.
- Niveaux de bruit appliqués : Après l'enregistrement, ces échantillons audio ont été soumis à sept niveaux différents de bruit blanc, avec des valeurs de rapport signal sur bruit (SNR) allant de -20 à 10. Cela a été fait pour tester la robustesse des solutions STT dans diverses conditions auditives susceptibles d'être rencontrées dans des environnements réels.
Indicateurs d'évaluation
Pour notre évaluation, nous avons privilégié la simplicité et la clarté dans le choix des métriques, compte tenu des contraintes de temps et de ressources de recherche. Nous nous sommes concentrés sur deux métriques simples mais révélatrices pour évaluer les solutions :
Taux d'erreur de mots (WER)
La principale métrique pour évaluer la précision des solutions STT était le WER pour les échantillons audio sans aucun bruit ajouté. Cette métrique a fourni une référence pour la performance dans le meilleur des cas. Le WER est une métrique clé utilisée pour évaluer la précision des systèmes de reconnaissance vocale.
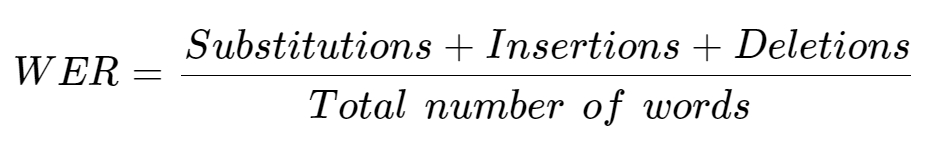
Il est calculé comme le nombre d'erreurs (qui incluent les substitutions, les suppressions et les insertions de mots) divisé par le nombre total de mots prononcés, quantifiant essentiellement la fréquence à laquelle le système comprend mal ou manque des mots. Cette mesure aide à comparer l'efficacité de différentes solutions de synthèse vocale, notamment pour comprendre leur fiabilité à transcrire avec précision la langue parlée.
Temps d'exécution
Le temps nécessaire à la transcription a été mesuré dans chacun des environnements cloud (OpenAI Whisper hébergé sur GCP, Azure et AWS) afin d'éviter les biais liés au traitement sur site. Cette métrique a permis d'évaluer l'efficacité de chaque solution.
Solutions testées
Dans notre démarche visant à identifier les services de synthèse vocale publics les plus efficaces pour le secteur bancaire polonais, nous avons testé plusieurs solutions de premier plan. Nos critères de sélection reposaient sur la popularité sur le marché, les capacités de prise en charge linguistique et les configurations d'hébergement, garantissant ainsi une évaluation diversifiée et complète.
Google Cloud Platform (GCP) et Microsoft Azure : Ces solutions ont été sélectionnées car elles sont les plus populaires sur le marché et étaient disponibles dans la passerelle vocale. Leur utilisation répandue et leur réputation dans le secteur en ont fait des candidats de premier choix pour l'évaluation.
OpenAI Whisper hébergé sur AWS : sélectionné pour sa prise en charge de la langue polonaise et en tant que solution auto-hébergée, offrant un contraste avec les options serverless de GCP et Azure. Cette inclusion a permis une comparaison complète entre les solutions serverless et auto-hébergées en termes de performances, d'évolutivité et de considérations opérationnelles.
Résultats
L'expérience visait à capturer une image complète de la performance de chaque service STT selon diverses dimensions :
Précision dans différentes conditions auditives : en appliquant différents niveaux de bruit, l'expérience a évalué la capacité de chaque service à gérer les variations de qualité audio.
Performance dans des scénarios bancaires réalistes : l'utilisation de phrases bancaires réelles et de conversations étendues a fourni un banc d'essai réaliste pour chaque service STT.
Cette configuration a permis une compréhension détaillée des forces et des limites de chaque service dans une application bancaire réelle, guidant la prise de décision dans la sélection et la mise en œuvre des technologies STT.
Précision dans différentes conditions auditives
Avant de tester différents niveaux de bruit présents dans les scénarios réels, nous avons évalué une performance de référence de transcription vocale avec des échantillons initiaux non affectés par un bruit blanc artificiel. Dans l'évaluation des capacités de transcription vocale de différents moteurs pour le secteur bancaire polonais, notre analyse s'est concentrée sur un ensemble de données composé de 52 phrases et 3 conversations, reflétant le discours typique rencontré dans le service client.
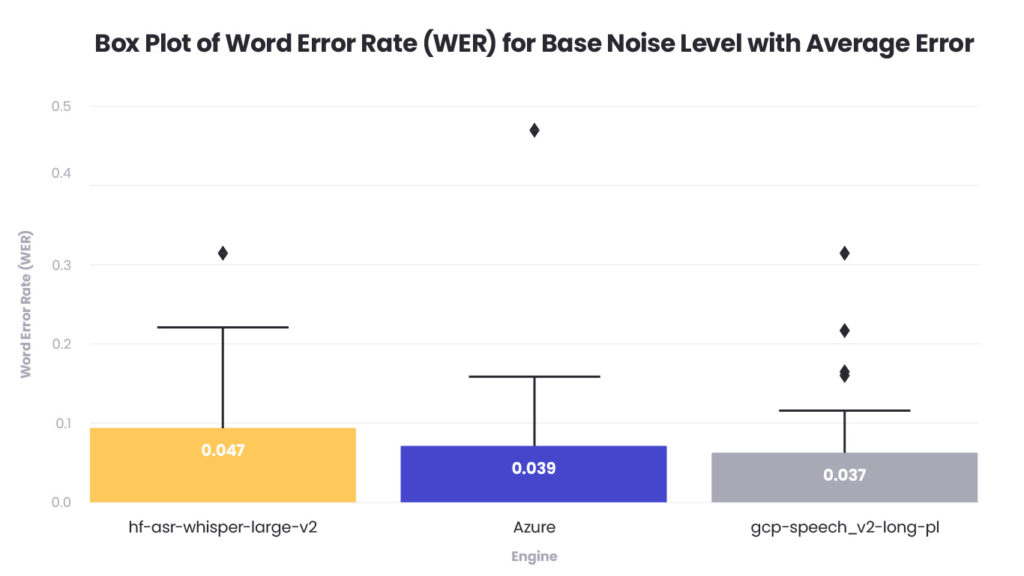
Les données visuelles présentées dans le graphique en boîte à moustaches ci-joint illustrent le taux d'erreur de mot (WER) pour trois moteurs de reconnaissance vocale sélectionnés. Le premier moteur, (AWS) hfasr-whisper-large-v2, est indiqué en orange et révèle un WER moyen de 0,047, avec une plage suggérant une précision variable. En revanche, Azure affiché en bleu et (GCP) gcp-speech-v2-long-pl affichés en gris, présentent une cohérence plus étroite dans les résultats avec un WER moyen de 0,039 et 0,037 respectivement.
Analyse du taux d'erreur de mots selon la durée des fichiers audio
Dans le cadre de notre recherche interne, soumise à des contraintes de ressources et de temps, visant à évaluer les services de reconnaissance vocale publics dans le domaine bancaire polonais, nous avons accordé une attention particulière au taux d'erreur de mot (WER) en relation avec la longueur des échantillons audio. Cette composante de notre étude est essentielle pour évaluer la manière dont les différents services de transcription vocale traitent des entrées audio de durées variables, ce qui est courant dans les interactions de service client.
Approche de recherche et contraintes
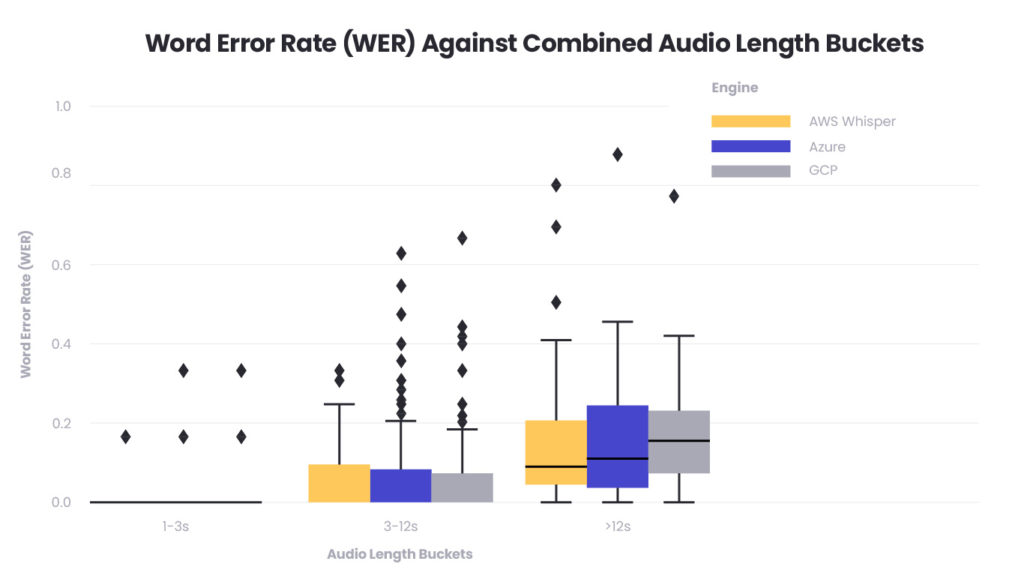
L'étude consistait à catégoriser des phrases et conversations bancaires enregistrées en trois catégories de durée audio : courte (1-3 secondes), moyenne (3-12 secondes) et longue (plus de 12 secondes). Malgré les limites en termes d'étendue et de profondeur des données en raison de contraintes de temps et de ressources, cette catégorisation a permis une évaluation ciblée des performances de chaque moteur de reconnaissance vocale.
Interprétation et implications
Le graphique offre une visualisation de la répartition du WER selon les différentes durées audio pour chaque service. Notamment, tous les services obtiennent des résultats relativement bons avec des clips audio courts. Cependant, on observe une augmentation perceptible du WER pour les entrées audio plus longues. Une possibilité est que les entrées audio plus longues contiennent naturellement plus d'informations et donc plus de points d'erreur potentiels, y compris des structures de phrases complexes. De plus, les conversations plus longues peuvent présenter un vocabulaire et une syntaxe plus variés, ce qui peut mettre à l'épreuve les limites des modèles entraînés, en particulier si les données d'entraînement ne couvraient pas suffisamment une telle diversité.
Impact du bruit blanc sur la précision de la reconnaissance vocale
Dans la phase suivante de notre étude interne, nous avons introduit un bruit blanc dans nos enregistrements audio de référence afin de simuler un environnement auditif plus réaliste et plus exigeant. Cette étape a été cruciale pour déterminer la robustesse des services de reconnaissance vocale face à différents degrés de bruit de fond, un problème courant dans les conversations téléphoniques réelles au sein du secteur bancaire. Le rapport signal sur bruit (SNR) a été utilisé comme mesure de ces défis, les valeurs de SNR négatives indiquant des scénarios où le bruit submerge la parole, et les valeurs positives représentant des conditions de parole plus claires.
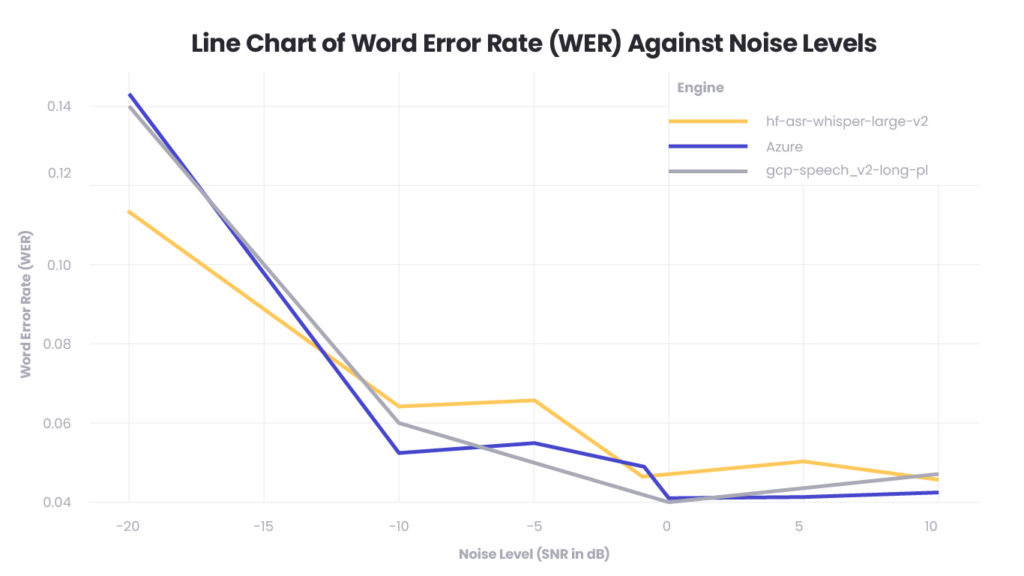
Le graphique linéaire présenté montre le taux d'erreur de mots (WER) de chaque moteur de reconnaissance vocale en fonction de différents niveaux de bruit, mesurés par le rapport signal sur bruit (SNR) en décibels. Les moteurs testés, notamment AWS Whisper, Azure et le service de reconnaissance vocale de GCP, montrent comment leurs performances se dégradent à mesure que le bruit augmente, ce qui est attendu étant donné que le bruit peut obscurcir la clarté de la parole.
Conclusions
La présence de bruit blanc augmente généralement le WER pour tous les services, l'impact le plus significatif se produisant à des niveaux de bruit plus élevés (valeurs SNR plus faibles). À mesure que le niveau de bruit diminue (valeurs SNR plus élevées), les services commencent à retrouver leur précision, ce qui suggère qu'ils possèdent une certaine capacité à distinguer la parole du bruit de fond jusqu'à un certain seuil.
Dans la comparaison des services de synthèse vocale dans des conditions de bruit variables, les résultats dressent un tableau nuancé. AWS Whisper a affiché la performance la plus robuste dans les scénarios de bruit extrême, en particulier à un SNR de -20 dB, ce qui suggère un haut degré de résilience dans des environnements à très mauvaise qualité audio. Cependant, à mesure que le SNR augmentait vers des niveaux plus représentatifs des conversations téléphoniques bruyantes typiques, AWS et GCP se sont tous deux imposés comme des concurrents solides, affichant une précision améliorée dans la transcription de la parole.
Il est difficile de conclure de manière décisive lequel de ces deux services — AWS ou GCP — offre des performances supérieures sur la base de la taille limitée de l'échantillon de notre étude. Les deux services ont démontré des capacités notables dans la gestion du bruit de fond, et les différences de performance entre eux étaient marginales. Cela suggère que pour les environnements présentant un niveau de bruit modéré, tels que ceux attendus dans les opérations de centres d'appels, AWS et GCP offrent tous deux des solutions de synthèse vocale viables, le choix dépendant probablement d'autres facteurs tels que les capacités d'intégration, le coût et les préférences des utilisateurs.
Il est pertinent de comprendre que les décibels sont une unité de mesure relative, en particulier lorsqu'on discute du rapport signal sur bruit (SNR). Le SNR peut varier considérablement en fonction du niveau de puissance du signal d'entrée ; un signal de puissance plus élevée, même avec la même quantité de bruit, donnerait une valeur de SNR plus élevée. Cette variabilité souligne la complexité de l'évaluation précise des performances de la reconnaissance vocale dans différentes conditions réelles.
Résumé
Nos recherches sur l'impact du bruit sur les services de reconnaissance vocale indiquent un domaine propice à un développement plus poussé, notamment en ce qui concerne la normalisation des niveaux de signal d'entrée afin d'obtenir des mesures de SNR plus uniformes. Pour la portée et les exigences de ce projet, le niveau d'analyse actuel a fourni des informations suffisantes.
Néanmoins, une approche plus nuancée du SNR pourrait améliorer la précision prédictive de la performance de ces services dans les environnements acoustiques variés des opérations de service client du secteur bancaire.
Dans la deuxième partie de cet article, nous vous présenterons une autre technologie qui joue un rôle crucial dans le développement des voicebots (et pas seulement dans le secteur bancaire) – la TTS – Text-to-Speech. C'est une technologie qui convertit le texte écrit en parole.


arrow_circle_right Autres articles
Choisissez votre prochaine lecture



arrow_circle_rightContact
