Edge AI dans l'agriculture : concevoir des systèmes qui fonctionnent sans connectivité


Rural connectivity has improved, but it is still too inconsistent to support cloud-dependent agricultural software as the default operating model. In practice, field operations, machinery workflows, sensor systems, and time-critical alerts must continue to work during network loss, weak signal, or high-latency conditions.
C'est pourquoi l'IA en périphérie dans l'agriculture n'est pas une simple mise à niveau de fonctionnalité. C'est une exigence de conception de systèmes qui apporte une contribution tangible entransformer l'agriculture et les pratiques agricoles durables. Teams building precision agriculture platforms, connected machinery, and agronomic decision tools need offline-first architectures, local inference, resilient synchronisation, and deterministic fallbacks if they want their software to perform under real-world farm conditions.
Pourquoi l'approche offline-first est-elle importante dans l'agriculture durable ?
Agriculture is not a regular software environment. Fields are large, weather conditions are changeable, assets are mobile, infrastructure is uneven, and many workflows happen outside stable network coverage. Even in places where 5G rollout has progressed, rural quality still lags urban quality. Dans les pays de l'OCDE, à la fin de 2024, les utilisateurs des villes bénéficiaient de débits de téléchargement mobiles supérieurs de 37,2 % à ceux des utilisateurs des zones rurales, et la vitesse moyenne de téléchargement en 5G était de 222,6 Mbps dans les villes contre 173,5 Mbps dans les zones rurales.
The gap is not only about average speed. It is also about consistency, latency, signal dropouts, roaming behaviour, and the operational reality in which many farming operations and tasks happen at the edge of coverage, inside steel machinery cabins, in orchards, in remote plots, or across mixed topography. L'évaluation 2024 de la couverture haut débit par la Commission européenne suit explicitement la disponibilité en zones rurales séparément, car la qualité de la couverture et le déploiement restent inégaux selon la géographie.
FAO has also highlighted a broader structural issue: digital exclusion in rural areas grows as services are digitalised and offline alternatives are removed. That principle applies directly to agricultural software and digital technologies. If a spray log, disease alert, irrigation rule, or machine instruction only works online, then the system has been designed against smart farming rather than with it in mind.
Quels problèmes l'edge computing résout-il pour l'agriculture de précision ?
Edge computing addresses one of the most persistent constraints in agricultural digital technologies and systems: the gap between how software is designed in connected environments and how it must actually perform in the field, where latency, limited bandwidth, and unstable connectivity are part of everyday operations.
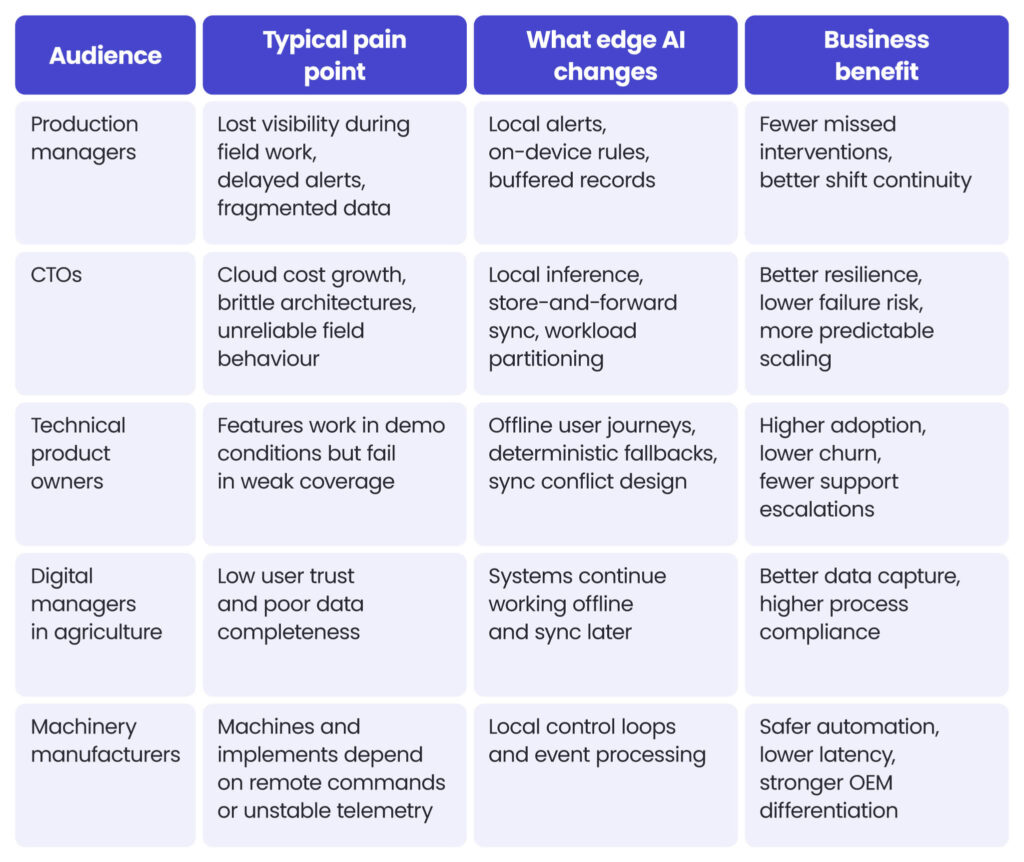
Pourquoi est-ce important sur le plan commercial en ce qui concerne la transformation de l'agriculture ?
For software buyers in the agricultural sector, reliability is often valued above algorithmic sophistication. A model with slightly lower laboratory accuracy but strong local execution, good fallback logic, and robust synchronisation can create more operational value than a more complex cloud-dependent system. That trade-off is consistent with current edge computing research in agriculture, which emphasises latency reduction, bandwidth efficiency, and distributed decision-making close to machinery, sensors, and crops.
Découvrez pourquoi le logiciel peut constituer un goulot d'étranglement pour l'agriculture autonome et comment y remédier
En savoir plus
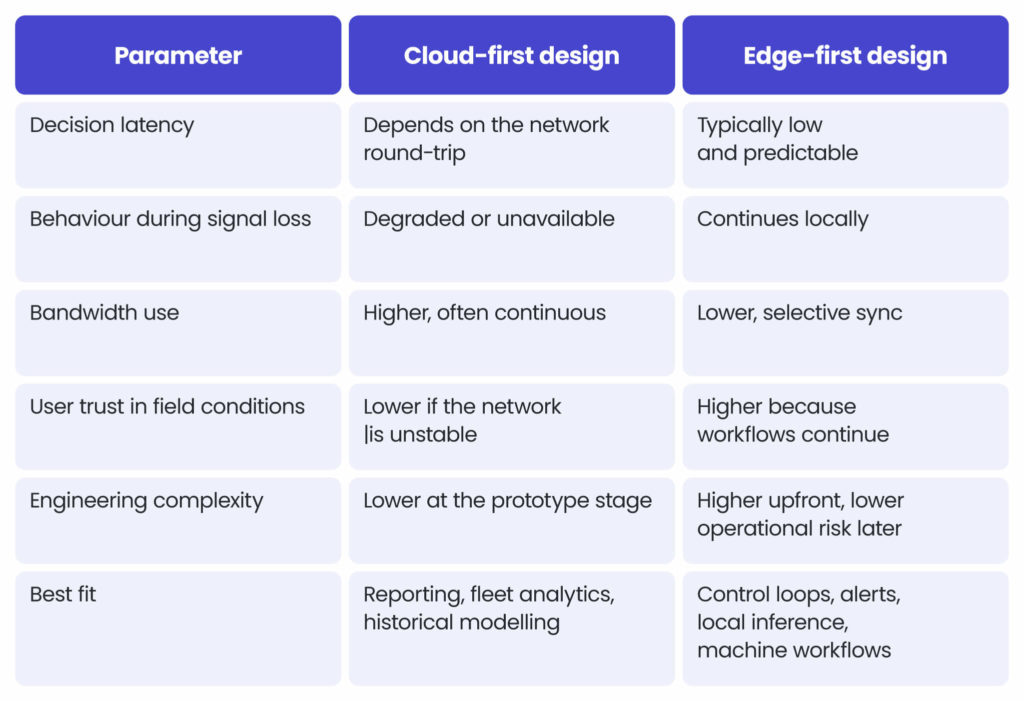
Approche cloud-first vs edge-first dans les systèmes agricoles
Cloud platforms in smart farming still matter. It is the right place for fleet-wide reporting, model retraining, cross-farm benchmarking, traceability, planning, and long-term analytics. The mistake is assuming it should sit on the critical path of every field decision.
Comparaison des choix d'architecture
The comparison below provides a simple way to understand how cloud-first and edge-first architectures differ in day-to-day operations, particularly in environments where connectivity, response time, and system continuity have a direct impact on performance in the field.
Où le cloud doit rester central dans l'agriculture intelligente
Cloud infrastructure remains essential in agricultural systems, but its main role is not to play a critical part in every operational decision. Its real value lies in scale, coordination, governance, and the ability to combine data across machines, users, farms, and seasons. Wherever the task depends on a broad system view, shared standards, long-term storage, or central control, the cloud should remain the primary layer.
Le cloud reste le bon environnement pour :
- entraînement des modèles et gouvernance des versions,
- normalisation des données à l'échelle de la flotte,
- reporting réglementaire,
- intégration ERP, CRM et chaîne d'approvisionnement,
- analyse des tendances historiques et traitement des données sur l'ensemble des saisons et des exploitations.
Là où l'IA et l'informatique en périphérie devraient être la norme
Edge computing should be the default for functions that must work in real time, close to the machine, sensor, or operator, and without assuming stable connectivity. In modern agriculture and farming operations and environments, many of the most important workflows happen in the field, under weak signal, variable latency, or complete network loss. Wherever the task depends on immediacy, local context, operational continuity, and resilience, the edge should own the execution.
L'Edge doit prendre en charge :
- ingestion et filtrage des données des capteurs,
- détection d'événements,
- recommandations locales et alarmes,
- aide à la décision côté machine,
- logique de repli d'urgence,
- flux de travail des opérateurs hors ligne,
- mise en mémoire tampon et transmission en mode store-and-forward.
Les principes d'ingénierie derrière une IA en périphérie robuste dans l'agriculture
Rapprocher la logique de décision de l'événement
If a frost alarm depends on a round trip to the cloud, it is already too late in many scenarios. Local thresholding, local feature extraction, and local inference reduce risk. Recent research in agricultural edge systems repeatedly frames this as a practical response to bandwidth constraints, lower response efficiency, and resource-sensitive deployment environments.
Concevez pour la synchronisation, pas pour une connectivité permanente
Le bon modèle mental n'est pas celui d'« un appareil connecté », mais celui d'« un nœud local autonome qui se synchronise lorsque cela est possible ». Cela modifie la manière dont les équipes conçoivent les files de messages, les horodatages, la logique de nouvelle tentative, l'idempotence, la résolution des conflits et les pistes d'audit.
Séparer le temps réel strict du temps réel souple
Une règle de sécurité machine ou d'actionnement ne peut pas attendre le même pipeline que celui qui met à jour un tableau de bord. Les équipes ont besoin de classes de décisions explicites :
- décisions locales immédiates,
- décisions locales avec confirmation ultérieure dans le cloud,
- décisions cloud poussées de manière asynchrone,
- analyses historiques uniquement.
Optimiser les modèles pour le déploiement, pas seulement pour la précision des benchmarks
Agricultural edge AI often succeeds with smaller models, compressed models, quantised inference, or hybrid rule-plus-model pipelines. A recent 2025 smart agriculture framework showed that lightweight edge-optimised models can achieve 88% weather classification accuracy and 93% crop classification accuracy on resource-constrained hardware, while still supporting real-time local actuation logic.
Traitez le stockage local comme un composant système à part entière
Les systèmes offline-first ont besoin d'un stockage local durable, et non d'un cache temporaire utilisé comme une réflexion après coup. Cela inclut :
- journaux d'événements locaux,
- actions des opérateurs,
- tampons de télémétrie,
- versions de modèle,
- instantanés de configuration,
- état de synchronisation et métadonnées d'audit.
Comment concevoir un flux de travail agricole axé sur le hors ligne
Voici une séquence de mise en œuvre pratique pour les équipes produit et ingénierie souhaitant construire des systèmes d'agriculture de précision fiables.
Étape 1. Identifier les décisions qui doivent survivre à une perte de réseau
Listez tous les workflows et indiquez ceux qui échouent si le cloud est indisponible. Dans la plupart des systèmes agricoles, ceux-ci incluent les alertes, les recommandations côté machine, les enregistrements de terrain hors ligne, les actions déclenchées par les capteurs et la confirmation des tâches par l'opérateur.
Étape 2. Définir ce qui fonctionne localement
Pour chaque flux de travail critique, précisez :
- entrées locales,
- traitement local,
- sortie locale,
- sortie de repli si le modèle est indisponible,
- ce qui doit être synchronisé ultérieurement.
Étape 3. Réduire la taille des payloads et la fréquence de synchronisation
N'envoyez pas de flux bruts lorsque des événements résumés suffisent. Envoyez des fonctionnalités, des indicateurs, des historiques compressés et des deltas de priorité lorsque c'est possible. Cela réduit la pression sur la bande passante et préserve l'autonomie de la batterie.
Étape 4. Concevoir la gestion des conflits avant le déploiement
La saisie hors ligne de données génère des événements de fusion. Deux opérateurs peuvent modifier la même tâche. Une machine peut terminer un travail avant que le plan cloud ne soit mis à jour. Le produit a besoin de règles claires en matière de priorité, de réconciliation et d'auditabilité.
Étape 5. Créer un état de synchronisation visible par l'opérateur
Les utilisateurs doivent savoir si une action est :
- enregistré localement,
- synchronisation en attente,
- synchronisé,
- rejeté,
- écrasé par une version plus récente.
Il ne s'agit pas seulement d'un détail technique. Cela affecte directement la confiance.
Étape 6. Benchmark dans des conditions rurales réalistes
Test sous :
- 4G faible,
- couverture intermittente,
- longues périodes hors ligne,
- contraintes de batterie,
- redémarrage de la passerelle,
- synchronisation d'horloge retardée,
- corruption partielle des données.
Cas d'usage : surveillance du gel et des maladies dans les vergers avec logique de décision locale
Contexte
This is an illustrative engineering case based on a realistic orchard deployment pattern rather than a published single-customer reference. It combines common requirements seen in fruit production: frost alerts, leaf wetness monitoring, local weather capture, disease-risk scoring, and delayed synchronisation to a central platform.
Scénario
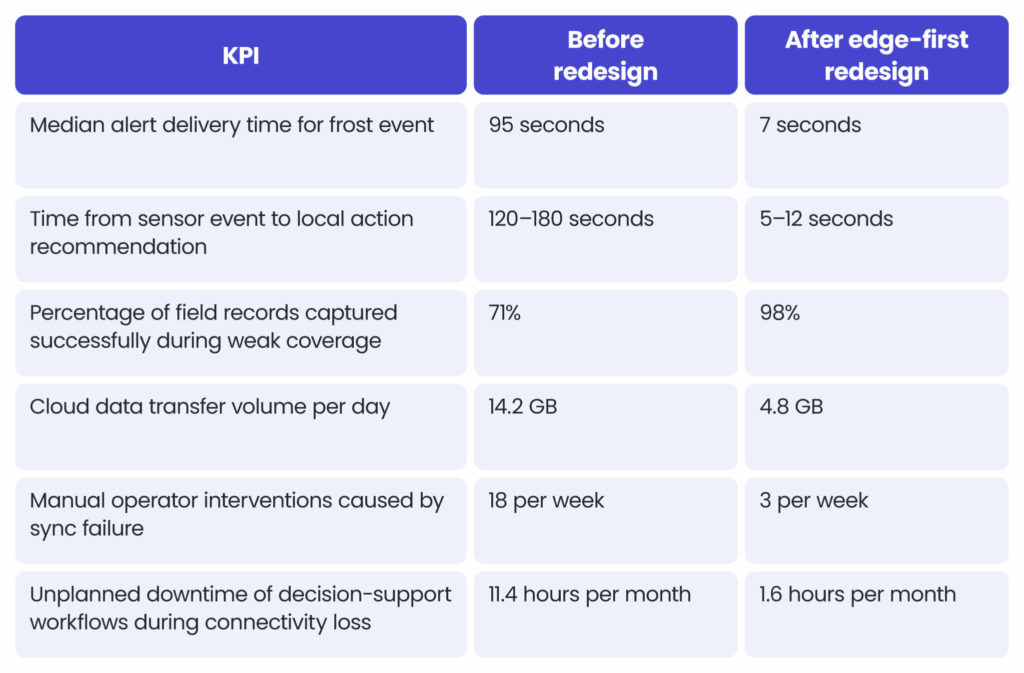
A 120-hectare orchard group operates across 9 separate blocks with mixed connectivity. The previous cloud-first setup relied on central processing for alerts and risk calculations. During spring nights, connectivity instability led to delayed alerts and incomplete field logs.
Indicateurs opérationnels cibles
Architecture utilisée
- passerelle locale par bloc de verger,
- moteur de règles local pour les seuils de gel et de maladie,
- modèle compact embarqué pour la notation d'événements,
- télémétrie mise en mémoire tampon avec transmission store-and-forward,
- cloud central uniquement pour l'analyse historique, les rapports saisonniers et les mises à jour de modèles.
Pourquoi les résultats se sont-ils améliorés ?
The main gain does not come from “better AI” alone. It comes from moving the decision path to the edge, reducing round-trip transmissions, and sending events instead of continuous raw traffic. This aligns with broader research on edge-enabled agriculture, which consistently reports latency and bandwidth as major constraints in cloud-dependent designs.
Note de référence
Ces chiffres doivent être considérés comme une référence de livraison représentative pour la planification d'architecture, et non comme un résultat universel. Les chiffres réels dépendent de la densité des capteurs, de la topographie, de la qualité du réseau, de la fréquence des événements et de la classe de l'appareil.
Erreurs courantes dans les systèmes et projets d'IA en périphérie de réseau dans l'agriculture
Sept erreurs qui ralentissent l'adoption :
- Traiter le mode hors ligne comme une fonctionnalité d'application mobile plutôt que comme une décision d'architecture – cela conduit généralement à une synchronisation défaillante, une capture partielle des données et un comportement incohérent.
- Transmettre par défaut les flux bruts des capteurs vers le cloud – une approche coûteuse, fragile et souvent inutile.
- Utiliser de grands modèles adaptés à la carte de démonstration mais pas à l'appareil de production – le matériel agricole présente des contraintes thermiques, énergétiques et de mémoire.
- Ignorer la dérive des horodatages et les problèmes d'ordonnancement – dans les systèmes de terrain distribués, la qualité du temps compte.
- Créer des alertes sans possibilité de clarification ou d'explication locale – les opérateurs doivent savoir pourquoi le système émet un avertissement.
- Mélanger la logique de sécurité avec les flux de travail métier généraux – ceux-ci ne devraient pas partager la même chaîne de dépendances.
- Omettre les tests en conditions réelles – un système testé uniquement sur un Wi-Fi de bureau stable n'est pas prêt pour la production dans le secteur agricole.
Liste de contrôle pour les équipes planifiant l'IA en périphérie dans l'agriculture
Liste de contrôle technique
- Identifiez les flux de travail critiques qui doivent fonctionner hors ligne
- Définir la frontière entre le calcul local et le cloud
- Sélectionnez des modèles légers prêts au déploiement
- Ajouter un stockage local avec une piste d'audit
- Concevoir une synchronisation idempotente et un comportement de nouvelle tentative
- Gérer la dérive d'horloge et les événements en double
- Exposer l'état de synchronisation aux opérateurs
- Créez des règles de repli lorsque le modèle est indisponible
- Évaluation comparative en conditions de signal faible
- Planifier la mise à jour à distance sécurisée et le retour arrière
Liste de contrôle produit
- Cartographier les états de défaillance du point de vue de l'utilisateur
- Définir quels écrans et workflows restent utilisables hors ligne
- Afficher clairement la fraîcheur des données et l'état de synchronisation
- Éviter de bloquer l'achèvement d'une tâche en raison d'une connexion manquante
- Établir la confiance grâce à un comportement local transparent
Comment Spyrosoft soutient le domaine de l'application de l'IA en périphérie dans les pratiques agricoles
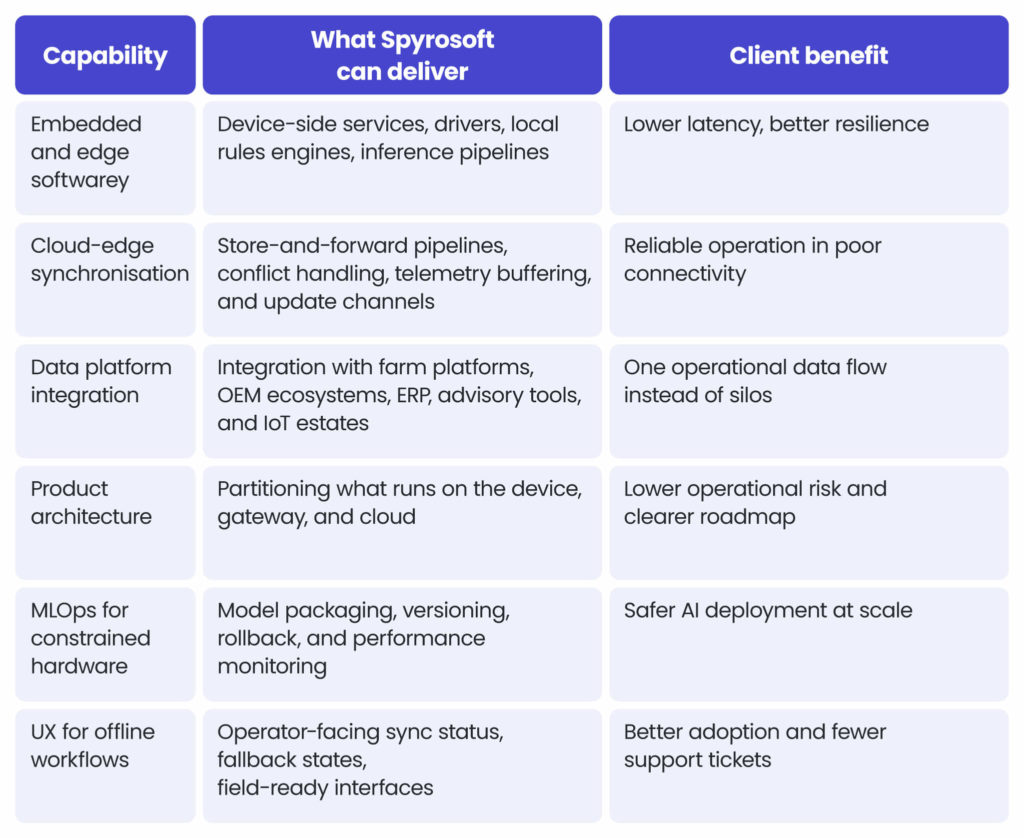
Spyrosoft peut soutenir l'IA en périphérie dans l'agriculture et l'agriculture intelligente au niveau où de nombreux programmes échouent : transformer des prototypes fragmentés en systèmes logiciels de qualité production.
Ce que ce support peut inclure
Synthèse de l'IA en périphérie dans l'agriculture
Edge AI in agriculture is not mainly about putting models on a device. It is about engineering systems that remain useful for precision agriculture when connectivity is weak, partial, delayed, or absent. That means local decision logic, deployment-ready models, durable local storage, resilient synchronisation, and clear product behaviour during failure states.
The market direction is clear. Rural connectivity is improving, but the quality gap remains material enough that agricultural software cannot assume stable cloud access as its operating baseline. Teams that build for intermittent connectivity will deliver more reliable products, stronger adoption, and better commercial outcomes than teams that continue to treat offline resilience as a secondary enhancement.
Si vous recherchez accompagnement dans la création de plateformes d'agriculture de précision et des solutions pensées pour la résilience hors ligne et la connectivité intermittente, contactez nos experts via le formulaire de contact ci-dessous.
Glossaire
Edge AI – Intelligence artificielle exécutée à proximité de la source de données, par exemple sur une machine, un automate, une passerelle ou un serveur local.
Priorité au mode hors ligne – Une approche de conception dans laquelle le flux de travail principal fonctionne sans connexion Internet active et se synchronise ultérieurement.
Stockage et transfert – Un modèle de communication où les données sont enregistrées localement et transmises lorsque la connectivité devient disponible.
Inférence locale – Exécuter un modèle entraîné sur un appareil local au lieu d'envoyer les données à un service cloud distant pour la prédiction.
Conflit de synchronisation – Une incohérence créée lorsque deux versions du même enregistrement sont modifiées indépendamment et doivent ensuite être rapprochées.
Latence – Le délai entre un événement et la réponse du système.
Quantification – Une méthode d'optimisation de modèle qui réduit la charge mémoire et de calcul en utilisant une représentation numérique à précision réduite.
Sources sélectionnées
OCDE, La connectivité numérique s'étend à travers l'OCDE, mais les zones rurales décrochent davantage, 10 juillet 2025.
Commission européenne, Décennie numérique 2025 : couverture haut débit en Europe 2024, 16 juin 2025.
Gong et al., Edge Computing-Enabled Smart Agriculture: Technical Architectures, Practical Evolution, and Bottleneck Breakthroughs, Sensors, 2025 ; et Tariq et al., cadre d'agriculture intelligente en périphérie de réseau, Results in Engineering, 2025.
FAQ
Non. C'est tout aussi pertinent pour les stations météorologiques, les modèles de maladies, les contrôleurs d'irrigation, les outils agronomiques portables, les applications agricoles mobiles, les passerelles locales, les unités télématiques et les systèmes de surveillance post-récolte.
Non. Le modèle le plus robuste est le cloud plus l'edge, avec une propriété claire des décisions, des données et de la synchronisation. Le cloud reste essentiel pour l'analyse de flotte, le réentraînement, le reporting et l'intégration.
Non. La couverture s'est améliorée, mais la qualité en zone rurale, la constance et les lacunes géographiques restent importantes. Même là où la couverture existe, la variation de latence, les trous de couverture et la mobilité des machines justifient encore une architecture offline-first.
Oui, au moment de la conception. Mais cette complexité est généralement moins coûteuse que l'instabilité opérationnelle, les déploiements échoués et la méfiance des utilisateurs après le déploiement.
Choisissez un flux de travail critique, déplacez son chemin de décision vers l'edge, mettez en œuvre un stockage local durable et ajoutez une synchronisation différée avec un statut opérateur clair.


arrow_circle_rightContactez-nous
Discutons de la manière dont nous pouvons vous aider avec vos projets agritech
arrow_circle_right Nos articles