Optimisation des performances de Qt Quick / QML : bonnes pratiques et erreurs à éviter


Un système n'est aussi solide que son élément le plus faible. Même si la majeure partie de la base de code est efficace, une seule fonction mal optimisée ou un algorithme inefficace peut tirer vers le bas les performances de l'ensemble du système. Ce goulot d'étranglement peut entraîner des temps de réponse lents, une consommation accrue de ressources et une expérience utilisateur dégradée. Les problèmes de performance se propagent souvent en cascade, où un composant lent affecte les autres, amplifiant le problème. Par conséquent, les développeurs doivent se concentrer sur l'optimisation de chaque partie du logiciel, en veillant à ce qu'aucun maillon faible ne puisse compromettre les performances et la réactivité du système.
Nous avons souvent tendance à surcompliquer les solutions. Dans la recherche de l'élégance, de la flexibilité ou de la richesse fonctionnelle, les développeurs peuvent introduire une complexité inutile – comme des architectures trop complexes, des abstractions excessives ou des composants lourds. Bien que ces solutions puissent paraître sophistiquées, elles peuvent entraîner une maintenance accrue du code, un débogage plus difficile et des performances plus lentes en raison des surcoûts ajoutés.
Des approches plus simples et plus directes sont souvent plus efficaces et plus faciles à maintenir, ce qui souligne la valeur de la clarté et de la simplicité dans le développement logiciel. C'est pourquoi je me rappelle constamment un bon vieil acronyme, KISS – keep it stupidly simple. C'est un principe fondamental que j'aimerais inculquer à tout développeur.
Mais qu'est-ce que la performance réellement ?
Par performance, j'entends l'efficacité et la rapidité avec lesquelles une application logicielle exécute des tâches, traite des données et répond aux saisies de l'utilisateur. Une performance élevée est essentielle pour offrir une expérience utilisateur fluide, en particulier dans les applications nécessitant un traitement en temps réel. Les techniques de rendu jouent un rôle important dans la performance, notamment dans les applications à forte intensité graphique. Un rendu efficace garantit que les images, les animations et les interfaces utilisateur sont affichées rapidement et de manière fluide, sans décalage ni retard. Optimiser la performance dans ce contexte implique de minimiser la charge de calcul, de réduire l'utilisation de la mémoire et d'utiliser des algorithmes efficaces capables de gérer des scènes et des interactions complexes sans compromettre la vitesse ni la qualité visuelle.
En infographie et en rendu, les primitives et le traitement par lots sont des concepts fondamentaux qui influent considérablement sur les performances. Les primitives désignent les formes ou éléments de base, tels que les points, les lignes et les triangles, utilisés pour construire des objets graphiques plus complexes. Le traitement par lots, quant à lui, est une technique consistant à regrouper plusieurs primitives et à les traiter en une seule opération plutôt qu'individuellement. Cela réduit le nombre d'appels de dessin au GPU, qui peut constituer un goulot d'étranglement des performances dans les pipelines de rendu.
La performance ne se mesure pas seulement par la vitesse et la réactivité, mais aussi par la consommation de mémoire. Une utilisation efficace de la mémoire est essentielle pour garantir le bon fonctionnement d'une application, en particulier sur les appareils aux ressources limitées. Une consommation de mémoire élevée peut entraîner une baisse des performances, car le système peut avoir besoin d'utiliser l'espace disque pour de la mémoire supplémentaire (via le swapping), ce qui est bien plus lent que la RAM. De plus, une utilisation excessive de la mémoire peut provoquer des plantages ou des ralentissements de l'application, surtout lorsqu'elle s'exécute en parallèle d'autres programmes.
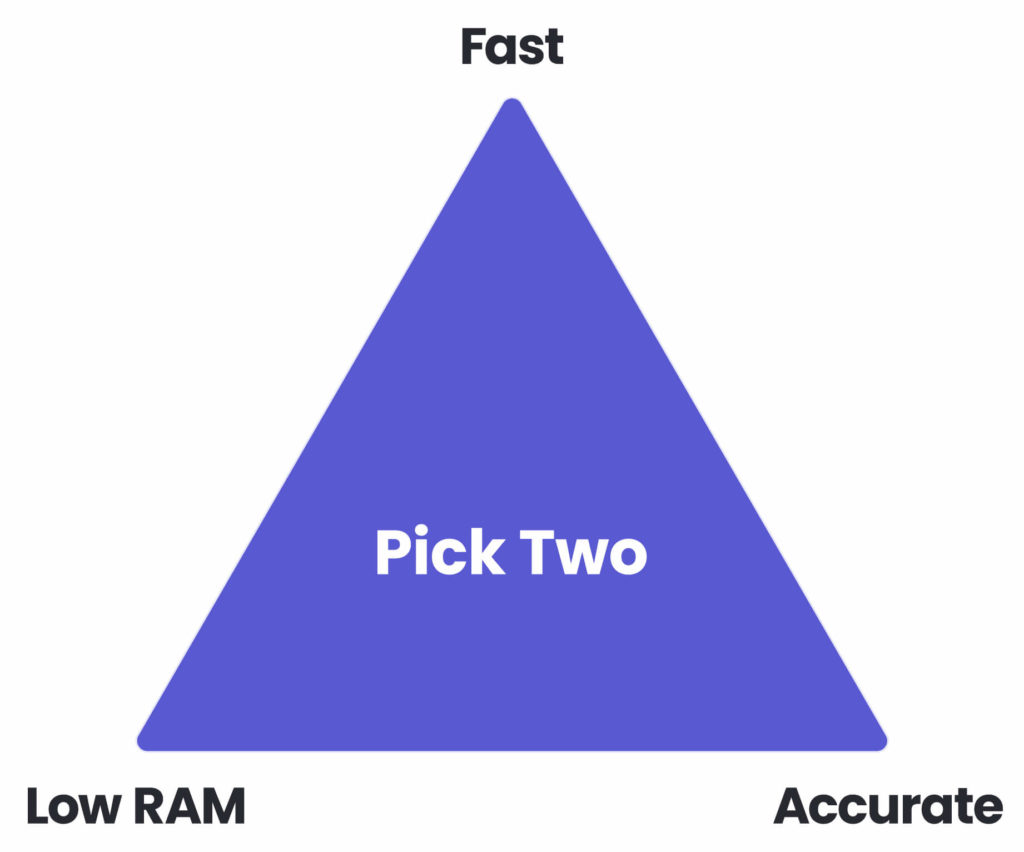
Il existe souvent un compromis entre la vitesse et la mémoire, où l'optimisation de l'un peut impacter l'autre. Par exemple, les algorithmes peuvent être conçus pour s'exécuter plus rapidement en utilisant davantage de mémoire pour stocker des données précalculées, mettre en cache les résultats ou employer des structures de données plus étendues. Cette approche réduit le besoin de calculs répétés, accélérant l'exécution mais augmentant la consommation de mémoire. À l'inverse, les développeurs peuvent réduire l'utilisation de la mémoire en utilisant des structures de données ou des algorithmes plus compacts, ce qui peut nécessiter des calculs supplémentaires, ralentissant ainsi le programme. L'équilibre de ce compromis est crucial dans le développement logiciel, car l'approche optimale dépend des exigences et contraintes spécifiques de l'application, telles que la capacité mémoire de la plateforme cible et les attentes en matière de performance.
Nous ne devons pas oublier que la performance est de plus en plus mesurée par la consommation d'énergie, le marché ayant reconnu le rôle critique de l'efficacité énergétique dans l'optimisation à la fois de la durabilité et de l'efficacité opérationnelle des applications, en particulier pour les appareils fonctionnant sur batterie.
Pièges de performance courants
Utilisation de solutions complexes
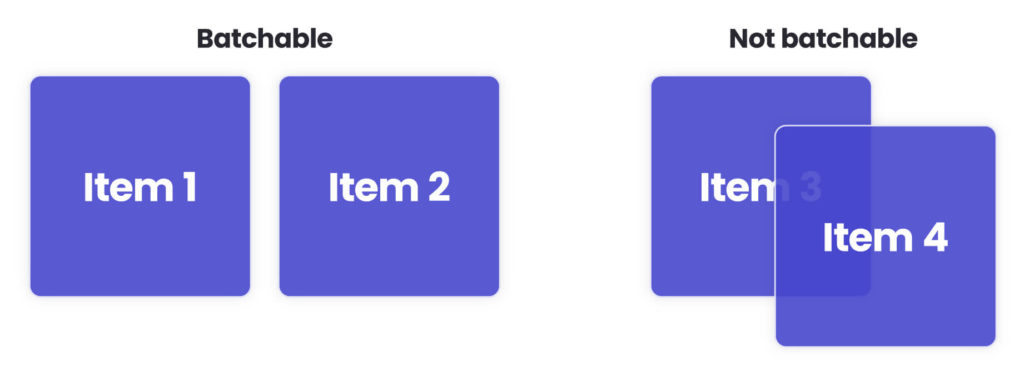
Les effets de shader sont généralement en cause ici : flou, opacité, masquage, colorisation, ombres. À chaque modification de notre scène, Qt Quick doit tout redessiner depuis le début, y compris les éléments qui sont restés identiques. Habituellement, nous devons identifier manuellement les parties de la scène qui pourraient et devraient être simplifiées.
Optimisation prématurée
L'optimisation prématurée consiste à se concentrer sur l'optimisation de certaines parties d'un système avant d'avoir une compréhension claire des véritables goulots d'étranglement en matière de performance. Cette approche conduit souvent à un gaspillage d'efforts et à une complexité accrue, car les développeurs peuvent consacrer du temps à améliorer des portions de code ayant peu d'impact sur la performance globale.
Ne pas utiliser de profileur
Plutôt que d'optimiser prématurément, il convient de s'appuyer sur le profilage et des données réelles, qui révèlent où se situent les inefficacités les plus importantes.
Pour l'analyse de la mémoire CPU et RAM du code QML / JavaScript, vous devez utiliser le profileur QML fourni avec Qt Creator. Il ne profile toutefois pas le code C++. Cependant, n'importe quel profileur polyvalent devrait suffire pour analyser le code C++ (par exemple Valgrind Callgrind).
Pour l'analyse GPU / moteur de rendu, vous pouvez définir des variables d'environnement spécifiques afin d'activer les statistiques de rendu Quick Scene Graph – que vous découvrirez plus loin dans cet article.
Liaisons excessives
Chaque liaison dans QML crée un contexte d'évaluation qui surveille les changements des propriétés dont elle dépend. Si votre application comporte un grand nombre de liaisons, en particulier sur des propriétés fréquemment modifiées, cela peut entraîner une surcharge importante.
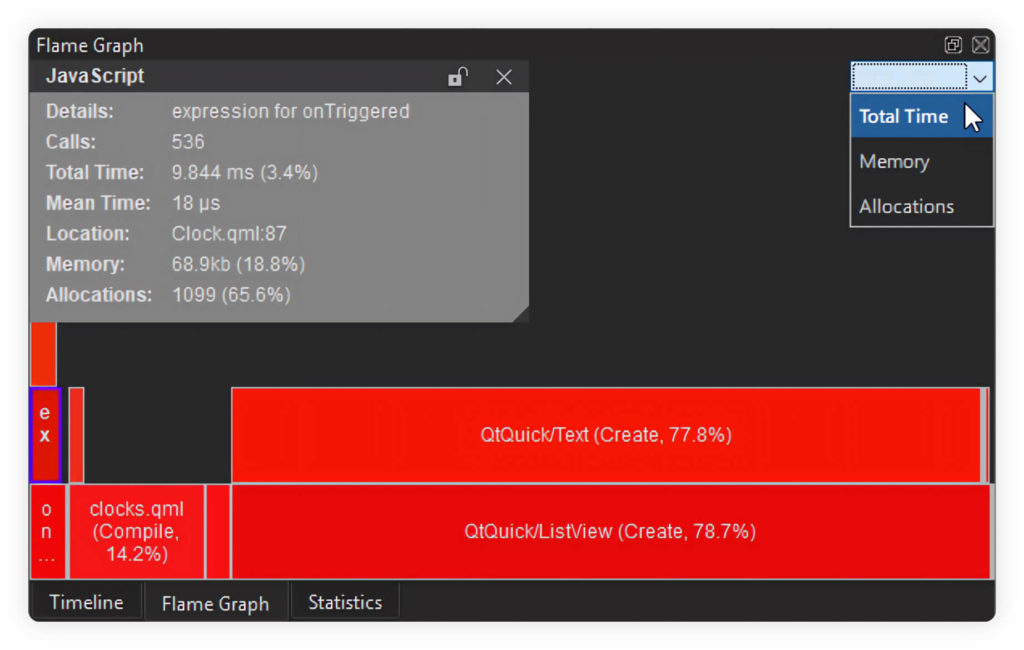
Les liaisons qui dépendent d'autres liaisons peuvent provoquer une réaction en chaîne où la modification d'une propriété déclenche des mises à jour sur de multiples liaisons. Cela peut entraîner des recalculs en cascade même lorsque la modification de la propriété sous-jacente n'affecte pas le résultat.
L'utilisation intensive de bindings dans des composants répétés de nombreuses fois (par exemple ListView) peut multiplier les coûts de performance. Chaque élément répété peut avoir son propre ensemble de bindings, ce qui entraîne un grand nombre d'évaluations simultanées. Déplacez les calculs complexes hors des bindings vers des fonctions ou des propriétés calculées uniquement lorsque cela est absolument nécessaire. Envisagez de définir directement les propriétés ou d'utiliser des bindings minimaux pour les propriétés critiques uniquement.
Surdessin
Le moyen le plus simple d'être plus rapide est de dessiner moins. Idéalement, nous souhaiterions que Qt Quick dessine tous les éléments visibles par l'utilisateur, et uniquement ceux-ci. Rappelez-vous que Qt Quick doit redessiner chaque élément dont la propriété visible est définie sur true. Vous devez masquer les éléments occultés – cela peut être fait de manière transparente avec des vues (par exemple StackView).
Fonctionne bien sur ordinateur de bureau, mais chute de fps sur système embarqué
Les appareils embarqués/mobiles disposent d'un sous-ensemble de l'accélération matérielle offerte par les ordinateurs de bureau. Pensez toujours à profiler et analyser le système sur l'appareil cible pour éviter les mauvaises surprises par la suite.
Ne pas comprendre le fonctionnement des moteurs de rendu
Qu'il s'agisse d'OpenGL, de Vulkan ou de Qt Quick Renderer – ne pas connaître le concept général du rendu par pipeline graphique se retournera tôt ou tard contre vous. Vous n'avez pas besoin d'être un expert en rendu, mais comprendre son fonctionnement sous le capot vous épargnera bien des maux de tête par la suite et vous permettra d'exploiter au maximum l'efficacité de la puce graphique.
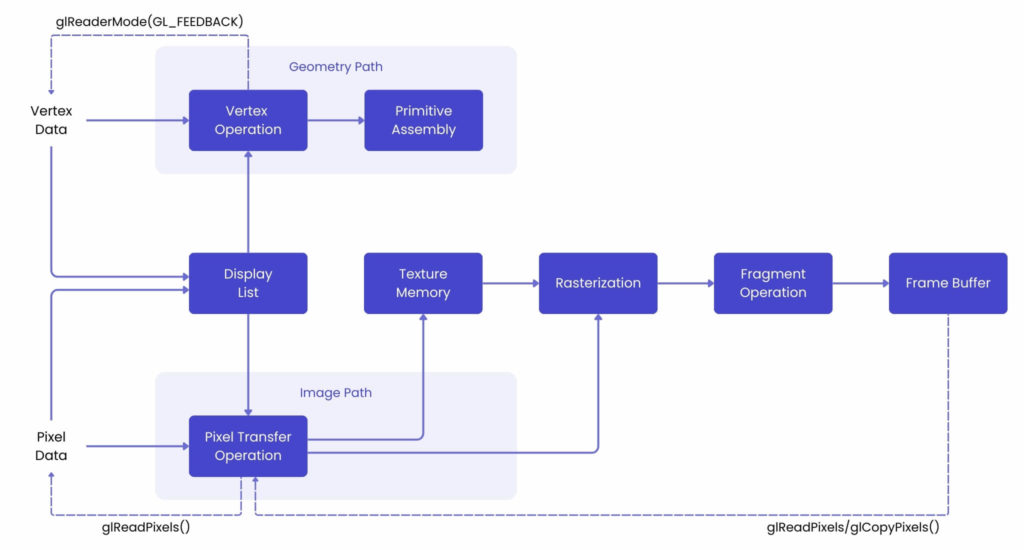
En règle générale, nous pouvons affirmer qu'un trop grand nombre de changements d'état dans un pipeline nuit à ses performances. Par changements d'état, nous entendons toute modification de textures, de tampons, d'opacité, de découpage, de shaders ou de cibles de rendu. Idéalement, visez à dessiner autant d'éléments que possible sans changements d'état.
Rappelez-vous : les GPU excellent dans le rendu d'un grand nombre de primitives en une seule fois.
C'est pourquoi l'utilisation d'un maximum de primitives est efficace.
Moteur de rendu Qt Quick
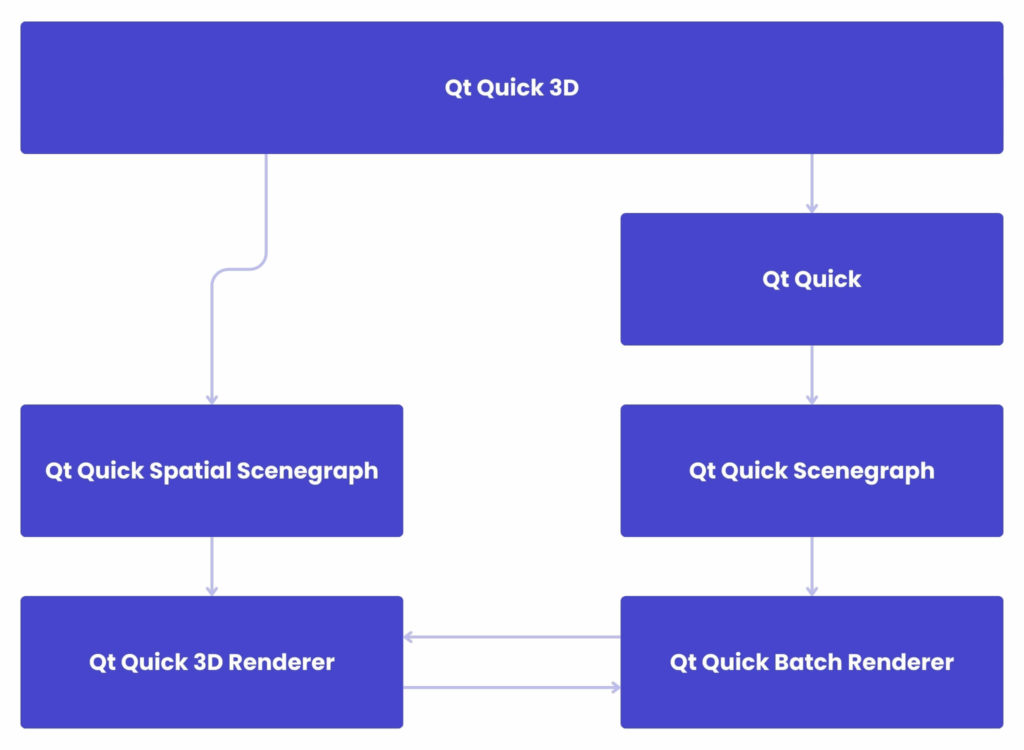
Graphe de scène
Le Scene Graph est la structure de données centrale utilisée par Qt Quick Renderer pour gérer et afficher les éléments visuels. Il organise les éléments QML dans une structure arborescente, où chaque nœud représente un élément visuel, tel qu'un rectangle ou une image. Il permet d'optimiser le rendu.
Traitement par lots
Le regroupement par lots (batching) rassemble plusieurs commandes de rendu en une seule opération afin de minimiser la charge du GPU. Toutes les commandes de rendu ne peuvent pas être regroupées – uniquement celles qui partagent le même état de pipeline. Imaginez que tout changement d'opacité, de shader, de texture, de clipping ou de cible de rendu entraîne un nouveau lot (ce qui dégrade les performances).
Le traitement par lots utilise également des techniques telles que les atlas de textures pour réduire le nombre de changements de texture, ce qui contribue à améliorer les performances. Les éléments Image et BorderImage y auront recours, sauf si l'image est trop grande.
De bonnes performances proviennent d'un traitement par lots efficace, avec le moins possible de géométrie téléchargée à plusieurs reprises.
Primitives opaques
Le moteur de rendu fait la distinction entre les primitives opaques et les primitives nécessitant un mélange alpha. En examinant l'état du matériau de chaque primitive, le moteur de rendu créera des lots opaques. L'ensemble des éléments de base de Qt Quick comprend des éléments rectangulaires aux couleurs opaques et des images entièrement opaques, telles que les JPEG ou les BMP (pas les PNG). Un autre avantage est que les primitives opaques ne nécessitent pas l'activation de GL_BLEND, ce qui peut être particulièrement coûteux, notamment sur les GPU mobiles et embarqués.
Débogage
En définissant la variable d'environnement QSG_RENDERER_DEBUG=render, le moteur de rendu affichera des statistiques sur l'efficacité du regroupement par lots, le nombre de lots utilisés, les lots conservés et ceux qui sont opaques ou non. Pour viser une performance optimale, les téléversements ne doivent avoir lieu que lorsque c'est réellement nécessaire, les lots doivent être inférieurs à 10, et au moins 3 à 4 d'entre eux doivent être opaques.
Définir QSG_VISUALIZE sur batches visualise les lots dans le moteur de rendu, clip dessine des zones rouges pour indiquer le découpage, changes visualise les modifications en faisant clignoter une superposition d'une couleur aléatoire, overdraw met en évidence les surdessins en 3D.
Vous souhaitez travailler en Qt/QML ?
Rejoignez-nous
Étude de cas
Une excellente étude de cas que je peux vous présenter concernant l'optimisation des performances QML est une tâche de projet que j'ai réalisée pour l'un de nos clients.
Les conceptions d'interface utilisateur du projet ont été réalisées dans Figma, un outil populaire pour créer, partager et tester des conceptions pour de nombreuses applications. Il offre de nombreuses propriétés avec lesquelles travailler. L'une d'entre elles concerne les effets d'ombre. Ces ombres portées ou internes se traduisent par la propriété CSS box-shadow.
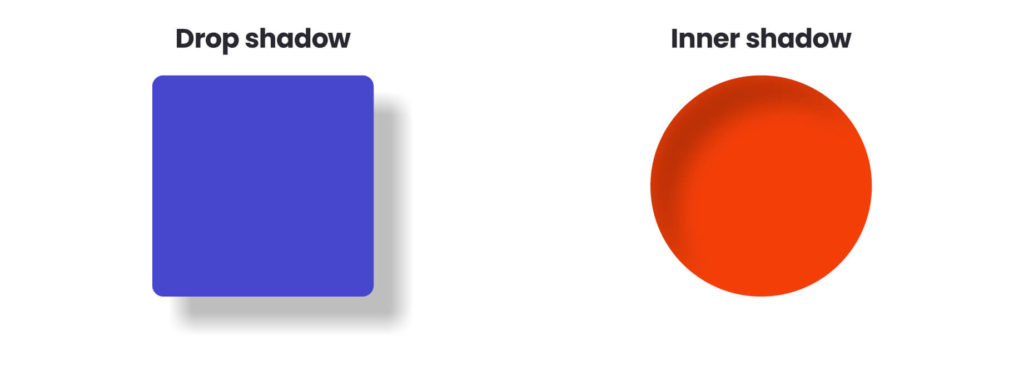
Nous devions obtenir le même effet en QML – et nous l'avons fait.
Notre première approche consistait à utiliser le composant DropShadow du module Qt's Graphical Effects. Le résultat visuel était excellent, mais l'impact sur les performances de l'appareil embarqué cible était considérable.
Comme seconde approche, nous avons essayé un shader sur mesure. Il produisait un très bel effet, avec un impact acceptable sur les performances. Mais à mesure que le système grandissait, de plus en plus d'éléments utilisaient ce shader, rendant l'impact sur les performances de moins en moins acceptable.
Un élément utilisant un calque/un shader ne peut pas être regroupé lors du rendu. Et c'était la cause de notre goulot d'étranglement. J'ai décidé que nous devions échanger une précision univoque avec Figma contre une solution suffisamment bonne mais rapide et économe en mémoire.
Comme j'avais de l'expérience en développement de jeux, je connaissais bien le concept de mise à l'échelle en 9 tranches.
Il s'agit d'une technique permettant de créer des images évolutives qui peuvent être redimensionnées sans déformer les parties importantes de l'image (les coins). Heureusement, Qt Quick fournit le composant BorderImage qui met en œuvre cette technique.
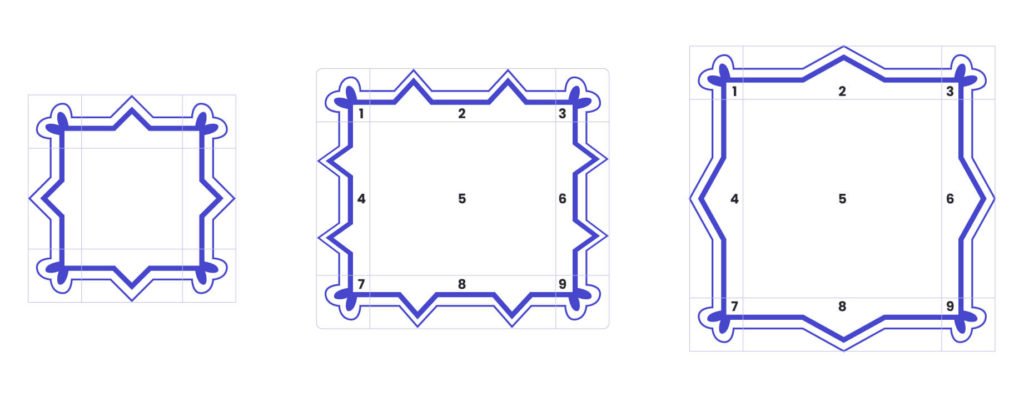
J'ai effectivement demandé des images 9-slice d'ombres pré-rendues à nos designers, ce qui n'a pas été une grande contrainte pour eux, car Adobe Photoshop (et bien d'autres outils) propose des plugins d'édition 9-slice pour créer facilement de tels éléments.
J'ai rapidement remplacé l'approche par shader par une image de bordure dans notre implémentation d'ombre de boîte et un miracle s'est produit : les fps ont triplé, passant de 20 fps à 60 fps. Même la consommation de mémoire a été réduite de moitié, passant de 1200 Mo à 600 Mo. Étant donné que chaque élément utilisant une ombre était rendu dans une couche/un tampon séparé, l'empreinte mémoire d'une telle implémentation était assez énorme.
Bien sûr, l'approche par image de bordure était un compromis sur la précision. Mais il n'était pas surprenant que tout le monde ait remarqué des performances bien meilleures. La dégradation de la qualité visuelle de l'effet d'ombre était, en fait, négligeable, surtout comparée au gain de performance que nous avons obtenu.
Souvent, le mieux est l'ennemi du bien.
Résumé
Il n'existe pas de remède unique aux problèmes de performance. Chaque application et chaque scénario est différent, nécessitant des approches d'optimisation sur mesure.
La simplicité conduit à de meilleures performances, une maintenance plus facile et moins de bugs – mais elle découle de l'expérience et de l'expertise.
L'expérience joue un rôle essentiel dans la prise de ces décisions – les développeurs chevronnés savent identifier les pièges potentiels, choisir les bons outils et équilibrer efficacement les compromis, garantissant ainsi que la solution n'est pas seulement fonctionnelle mais aussi efficace et maintenable.


arrow_circle_rightContactez-nous
Besoin d'aide pour une application basée sur Qt ? Notre équipe est prête à vous aider
Przemyslaw Krzywania
Directeur HMI
arrow_circle_right Nos articles


