Choisir la meilleure base de données temporelle pour vos besoins IoT – une comparaison


Les données de séries temporelles sont au cœur de nombreux agrégation de données. Devices generate readings in near real-time, producing large volumes of timestamped data that must be stored efficiently, ingested quickly, and retrieved easily for analysis. While traditional relational databases can store time-series data, they are not always optimised for the unique access patterns required – such as time-based aggregations or rapid ingestion with minimal delays. So, in this article, I will focus on choosing the best time-series database for specific needs.
Ci-dessous, je vais comparer quatre solutions populaires pour le stockage et l'analyse de séries temporelles :
- TimescaleDB – Une extension au-dessus de PostgreSQL, offrant des optimisations pour les séries temporelles tout en conservant la familiarité du SQL.
- InfluxDB (v3) – Une base de données temporelle spécialement conçue, reconnue pour son ingestion à haut débit et son écosystème riche.
- Azure Data Explorer (ADX) – Un service d'analyse rapide et cloud-native de Microsoft Azure, optimisé pour les données de logs et de télémétrie.
- automatiser les tâches – Un service de base de données de séries temporelles entièrement géré par AWS, conçu pour évoluer avec une charge opérationnelle minimale.
Bien que TimescaleDB et InfluxDB proposent également des offres cloud, aux fins du présent article, je me concentrerai sur leur disponibilité en tant que solutions de séries temporelles sur site.
At Spyrosoft, we always consider these options at the beginning of a new IoT project, based on the specific requirements. The goal of this article is to compare these solutions for IoT data storage and analytics. To be clear, there is no single “golden rule” or universal best choice when selecting a time-series database. However, I will present the key considerations you should keep in mind when choosing a time-series solution, by providing a comparative overview.
Commençons !
Organisation des données dans une base de données de séries temporelles
Une organisation efficace des données est essentielle à la performance et à l'optimisation des meilleures bases de données temporelles. Des solutions telles que InfluxDB, TimescaleDB, Amazon Timestream, et Azure Data Explorer chacun peut employer des schémas distincts pour structurer et stocker efficacement les données de séries temporelles.
InfluxDB Clustered
InfluxDB vous permet de stocker des données dans un emplacement nommé appelébase de données (désigné sous le nom decatégories dans InfluxDB TSM), qui regroupe les données logiquement en tables (connu sous le nom demesures dans InfluxDB TSM). Chaque table contient tags et champs:
- Tags sont des paires clé-valeur qui fournissent des métadonnées pour chaque point – des exemples incluent des identifiants tels que la station, l'ID du capteur ou la localisation. Les valeurs des tags peuvent être nulles.
- Champs sont des paires clé-valeur représentant des valeurs qui évoluent dans le temps – par exemple la température ou la pression. Les valeurs de champ peuvent être nulles, mais au moins une valeur de champ doit être non nulle dans toute ligne donnée.
A horodatage (which is never null) is associated with each data point, and all data is ordered by time. The term “point” refers to a single data record identified by its measurement, tag keys, tag values, field key, and timestamp. All points in a given table should share the same tags. The columns that uniquely identify each row in a table form the clé primaire. Les lignes sont identifiées de manière unique par leur horodatage et leur ensemble de balises non nulles.
Lorsque vous écrivez des données dans InfluxDB, les données elles-mêmes définissent le schéma. Il n'est pas nécessaire de créer explicitement des tables ou de définir un schéma au préalable.
TimescaleDB
TimescaleDB est construit sur PostgreSQL et distribué sous forme d'extension PostgreSQL, conservant une prise en charge complète de SQL. La solution organise les données de séries temporelles enhypertables, qui sont essentiellement des tables PostgreSQL partitionnées par le temps. La base de données gère automatiquement ces partitions en arrière-plan. Une hypertable est constituée de tables plus petites appelées segments, chacun se voyant attribuer une plage temporelle pour ne stocker que les données de cet intervalle. Le taille de bloc configures itself during the hypertable creation, so it should be carefully planned, as it affects insert and query performance. By default, a newly created hypertable indexes by time in descending order. Hypertables can coexist with standard PostgreSQL tables, which can be advantageous in certain scenarios.
Timestream
Choisir le bon modèle de facturationbases de données qui contiennent tables, similaire à la structure d'InfluxDB. Chaque table contient unséries temporelles, qui est une séquence d'un ou plusieurs points de données (enregistrements) capturés sur un intervalle de temps. Un point de données unique dans la série temporelle est appelé unenregistrement.
Un attribut décrivant les métadonnées d'une série temporelle est appelé undimension, et il se compose d'un nom et d'une valeur (par exemple, « device_id » et « 12345 »). Un mesurer est une valeur suivie par l'enregistrement, identifiée par un nom de mesure et une valeur de mesure (par exemple, « température » et « 45 »). Un horodatage indique quand la mesure a été collectée, avec une granularité à la nanoseconde.
Azure Data Explorer
Le conteneur de niveau supérieur dans Azure Data Explorer est une base de données, qui contient tables. Chaque table stocke les données dansétendues (data shards). An extent is a table’s horizontal segment containing data and metadata, such as its creation time and optional tags. All extents together form the table. They are also evenly distributed across cluster nodes and cached in both local SSDs and memory for optimal performance. Essentially, they are immutable, and each extent physically stores records in columns.
Interroger les données avec les meilleures bases de données temporelles
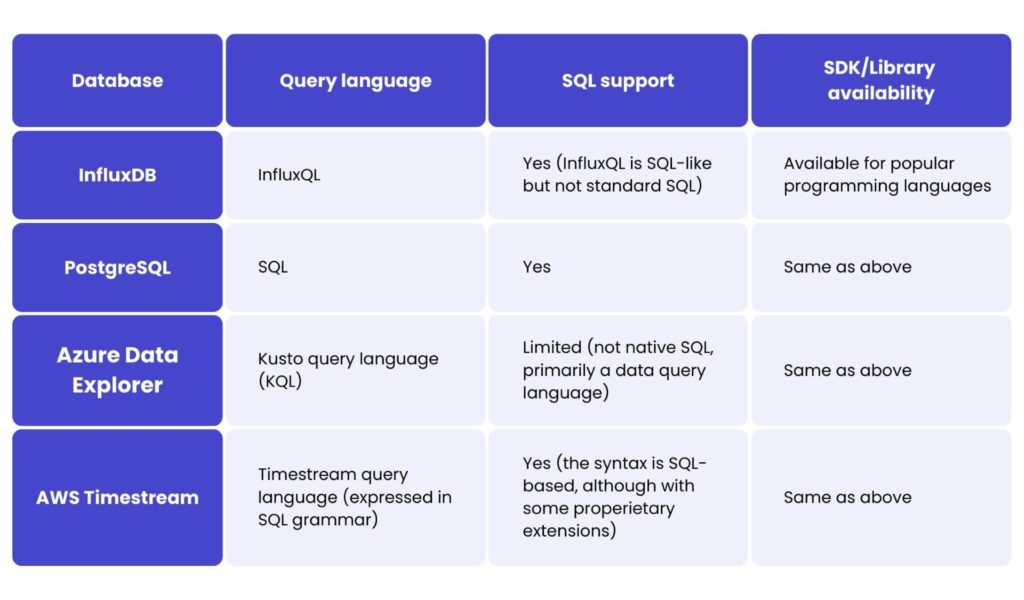
Surveillance des données en temps réel et notifications
Les stratégies d'ingestion varient considérablement d'une base de données de séries temporelles à l'autre, reflétant les besoins divers des applications IoT.
- InfluxDB prend en charge les écritures à haut débit via son protocole line via HTTP, ainsi que les intégrations avec des outils comme Telegraf (un agent basé sur serveur qui peut collecter et envoyer des métriques et des événements depuis des capteurs IoT) pour l'import en streaming et par lots.
- TimescaleDB, étant une extension PostgreSQL, s'appuie sur les insertions SQL standard, les opérations groupées timescaledb-parallel-copy pour l'importation de données, par exemple à partir de fichiers CSV, et des connecteurs externes.
- automatiser les tâches fournit des intégrations natives avec AWS IoT Core et les flux de données Kinesis, tout en proposant également une approche pilotée par SDK.
- Azure Data Explorer (ADX) peut ingérer des données depuis Event Hubs, IoT Hub ou des points de terminaison HTTP directs, en regroupant et gérant automatiquement les fragments de données.
Meilleure base de données temporelle : options d'hébergement
Chacune de ces bases de données temporelles offre différentes options d'hébergement, ce qui peut influencer le coût, l'évolutivité et la complexité opérationnelle.
InfluxDB
There are many ways to implement InfluxDB into IoT solutions: as a self-hosted on-premises instance, in a private cloud, or using InfluxDB Cloud, a fully managed SaaS offering. The self-hosted version provides complete control over infrastructure but requires operational management. For this article, we focus on InfluxDB hosted on-premises. You can deploy a single instance of InfluxDB, or utilise InfluxDB Clustered, designed with high availability and scalability in mind. Deploying InfluxDB Clustered on Kubernetes requires additional resources, such as persistent storage for underlying Parquet files that must be compatible with AWS S3 or S3-compatible object storage, and an external PostgreSQL (or PostgreSQL compatible) instance for metadata and coordination. It is also advisable to use a load balancer to efficiently distribute queries and ingestion requests across cluster nodes.
TimescaleDB
TimescaleDB is available as a self-managed PostgreSQL extension, making it deployable on any infrastructure where PostgreSQL runs. Additionally, TimescaleDB offers Timescale cloud, a managed service for hosting and scaling time-series databases with minimal operational overhead.
automatiser les tâches
AWS Timestream is a fully managed, cloud-native service that is exclusively available within the AWS ecosystem. It eliminates the need for infrastructure management but requires AWS integration and follows a cloud-based pricing model. At the time of writing this article, AWS Timestream employs a pay-as-you-go pricing structure, with costs determined by data ingestion, storage, and query processing. For the most up-to-date pricing details, you should refer to the official AWS Timestream pricing page. Pricing should be assessed based on specific project requirements, as costs may vary depending on usage patterns and data retention needs.
Azure Data Explorer
ADX is a cloud-native service that runs on Microsoft Azure, offering a managed environment with built-in scalability. While it is optimised for Azure workloads, it can also integrate with hybrid and multi-cloud architectures through various ingestion methods. Azure Data Explorer provides multiple service tiers, including a Dev/Test cluster, which is designed for development and testing with a single node and no redundancy, and a Production cluster, which includes at least two nodes for high availability and operates under an Azure Data Explorer SLA. You should select an appropriate tier based on your workload requirements and cost considerations.
La meilleure base de données de séries temporelles est… ou peut-être pas ?
Eh bien, cela dépend ! Il n'existe pas de choix unique et parfait qui convienne à tous les cas d'usage. Cependant, voici une ligne directrice approximative pour déterminer quand chaque base de données peut être la meilleure option :
- Si vous avez besoin d'un hébergement sur site – envisagez InfluxDB ou TimescaleDB.
- Si votre équipe maîtrise déjà SQL et préfère PostgreSQL – TimescaleDB pourrait être la solution la plus adaptée.
- Si vous avez besoin d'une solution entièrement gérée et cloud-native sur AWS – AWS Timestream est un choix naturel.
- Si votre infrastructure est basée sur Azure et que vous avez besoin d'une intégration transparente avec d'autres ressources Azure, telles que Data Lake et Power BI – Azure Data Explorer mérite d'être envisagé.
- Si des taux d'ingestion élevés et des analyses en temps réel sont critiques – InfluxDB ou Azure Data Explorer pourrait être votre meilleure option.
Of course, these are just starting points, and the best approach is always to conduct a proof of concept (PoC) and load tests tailored to your specific project. After all, picking a database is a bit like picking a favourite pizza topping – what works for one team may not be the best for another.
Défis courants et comment les surmonter
En savoir plus
Conclusions sur le choix de la meilleure base de données temporelle
There is no single “golden rule” for choosing the best time-series database for an IoT project. Each presented solution has its strengths and trade-offs, and the best option depends on the project’s specific requirements, such as scalability, ease of querying, and data acquisition performance. Nevertheless, you should definitely consider the factors outlined in this post when making a decision.
The good news is that deploying these databases is relatively straightforward, making it easy to conduct a proof of concept (PoC) that evaluates their performance in a real-world scenario. Once a PoC is in place, artificial load testing can help estimate how well a database handles expected workloads, ensuring the right choice before committing to a production system.
In my current project, we have followed this approach from the beginning. When we gathered telemetry requirements from the customer, we initially conducted a PoC with both Azure Data Explorer (ADX) and PostgreSQL. Given that the customer already had an existing Azure infrastructure and additional requirements – such as integration with other resources like Data Lake and Power BI – ADX emerged as the best fit for our scenario. It provided the necessary scalability almost immediately, with seamless integration into services like IoT Hub and Blob Storage.
Another important consideration was data migration from different sources. The ability to include external tables – such as sources stored in CSV files within Blob Storage – was also a significant advantage for our project’s needs. However, this does not mean that Azure Data Explorer is the best choice for every project. It was simply the most suitable option for us, considering our specific requirements.
Of course, it wasn’t all smooth sailing from the start. We had to refine our ingestion approach, configure data aggregation, manage data latency, and carefully consider data retention and continuous export strategies. Additionally, cost efficiency was a bit tricky – pricing for ADX isn’t always straightforward and requires careful analysis. But handling ADX and making it work efficiently is probably a topic worthy of its own post (and maybe even a few deep sighs in the process).
Accédez à la meilleure base de données de séries temporelles avec Spyrosoft
Choosing the best time-series database for your IoT project is no easy task, but hopefully, this comparison has given you some valuable insights to guide your decision. Whether you’re looking for seamless cloud integration, SQL familiarity, or high-throughput ingestion, each database has something unique to offer.
Si vous avez besoin de plus d'expertise IoT ouun accompagnement pratique dans le développement de votre projet IoT, contactez-nous via le formulaire ci-dessous et découvrez ce que nous pouvons accomplir ensemble.
FAQ
A time-series database is designed to store data points collected over time, often at high frequency. Unlike relational databases, which focus on structured, relational datasets, time-series systems optimise for fast ingestion, efficient compression, and smooth querying of sequential data. This makes them much better suited for IoT scenarios where devices generate continuous streams of measurements.
Focus on ingestion speed, storage efficiency, query performance, and how well the database scales as data volumes grow. It also helps to consider ease of integration with your existing infrastructure and whether the system supports features such as downsampling or retention policies. The best time-series database for your project will match both your current load and your future growth.
IoT environments rarely stay static. Device numbers increase, sampling frequencies change, and new use cases appear. A database that scales without disruption allows you to maintain consistent performance and predictable costs as your environment expands. Without this, even well-designed systems can become slow or unstable.
Many open-source solutions provide strong foundations, large communities, and stable features. Their transparency also makes them easy to audit and customise. However, industrial projects may need additional safeguards, such as defined SLAs, enterprise support, or certified integrations. It often comes down to your internal capabilities and long-term maintenance plans.
Data retention policies determine how long you keep raw and processed data. A suitable policy helps you control storage costs without losing valuable insights. Some databases automate retention and downsampling, which is useful when handling long-term trends without storing unnecessary detail.
Slow queries can reduce the value of real-time monitoring. A database built for time-series workloads will handle aggregations, filtering, and window functions more smoothly. This gives engineers faster access to insights, supports alerting, and helps detect anomalies before they become costly issues.
Yes. Many organisations use a hybrid approach. For example, a time-series database might store high-frequency sensor data, while a relational or document database manages metadata, reports, or business logic. The important part is to design data flows that remain stable and clear as the system evolves.
You can rely on vendor resources, community documentation, or external consultancy. According to Spyrosoft, organisations benefit from having a partner who understands both the technical landscape and the practical demands of large-scale IoT platforms. Guidance of this kind can help you choose a solution that fits your long-term strategy.
arrow_circle_rightnous contacter
Découvrez comment nous pouvons optimiser vos solutions IoT

arrow_circle_right Autres articles


